فهرست مطالب
Exa Agent Ultra بالاترین سطح تلاش (effort) برای Exa Agent است؛ حالتی که Exa برای تحقیق عمیق، ساخت فهرستهای بلند، و غنیسازی موجودیتها (مثل شرکت یا فرد با چند فیلد و منبع) طراحی کرده. خبر رسمی در ۲۵ سپتامبر ۲۰۲۶ در بلاگ Exa آمد. در مستندات فعلی، مقدار effort همین حالت ultra است (مصرفمحور، با سقف پیشفرض حدود ۲۰ دلار برای هر اجرا) — نه مقدار قدیمیتر max که در بعضی متنهای کهنه دیده میشود.
اگر تا امروز فقط یک جستجوی وب یا یک پاسخ کوتاه از مدل گرفتهاید، Ultra را مثل «تیم تحقیقاتی خودکار» ببینید: کار را خرد میکند، چند مسیر را همزمان میرود، صفحه میخواند، کاندیدا را با معیار شما چک میکند و در نهایت متن یا JSON ساختیافته برمیگرداند. در ادامه ساده میگوییم Exa Agent چیست، Ultra چه فرقی با سطوح پایینتر دارد، قیمت و محدودیتها چیست، و برای چه کسی واقعاً بهدرد میخورد.
زمینه کوتاه: جستجوی ساده با ایجنت تحقیق چه فرقی دارد؟
جستجوی معمولی معمولاً یک درخواست میفرستید و چند نتیجه یا یک خلاصه میگیرید. خودتان باید حلقهٔ «جستجو ← خواندن صفحه ← فیلتر ← دوباره جستجو» را بچرخانید.
Exa Agent همان حلقه را برای شما هماهنگ میکند: چند زاویه جستجو میزند، محتوا را فشرده میکند، برای ساخت فهرست کار را بین زیرکارها تقسیم میکند، و اگر schema بدهید خروجی را به JSON معتبر نزدیک میکند. طبق مستندات، این اندپوینت عمداً غیرهمزمان (async) و سنگینتر از Search ساده است؛ برای یک lookup سریع همان Search API مناسبتر است.
خبر ۲۵ سپتامبر ۲۰۲۶ چه بود؟
Exa نوشت Agent Ultra را بهعنوان بالاترین سطح تلاش Agent منتشر کرده و آن را برای سختترین تحقیقها ساخته: جایی که کاملبودن و دقت مهمتر از سرعت و هزینهٔ کم است. در همان پست، شرکت چند بنچمارک داخلی/خوداجرا را هم با مدلهای مرزی و Perplexity Agent مقایسه کرده است — آن اعداد را پایینتر با احتیاط میخوانیم، نه بهعنوان حقیقت مستقل.
پیام عملی خبر: اگر قبلاً با effortهایی مثل medium یا high کار میکردید و هنوز فهرست ناقص یا فیلدهای تأییدنشده میگرفتید، Ultra همان محصول است با سقف محاسباتی بالاتر و زمان اجرای طولانیتر.
Exa Agent Ultra دقیقاً چه کار میکند؟
طبق بلاگ و مستندات، Ultra برای این سه خانواده کار است:
تحقیق عمیق: یک موضوع را تا جایی که منابع اجازه بدهد دنبال میکند و با استناد جمع میبندد.
ساخت فهرست (list-building): مثلاً «همهٔ شرکتهای اروپایی بازیافت باتری» با بنیانگذار، سرمایه و مشتری.
غنیسازی موجودیت: روی ردیفهایی که دارید فیلدهای جدید با شواهد URL اضافه میکند؛ یا با exclusion، موارد تکراری را از دور بعد حذف میکند.
خروجی یک اجرا میتواند متن طبیعی، JSON مطابق schema، grounding در سطح فیلد، متادیتا و شکست هزینه باشد. میتوانید اجرا را بعداً بخوانید، رویدادها را پخش کنید، یا با previousRunId ادامه بدهید (مگر در حالت Zero Data Retention که محدودیت خودش را دارد).
جدول سطوح effort در Exa Agent
مقادیر و قیمتها طبق مستندات و صفحهٔ قیمتگذاری فعلی Exa (API). اعداد ممکن است عوض شوند؛ قبل از هزینهٔ سنگین داشبورد را چک کنید:
effort | مدل قیمت | بهترین کاربرد تقریبی |
|---|---|---|
minimal | ثابت حدود ۰٫۰۱۲ دلار / درخواست | lookup خیلی باریک و ارزان |
low | ثابت حدود ۰٫۰۲۵ دلار | واقعیتهای محدود، پاسخ کوتاه |
medium | ثابت حدود ۰٫۱۰ دلار | شروع پیشنهادی برای تحقیق استاندارد روی یک موجودیت |
high | ثابت حدود ۰٫۵۰ دلار | تحقیق سختتر، استناد بیشتر |
xhigh | ثابت حدود ۱٫۰۰ دلار | کاملبودن مهمتر از هزینه در حالت ثابت |
auto | مصرفمحور؛ سقف پیشفرض ۵ دلار | وقتی اندازهٔ کار از قبل معلوم نیست (مثل لیست متغیر) |
ultra | مصرفمحور؛ سقف پیشفرض ۲۰ دلار | فهرست بزرگ، معیار سختتأیید، تحقیق تا حد ممکن کامل |
اجزای مصرف در حالتهای metered: هر ACU (واحد محاسبهٔ ایجنت) ۰٫۱۰ دلار، هر فراخوانی ابزار جستجو ۰٫۰۰۵ دلار؛ غنیسازی ایمیل و تلفن جداگانه قیمت دارد. با budget.maxCostDollars میتوانید برای auto/ultra سقف ۱ تا ۱۰۰ دلار بگذارید.
کاربردهای عملی که خود Exa مثال زده
تیمهای مدل و داده: جمعکردن مقاله و ریپو برای یک تکنیک؛ چک کردن اینکه آیا eval reproducible یا وزن عمومی منتشر شده.
خدمات مالی: نقشهٔ بازار برای diligence؛ KYC از پرونده، خبر، دادگاه و سایت رگولاتور با یک رکورد استناددار.
فروش و GTM: فهرست حساب (مثلاً شرکتهای ابزار automation مرورگر در آمریکا) و غنیسازی فیلدهایی که قضاوت میخواهند — مثل «آیا به بیمارستان میفروشد؟» با URL شاهد.
برای کسانی که ایجنت کدنویسی را تریس میکنند و بعد مدل را تنظیم میکنند، مسیر دادهٔ جداگانهای مثل LangSmith Fine-Tuning است؛ Ultra بیشتر «جمعکردن زمینه از وب» است تا fine-tuning. اگر اجرای ابزار را در محیط ابری ایزوله میخواهید، Docker Cloud Sandboxes مکمل خوبی برای سمت runtime است.
بنچمارکهای اعلامشده Exa — با احتیاط بخوانید
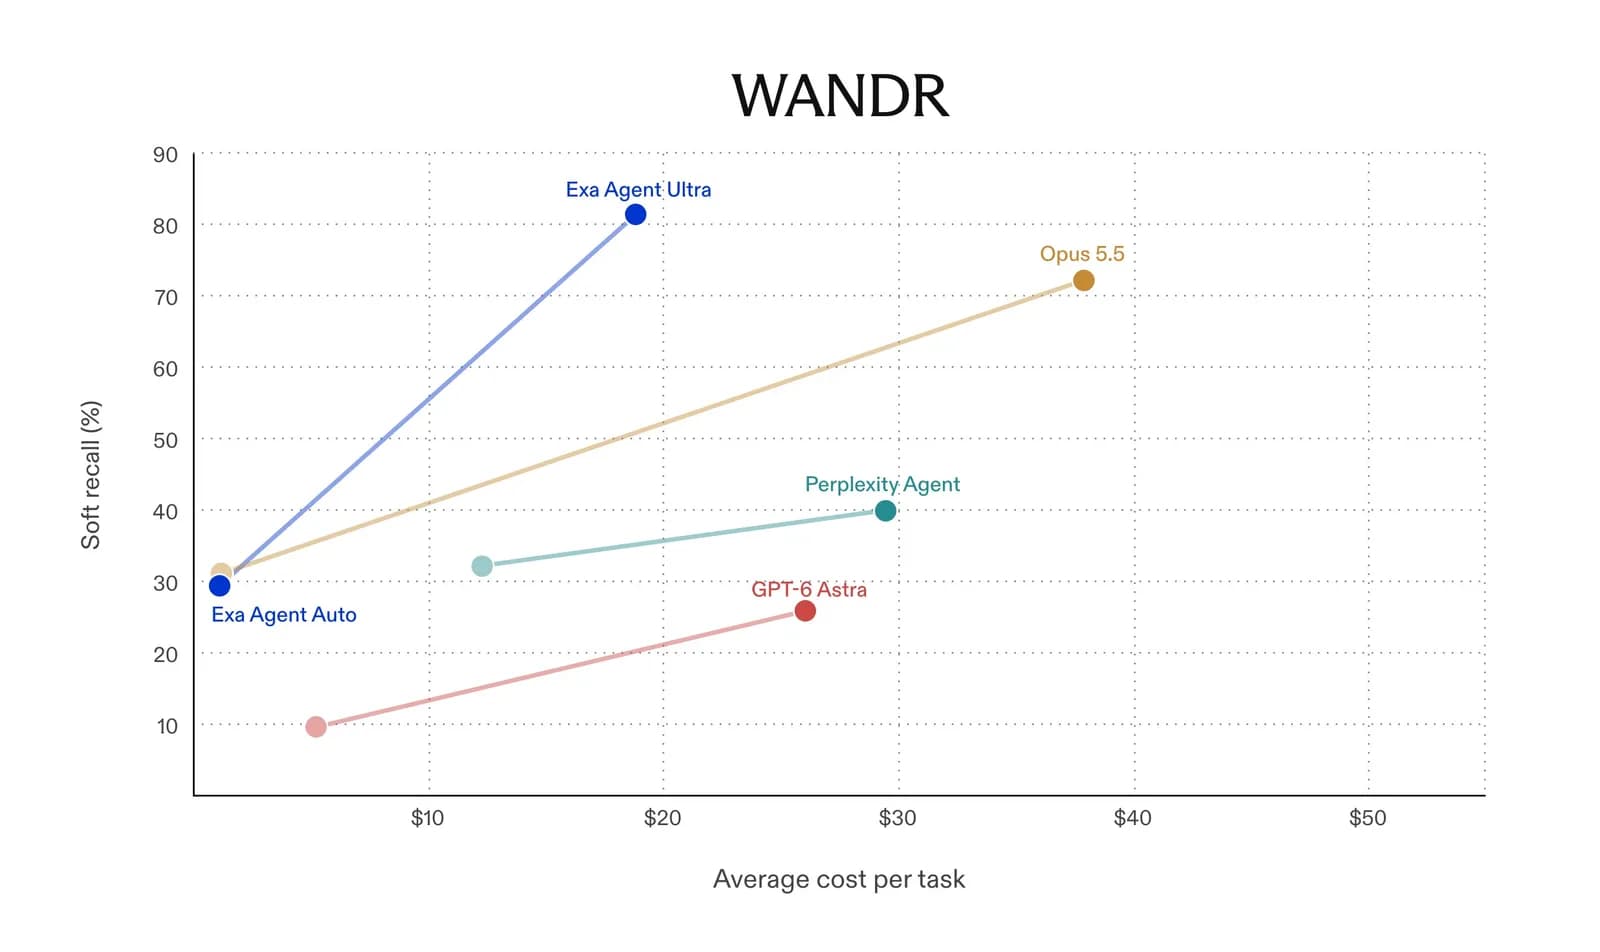
در پست Ultra، Exa چند عدد روی WANDR، DeepSearchQA، WideSearch و Find-All Company در برابر Opus 5.5، GPT-6 Astra و Perplexity Agent (حداکثر تلاش هرکدام) گزارش کرده است. اینها ادعای شرکتاند، نه آزمون مستقل فناوریکده:
WANDR: طبق اعلام Exa، بالاتر از Opus 5.5 و فاصلهٔ زیادتر نسبت به Perplexity و GPT-6 Astra، با هزینهٔ هر تسک کمتر از Opus 5.5.
DeepSearchQA / WideSearch: بهبودهای درصدی اعلامشده در برابر همان رقبا، همراه با ادعای هزینهٔ کمتر در بعضی مقایسهها.
Find-All Company: فاصلهٔ خیلی بزرگ اعلامشده در «موجودیت پیداشده» — دقیقاً جایی که باید بدبین باشید تا روی دیتای خودتان تکرار کنید.
خود Exa توضیح میدهد WANDR روی فهرستهای عریض با فیلدهای عمیق و شواهد مدل شده (شبیه diligence). grader را با منطق upstream همراستا کرده ولی ابزار محتوا، transport و مدل قاضی را عوض کرده است. نتیجه: برای تصمیم خرید، یک پایلوت کوچک روی همان نوع لیستی که واقعاً میسازید معیار بهتری از اسلاید بنچمارک است.
قیمت، سقف و انتظارات زمانی
Ultra قیمت ثابت ندارد؛ تا سقف پیشفرض ۲۰ دلار (یا سقفی که با budget میگذارید) بر اساس ACU و جستجو حساب میشود. اجراهای کوتاهتر ارزانتر تمام میشوند. زمان اجرا هم «ضمانت تأخیر» نیست — به سختی پرسش، پیچیدگی schema و در دسترس بودن منابع بستگی دارد. مستندات صریح میگوید Ultra را وقتی انتخاب کنید که کاملبودن از تأخیر و هزینه مهمتر است.
برای شروع ارزانتر: medium روی یک موجودیت، auto وقتی اندازهٔ لیست معلوم نیست، و فقط وقتی completeness حیاتی است سراغ ultra بروید. اکانتهای جدید طبق صفحهٔ قیمت Exa اعتبار رایگان ماهانه دارند؛ جزئیات را در داشبورد ببینید.
نکات عملی برای سازندگان و پژوهشگرهای فارسیزبان
schema را تنگ بگیرید: فیلدهای اجباری کم، فیلدهای نامطمئن را nullable بگذارید تا مدل مجبور به ساختن واقعیت نشود.
معیار را در query بنویسید: Ultra جادو نیست؛ هرچه تعریف «واجد شرایط» روشنتر باشد، لیست تمیزتر میشود.
exclusion و ادامه: ردیفهای قبلی را exclude کنید یا با previousRunId بگویید «۱۰ تای دیگر» — برای لیستهای بلند جلوی تکرار را میگیرد.
هزینه را از قبل سقف بزنید: مخصوصاً اگر تیم کوچکید یا کارت ارزی محدود دارید؛ ۲۰ دلار سقف پیشفرض است نه قیمت ثابت.
خروجی را انسانبازبینی کنید: grounding کمک میکند، ولی برای تصمیم حقوقی/مالی منبع اول را خودتان باز کنید.
SDK یا MCP: exa-py / exa-js یا MCP میزبانیشدهٔ Exa برای اتصال به کلاینتهایی مثل Claude یا Cursor؛ کلید از داشبورد.
این ابزار برای چه کسی مناسب است؟
مناسب: تحلیلگر بازار، تیم داده برای جمعآوری مجموعهٔ آموزشی از وب، فروش B2B که لیست حساب غنی میخواهد، پژوهشگری که به استناد فیلدبهفیلد نیاز دارد.
کمتر مناسب: سؤال یکخطی روزانه؛ بودجهٔ خیلی تنگ بدون سقف؛ انتظار پاسخ زیر چند ثانیه؛ کارهایی که یک Search ساده حلشان میکند.
جایگزین سبکتر داخل همان محصول: اول medium یا auto را روی همان query امتحان کنید؛ اگر پوشش کافی بود، Ultra را نگه دارید برای دورهای سخت.
جمعبندی
Exa Agent Ultra (۲۵ سپتامبر ۲۰۲۶) بالاترین effort رسمی Agent است برای تحقیق تا حد ممکن کامل، لیستسازی بزرگ و غنیسازی موجودیت با خروجی ساختیافته. قیمتش مصرفمحور است با سقف پیشفرض حدود ۲۰ دلار، و بنچمارکهای درخشان پست را باید ادعای شرکت دید. اگر کارتان «یک جستجو» نیست و completeness برایتان پول میارزد، با یک پایلوت محدود و schema مشخص شروع کنید — نه با روشنکردن Ultra روی هر درخواست.
سؤالات پرتکرار
Exa Agent Ultra چیست؟
بالاترین سطح effort در Exa Agent برای تحقیق عمیق، ساخت فهرست و غنیسازی موجودیت؛ اعلام رسمی حدود ۲۵ سپتامبر ۲۰۲۶، با مقدار effort برابر ultra در مستندات فعلی.
فرق Ultra با auto یا xhigh چیست؟
xhigh هنوز قیمت ثابت حدود ۱ دلار دارد؛ auto و ultra مصرفمحورند با سقف پیشفرض ۵ و ۲۰ دلار. Ultra برای کارهای بزرگتر و سختتأییدتر از auto در نظر گرفته شده است.
آیا باید هدر بتای max را بفرستم؟
طبق مستندات فعلی همان effort=ultra کافی است. اگر جایی هنوز max و هدر بتا دیدید، آن را کهنه فرض کنید و docs روز را معیار بگیرید.
هزینهٔ واقعی یک اجرا چقدر است؟
بستگی به ACU و تعداد جستجو (و غنیسازی تماس در صورت استفاده) دارد و تا سقف budget یا پیشفرض ۲۰ دلار بالا میرود؛ اجراهای زودتمام ارزانترند.
آیا بنچمارک WANDR یعنی Ultra از همه بهتر است؟
خیر بهعنوان حقیقت مطلق. آن ارقام را Exa گزارش کرده؛ برای کار شما فقط ارزیابی روی نمونهٔ واقعی خودتان معیار است.
خروجی میتواند JSON باشد؟
بله؛ با outputSchema میتوانید ساختار بخواهید و در output.structured بخوانید. برای فیلدهای مبهم از nullable استفاده کنید.
برای شروع از کجا بروم؟
کلید API از داشبورد Exa، نصب exa-py یا exa-js، یک query با effort متوسط روی یک موجودیت، بعد در صورت نیاز همان کار را با ultra و سقف بودجه تکرار کنید.
Zero Data Retention با Ultra چه میشود؟
اگر برای تیم ZDR فعال باشد، نگهداری کوتاه است، previousRunId و بعضی dataSources در دسترس نیستند؛ جزئیات را در docs Agent بخوانید.
منابع
Exa Blog — Introducing Exa Agent Ultra (۲۵ سپتامبر ۲۰۲۶)
Exa Docs — Agent API overview (effort، قیمت ACU، ultra)