فهرست مطالب
سامسونگ ریسرچ کد LittleBit-2 را بهصورت عمومی منتشر کرد؛ روشی برای فشردهسازی مدلهای زبانی بزرگ تا ۰.۱ بیت به ازای هر وزن — یعنی حدود یکدهم حجمی که حتی روشهای یکبیتی اشغال میکنند. ترفند اصلی نسخهٔ دوم، «تراز هندسهٔ نهفته» با الگوریتم Joint-ITQ است که به گفتهٔ تیم سامسونگ، بدون هیچ هزینهٔ اضافه در زمان اجرا، دقت را در کل رژیم زیر یک بیت بالا میبرد. اگر دنبال اجرای مدلهای بزرگ روی سختافزار معمولی هستید یا پژوهشگر فشردهسازیاید، این خبر مستقیم به کارتان میآید.
در این مطلب میگوییم LittleBit-2 دقیقاً چه مشکلی را حل میکند، سازوکار «چرخش نهفتهٔ داخلی» به زبان ساده چطور کار میکند، بنچمارکهای اعلامشدهٔ سامسونگ چه میگویند (و چه نمیگویند)، کد عمومی چه مدلهایی را پشتیبانی میکند و در پایان هم یک نگاه صادقانه به محدودیتها و جایگاه این روش در رقابت فشردهسازی ۲۰۲۶ میاندازیم.
پاسخ کوتاه
LittleBit-2 ادامهٔ روش LittleBit سامسونگ ریسرچ است: فشردهسازی مدل زبانی با «فاکتوریزاسیون نهفتهٔ کمرتبه» و باینریکردن عاملها، تا ۰.۱ بیت به ازای هر وزن.
نسخهٔ دوم با چرخش داخلی نهفته و الگوریتم Joint-ITQ، بردارهای منفردِ «نوکتیز» را با ابرمکعب باینری همراستا میکند؛ تغییری که فقط در مرحلهٔ مقداردهی اولیه رخ میدهد و به گفتهٔ سامسونگ هیچ سربار استنتاجی ندارد.
بنچمارکهای خود سامسونگ: در ۱ بیت روی Llama-2 7B به PPL برابر ۸.۲۷ میرسد (بهتر از OneBit با ۸.۳۶ و نسخهٔ اول با ۹.۰۸) و در ۰.۱ بیت همچنان کار میکند.
کد بهصورت عمومی روی گیتهاب (SamsungLabs/LittleBit) منتشر شده و از مدلهای OPT، Llama 2/3، Phi-4، Qwen 2.5/3 و Gemma 2/3 پشتیبانی میکند؛ لایسنس CC BY-NC 4.0 یعنی استفادهٔ تجاری مجاز نیست.
این پژوهش در میانهٔ بحران حافظهٔ ۲۰۲۶ و رقابت استارتاپهایی مثل PrismML منتشر میشود؛ همهٔ اعداد، بنچمارک خود سامسونگاند و آزمون مستقل ما نیستند.
اول زمینه: کوانتیزاسیون مدل یعنی چه؟
قبل از خبر، سه مفهوم را ساده میکنیم؛ چون بدون آنها اعداد این مطلب هیچ معنایی ندارند.
بیت به ازای هر وزن یعنی چه؟
وزنهای یک مدل زبانی معمولاً با دقت FP16 ذخیره میشوند؛ یعنی برای هر عددِ وزن، ۱۶ بیت حافظه. «بیت به ازای هر وزن» یعنی میانگین تعداد بیتی که برای هر وزن خرج میکنید. کوانتیزاسیون یعنی همین عددها را با دقت کمتر ذخیره کنید تا مدل کوچکتر و سریعتر شود. روشهای رایج امروزی مدل را به ۸ یا ۴ بیت میرسانند؛ روشهای «یکبیتی» هر وزن را فقط به دو مقدار +1 یا −1 محدود میکنند. LittleBit پا را از این هم فراتر میگذارد: میانگینِ کمتر از یک بیت به ازای هر وزن، با این ترفند که ساختار ماتریس را به عاملهای کوچکتر میشکند و همان عاملها را باینری میکند.
چرا مدلها اینقدر حافظه میخواهند؟
به گفتهٔ وبلاگ سامسونگ ریسرچ، یک مدل ۷۰ میلیارد پارامتری با دقت FP16 حدود ۱۴۰ گیگابایت VRAM میخواهد؛ حتی نسخهٔ کاملاً یکبیتیِ همان مدل هم هنوز حدود ۱۵ گیگابایت لازم دارد — برای خیلی از دستگاههای لبه و کامپیوترهای مصرفی، بیش از حد زیاد است. اینجاست که رژیم «زیر یک بیت» به مرز بعدی فشردهسازی تبدیل میشود: اگر نتوانید چیپ بزرگتری بخرید، باید مدل را کوچکتر کنید.
یک بیت هم هنوز خیلی است
تصور کنید یک مدل ۸ میلیارد پارامتری را در ۰.۱ بیت به ازای هر وزن فشرده کنید: به گفتهٔ سامسونگ، بدنهٔ مدل به حدود ۰.۱ گیگابایت میرسد — یعنی کمتر از یکصدم حجم اصلی. چنین مدلی از نظر تئوری روی گوشی هم جا میشود. سؤال واقعی اما این است: آیا بعد از اینهمه فشردهسازی، مدل هنوز حرف حسابی میزند؟ جواب LittleBit-2 تلاشی است برای اینکه این سؤال، «بله» باشد.
خبر اصلی: LittleBit-2 چه چیزی را درست میکند؟
داستان دو نسخهای است. نسخهٔ اول، LittleBit، سال گذشته در کنفرانس NeurIPS 2025 معرفی شد (بانسئوک لی، دونگیو کیم، یانگچئون یو و یانگمین کیم) و نشان داد فشردهسازی زیر یک بیت از نظر تئوری ممکن است. اما یک زخم باز داشت: در نقطهٔ عملیاتی ۱ بیت، از بهترین رقیب یکبیتی یعنی OneBit عقب میماند — مثلاً PPL برابر ۹.۰۸ در برابر ۸.۳۶ روی Llama-2 7B. به بیان خود تیم سامسونگ: معماریای که روی کاغذ برتریِ نظریهٔ اطلاعاتی دارد، در عمل آن را نشان نمیداد.
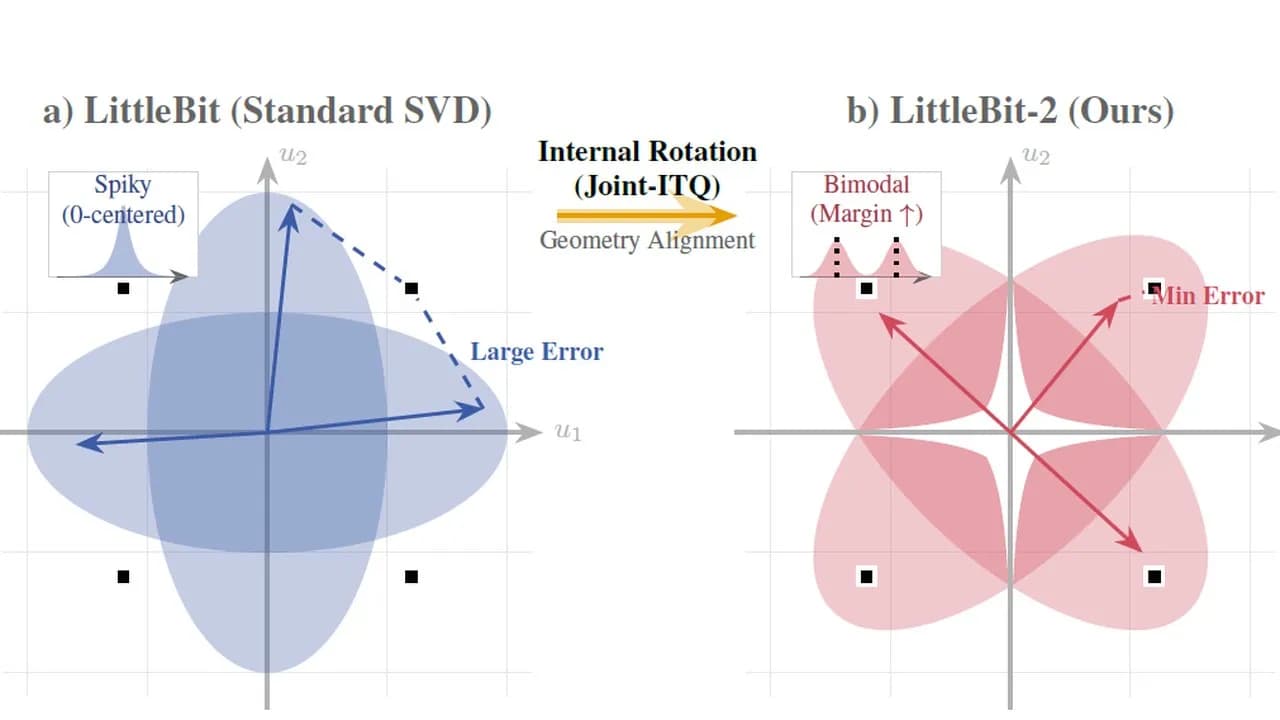
نسخهٔ دوم، LittleBit-2، که در ICML 2026 ارائه شد (بانسئوک لی و یانگمین کیم، سامسونگ ریسرچ سئول)، جواب این «چرا» را پیدا کرده: نامتقارنی هندسهٔ نهفته. بردارهای منفردی که LittleBit برای مقداردهی اولیه از SVD میگیرد، هندسهای «نوکتیز» و بهشدت همدوس دارند؛ یعنی اطلاعات در چند مختصات غالبِ پرت متمرکز میشود و بقیهٔ مقادیر نزدیک صفر میخوابند. برای کوانتیزاسیون باینری با تابع علامت، این بدترین هندسهٔ ممکن است: مقادیر نزدیک صفر با کوچکترین نویز، علامتشان برمیگردد و مقادیر پرت هم مقیاسهای مشترک اعشاری را وادار میکنند دامنهٔ دینامیکی را برای همه بیشبرآورد کنند. تیم سامسونگ روی لایهٔ پانزدهمِ Llama-2 7B اندازه گرفت: کشیدگی توزیع (کرتوسیس) حدود ۱۶.۸ و بیشینهٔ اعوجاج محلی حدود ۰.۸۸ — عملاً نزدیک به بدترین حالت نظری.
راهحل در دو قدم: چرخش داخلی و Joint-ITQ
ایدهٔ کلیدی ساده و هوشمندانه است: فاکتوریزاسیون نسبت به چرخش، ناورداست. یعنی میتوانید عاملهای نهفته را با هر ماتریس متعامد R بچرخانید بدون اینکه وزن بازسازیشده در دقت اعشاری عوض شود — اما توزیع مختصاتی آنها کاملاً دگرگون میشود. قدم اول، «چرخش نهفتهٔ داخلی» است: حتی یک چرخش تصادفی، بهخاطر تمرکز اندازه، مختصات را گاوسیمانند میکند و اعوجاج موردانتظار را به حد گاوسی (حدود ۰.۳۶) میرساند. روی همان لایهٔ نمونه، میانگین اعوجاج به ۰.۳۶ افتاد و بیشینه از ۰.۸۸ به ۰.۴۳ رسید.
قدم دوم، Joint-ITQ (کوانتیزاسیون تکراری توأم)، فراتر میرود: چون گاوسی هنوز حول صفر متمرکز است — دقیقاً ناپایدارترین نقطه برای تابع علامت. این الگوریتم مسئله را بهصورت یک «مسئلهٔ پروکراستس متعامد توأم» فرمول میکند: یک چرخش مشترک R پیدا کن که منیفلد نهفتهٔ بههمچسبیدهٔ هر دو عامل را تا حد ممکن به رأسهای ابرمکعب باینری نزدیک کند. حلش با کمینهسازی متناوب انجام میشود و بهصورت اثباتشده، نرم L1 را یکنوا زیاد میکند؛ نتیجهاش توزیعی دوقلهای است که دو قلهاش روی رأسهای +1 و −1 مینشینند و حاشیهٔ تصمیمگیری را بیشینه میکنند. روی لایهٔ نمونه، میانگین اعوجاج به ۰.۳۰ رسید — حتی بهتر از حد نظری گاوسی. کل این فرایند یک قدم آفلاینِ یکباره است: در کمتر از ۵۰ تکرار همگرا میشود و به گفتهٔ تیم، فقط حدود ۳ ثانیه سربار روی هر لایه اضافه میکند.
نکتهٔ مهم برای شما: این تغییر فقط در مرحلهٔ مقداردهی اولیه است. در مخزن رسمی، فعالسازیش یک پرچم اختیاری است (--use_itq) و لایهٔ مستقرشده در زمان اجرا دقیقاً همان لایهٔ نسخهٔ اول میماند — یعنی هیچ هزینهٔ استنتاجی اضافهای ندارید.
از نظر فنی دقیقاً چه اتفاقی میافتد؟
LittleBit هر ماتریس وزن متراکم W را به عاملهای نهفتهٔ کمرتبهٔ باینری میشکند. وزن مؤثر با ساختار متقارن «مقیاس-باینری-مقیاس-باینری-مقیاس» بازسازی میشود؛ جایی که U و V عاملهای ±1 با رتبهٔ r هستند و سه بردار h و l و g مقیاسهای اعشاری سطر، نهفته و ستوناند. چون تعداد پارامترها از ابعاد ماتریس جدا میشود، فقط با کنترل رتبه میتوانید به نرخهای کسریِ زیر یک بیت برسید.
آموزش با روش QAT (آموزش آگاه از کوانتیزاسیون) انجام میشود: با تابع SmoothSign و تقطیر دانش، و مقداردهی اولیهٔ Dual-SVID — یعنی عاملهای باینری از علامتِ عاملهای SVDِ بریدهشده شروع میشوند و مقیاسها از تقریب رتبه-یکِ اندازهها استخراج میشوند. یک قدم «جبران باقیمانده» (residual) هم خطای تقریب را کمکم میتراشد. اگر توسعهدهندهاید و میخواهید امتحانش کنید، دستور آموزشی مخزن دقیقاً همین ترکیب را با --quant_func SmoothSign و --quant_mod LittleBitLinear اجرا میکند.
بنچمارکها چه میگویند؟
جدول زیر خلاصهای از نتایج اصلی مقاله است؛ همهٔ اعداد از خود تیم سامسونگاند و آزمون مستقل ما نیستند. معیار PPL روی مجموعهٔ WikiText-2 است — هرچه کمتر، بهتر.
مدل و رژیم | LittleBit (نسخهٔ اول) | بهترین رقیب | LittleBit-2 |
|---|---|---|---|
Llama-2 7B در ۱ بیت | ۹.۰۸ | OneBit: ۸.۳۶ | ۸.۲۷ |
Llama-3 8B در ۱ بیت | ۱۶.۳۰ | OneBit: ۱۳.۰۹ | ۱۱.۵۳ |
Llama-3 8B در ۰.۵۵ بیت | ۱۸.۴۷ | STBLLM فرو میپاشد: ۲۴۱.۹۶ | ۱۴.۰۱ |
Llama-3 8B در ۰.۱ بیت | ۲۶.۱۱ | — | ۲۳.۷۴ |
جدول را اینطور بخوانید: در نقطهٔ ۱ بیت که نسخهٔ اول از OneBit عقب بود، نسخهٔ دوم جلو میزند؛ و هرچه فشردهسازی عمیقتر میشود، فاصله با رقبا بیشتر میشود. در ۰.۵۵ بیت رقیبی مثل STBLLM عملاً از کار میافتد (PPL بالای دویست یعنی مدل دارد هذیان میگوید) اما LittleBit-2 هنوز عددی سالم نگه میدارد.
چند نکتهٔ خواندنی از دل نتایج
اول، دقت صفرشات (میانگین پنج بنچمارک استدلالی) هم همراه PPL بهتر شده: روی Llama-3 8B در ۱ بیت، ۵۷.۳۳٪ در برابر ۵۲.۲۳٪ OneBit. دوم، یک ناهنجاری مقیاسپذیری نسخهٔ اول رفع شده: قبلاً مدل ۱۳ میلیاردی در تستهای صفرشات از مدل ۷ میلیاردی ضعیفتر بود (۵۱.۴۹٪ در برابر ۵۲.۸۱٪) و حالا ترتیب طبیعی برگشته (۶۰.۵۳٪ در برابر ۵۵.۷۹٪) — نشانهای که تراز هندسی، پایداری بهینهسازی مدلهای بزرگتر را هم بهتر کرده. سوم، نوسان علامت در اوایل آموزش حدود ۳.۸ برابر کمتر شده؛ یعنی وزنها دیگر نزدیک مرز تصمیم صفر گیر نمیکنند و زیر نویز گرادیان، مدام علامت عوض نمیکنند.
تعمیم به مدلهای دیگر
نتایج فقط روی خانوادهٔ Llama نیست: روی Gemma-3 27B در رژیم افراطی ۰.۱ بیت، نسخهٔ دوم PPL برابر ۱۶.۳۸ و دقت میانگین ۴۷.۰۶٪ نگه میدارد، جایی که تقریب FP16 کمرتبه کاملاً فرو میپاشد (PPL بالای ۳۵). روی Qwen3 8B در ۱ بیت هم ۱۱.۷۳ در برابر ۱۳.۶۰ نسخهٔ اول است. اگر اهل مقایسهٔ مدلهای هوش مصنوعی هستید، این اعداد را با احتیاطِ همیشگیِ «بنچمارکِ خودِ سازنده» بخوانید.
کد عمومی؛ چه کسانی میتوانند امتحانش کنند؟
کد LittleBit-2 بهصورت عمومی در مخزن SamsungLabs/LittleBit روی گیتهاب منتشر شده؛ تا زمان نگارش این مطلب حدود ۲۷۴ ستاره و ۳۲ فورک دارد. فهرست مدلهای پشتیبانیشده: OPT، خانوادهٔ Llama (نسخههای ۲ و ۳)، Phi-4، سری Qwen (نسخهٔ ۲.۵، QwQ و نسخهٔ ۳) و سری Gemma (نسخههای ۲ و ۳). برای اجرا پایتون ۳.۱۲ توصیه شده و مخزن برای بازتولید نتایج مقاله، نسخهٔ ۴.۵۱ کتابخانهٔ transformers را پیشنهاد میکند — نسخههای جدیدتر ممکن است رفتار داخلی مدلها را عوض کنند.
دو هشدار صادقانه: اول، این یک خط لولهٔ آمادهٔ «یککلیکه» نیست؛ روش QATمحور است و آموزش واقعی میخواهد، نه فقط دانلود یک فایل وزن. دوم، لایسنس پروژه CC BY-NC 4.0 است — یعنی استفادهٔ غیرتجاری. اگر محصول تجاری میسازید، قبل از هر کاری متن لایسنس را بخوانید.
چرا این خبر دقیقاً الان مهم است؟
به گزارش استارتاپفورچون، صنعت هوش مصنوعی در ۲۰۲۶ بیشتر سال را درگیر یک داستان سختافزاری بوده: کمبود HBM، کمبود بستهبندی پیشرفته و جهش قیمت حافظه، همزمان با رقابت هایپراسکیلرها بر سر همان عرضهٔ محدود. پژوهشهای فشردهسازی مثل LittleBit، نیمهٔ دیگر همان معادلهاند: استدلالِ «لازم نیست همیشه چیپ بزرگتری بخری، اگر بتوانی مدل را کوچکتر کنی».
در همین مسابقه، LittleBit تنها نیست. استارتاپ PrismML با مدل Bonsai 27B (مبتنی بر Qwen3.6-27B) مدل را از حدود ۵۴ گیگابایت به ۳.۹ گیگابایت رسانده — بهقدری کوچک که روی آیفونهای پرچمدار جدید جا شود — و به گزارش همان رسانه، اپل در مراحل اولیهٔ گفتوگو با این استارتاپ است. PrismML از مارس ۲۰۲۶ از حالت مخفی بیرون آمده و ۱۶.۲۵ میلیون دلار از Khosla Ventures و Cerberus Ventures و Caltech جذب کرده است.
| LittleBit-2 (سامسونگ) | Bonsai 27B (PrismML) |
|---|---|---|
ماهیت | روش پژوهشی با کد باز (QATمحور) | محصول یک استارتاپ |
نرخ فشردهسازی | تا ۰.۱ بیت به ازای هر وزن | ۵۴ گیگابایت به ۳.۹ گیگابایت (حدود ۱۰ تا ۱۵ برابر کاهش حافظه) |
ادعای سرعت | تا ۱۱.۶ برابر سرعت استنتاج نسبت به FP16 (بنچمارک سامسونگ) | ۶ تا ۸ برابر سرعت و ۳ تا ۶ برابر مصرف انرژی کمتر (ادعای شرکت) |
وضعیت | مرحلهٔ پژوهش؛ بدون محصول نهایی | در گفتوگوی اولیه با اپل، به گزارش CNBC |
جدول را اینطور بخوانید: این دو مستقیم رقیب هم نیستند — یکی ابزار پژوهشگران است و دیگری محصول یک استارتاپ — اما هر دو یک پیام دارند: سال ۲۰۲۶ سالِ «مدل کوچکتر» است، نه فقط «چیپ بزرگتر». اگر ماجرای حافظه و پردازش خصوصی برایتان مهم است، مطلب پردازش خصوصی و حافظه در هوش مصنوعی را هم ببینید.
چیزهایی که هنوز روشن نیست
همهٔ اعداد درخشان این مطلب، بنچمارک خود تیم سامسونگاند؛ هنوز ارزیابی مستقلی از آزمایشگاه ثالث منتشر نشده. تا آن روز، «به گفتهٔ سامسونگ» را جدی بگیرید.
در ۰.۱ بیت، مدل «کار میکند» اما PPL بالای ۲۰ یعنی کیفیت متن تولیدی با مدل سالمِ امروزی فاصلهٔ جدی دارد. سؤال باز این است: این رژیم افراطی برای چه کاربرد واقعیای بهصرفه است؟
روش به آموزش آگاه از کوانتیزاسیون نیاز دارد؛ یعنی برای هر مدل جدید باید هزینهٔ آموزش را بدهید. خط لولهٔ آماده و بیدردسری هنوز وجود ندارد.
سامسونگ عددی دربارهٔ اجرای واقعی روی گوشی یا دستگاه لبه اعلام نکرده؛ «جا شدن از نظر حافظه» با «اجرا شدنِ روان» یکی نیست.
ادعای «۱۱.۶ برابر سرعت استنتاج» به کرنل و سختافزار خاص وابسته است و جزئیاتش در گزارش خبری نیامده.
نکتهای برای خوانندگان فارسیزبان
خبر خوب: این یک پژوهش با کد باز است، نه سرویسی که بخواهد شما را تحریم کند. کد را میتوانید دانلود و روی سیستم خودتان اجرا کنید؛ برای آشنایی با اجرای محلی مدلها، آموزش نصب و اجرای مدل با اولاما نقطهٔ شروع خوبی است. اما واقعبین باشیم: آموزش QAT روی مدلهای چندمیلیارد پارامتری، GPU قدرتمند و زمان میخواهد — چیزی که برای بیشتر ما در دسترس نیست. ارزش عملی امروز این خبر برای شما بیشتر «دانستنِ جهت صنعت» است تا «امروز اجرایش کن». و اگر روزی مدلهای فشردهشدهٔ آماده با این روش منتشر شدند، لایسنس غیرتجاری (CC BY-NC) را فراموش نکنید: برای پروژهٔ شخصی و پژوهشی آزادید، برای محصول پولی نه.
از زاویهٔ سامسونگ هم جالب است: این همان شرکتی است که گوشیهایش را میشناسید (وانیوآی ۹ و گلکسیهای جدید)؛ حالا بازوی پژوهشیاش دارد روی مغزِ نرمافزاریِ همان دستگاهها کار میکند — مدلی که روزی کامل روی گوشی شما اجرا شود، احتمالاً از دل همین پژوهشها بیرون میآید.
جمعبندی
LittleBit-2 یک قدم پژوهشیِ تمیز است: بهجای معماری جدید، همان معماری قبلی را با یک «پیششرطساز هندسی» درست میکند و به گفتهٔ سامسونگ، در کل رژیم زیر یک بیت، رکورد تازهای میزند — بدون اینکه در زمان اجرا چیزی اضافه شود. اگر پژوهشگر یا مهندس فشردهسازی هستید، کد باز است و ارزش امتحان دارد. اگر کاربر عادی یا توسعهدهندهٔ محصول هستید، امروز کاری برای انجام دادن ندارید جز اینکه بدانید موج «مدلهای کوچکتر» جدیتر از همیشه است؛ محصولهای آمادهاش دیر یا زود میرسند. و تا آن روز، هر عدد درخشانی را با همان جملهٔ همیشگی بخوانید: بنچمارکِ خودِ سازنده، نه آزمون مستقل.
پرسشهای متداول
LittleBit-2 با روشهایی مثل QLoRA چه فرقی دارد؟
QLoRA برای «آموزش کمهزینهٔ» مدلِ ازپیشکوانتیزهشده است؛ LittleBit-2 خودِ «فشردهسازی» است و مدل را تا زیر یک بیت میرساند. یکی ابزار تنظیم دقیق است، دیگری ابزار کوچککردن مدل.
۰.۱ بیت به ازای هر وزن یعنی مدل خراب نمیشود؟
نه کاملاً. در این رژیم افراطی مدل هنوز «کار میکند» (PPL حدود ۲۳.۷۴ روی Llama-3 8B به گفتهٔ سامسونگ) اما کیفیتش با مدل سالم فاصله دارد. این نقطهٔ عملیاتی امروز بیشتر یک دستاورد پژوهشی است تا گزینهٔ تولیدی.
آیا میشود این مدلهای فشرده را روی موبایل اجرا کرد؟
از نظر حافظه، در تئوری بله — بدنهٔ یک مدل ۸ میلیاردی در ۰.۱ بیت به حدود ۰.۱ گیگابایت میرسد. اما سامسونگ اجرای واقعی روی گوشی را نشان نداده و کرنلهای استنتاجِ بهینه برای این فرمت، خودش یک پروژهٔ جداست.
کد LittleBit-2 رایگان است؟
کد روی گیتهاب عمومی است اما لایسنس CC BY-NC 4.0 دارد؛ یعنی استفادهٔ شخصی و پژوهشی آزاد است ولی استفادهٔ تجاری مجاز نیست. برای محصول تجاری باید سراغ لایسنس دیگری بروید یا از تیم سامسونگ اجازه بگیرید.
چرا سامسونگ یک پژوهش اینچنینی را بازمتن منتشر میکند؟
انتشار کد و مقاله در کنفرانسهایی مثل ICML، رسم استاندارد پژوهش صنعتی است: اعتبار علمی میآورد، جامعه آن را میسنجد و در بلندمدت، اکوسیستم را به سمت معماریهایی میبرد که سختافزار سامسونگ هم از آنها سود میبرد. دلیل رسمی خاصی اعلام نشده.
برای امتحانش به چه سختافزاری نیاز است؟
خودِ آموزش QAT به GPUهای قدرتمند (در مثالهای مخزن، تا چند GPU با DeepSpeed) نیاز دارد. اما اگر فقط بخواهید چکپوینت آماده را ارزیابی کنید، با یک GPU معمولیِ پژوهشی هم میشود شروع کرد.
این روش فقط برای مدلهای متنی است؟
مقاله و کد روی مدلهای زبانی (متن) متمرکزند. ایدهٔ فاکتوریزاسیون نهفتهٔ باینری در اصل به هر شبکهٔ عصبیِ ماتریسمحور قابل تعمیم است، اما پیادهسازی و بنچمارک عمومی فعلاً برای LLMهاست.
منابع
گیتهاب SamsungLabs: پیادهسازی رسمی LittleBit و LittleBit-2
وبلاگ سامسونگ ریسرچ: معرفی LittleBit-2 و تراز هندسهٔ نهفته
استارتاپفورچون: گزارش فشردهسازی سامسونگ تا یکدهم بیت و رقابت با PrismML
AI Minor: معرفی انگلیسی LittleBit-2