فهرست مطالب
سونو (Suno) در ۱ اکتبر ۲۰۲۶ (۹ مهر ۱۴۰۵) در پستی از جک برودی، مدیر محصول ارشد شرکت، از Speech رونمایی کرد: ابزاری که به ادعای شرکت «اولین مدل صوتی است که صدا و موسیقی را با هم، در یک ترک منسجم میسازد». یعنی یک متن میدهی — یک شعر، یک داستان، چیزی که خودت نوشتهای — و مدل هم نریشن را میخواند، هم موسیقی متن اصلی زیرش را میسازد؛ در یک فایل، بدون اینکه بعداً خودت صدا را با موزیک میکس کنی. این نسخه هنوز بتای عمومی است: بعد از یک ماه تست با گروه کوچکی از کاربران، حالا برای همهٔ کاربران وب، iOS و اندروید باز شده است.
اگر تا امروز با «متنبهگفتار» فقط یک کار بلد بودی — متن را بده، صدا بگیر، بعد خودت دنبال موزیک متن بگرد و دو فایل را روی هم بچین — حالا قرار است این دو قدم به یک قدم تبدیل شود. در ادامه اول خیلی ساده میگوییم متنبهگفتار یعنی چه و چرا نسخهٔ سونو فرق دارد؛ بعد میرویم سراغ خود Speech: دو حالتش چطور کار میکنند، قدمبهقدم چطور شروعش کنی، با پلنهای واقعی سونو هر ترک چقدر برایت آب میخورد، کنار رقبای جدیاش کجا میایستد و آخرش میگوییم برای تو میصرفد یا باید صبر کنی.
پاسخ کوتاه
خبر: سونو ابزار Speech را در ۱ اکتبر ۲۰۲۶ (۹ مهر ۱۴۰۵) بهصورت بتای عمومی برای همهٔ کاربران وب و موبایل باز کرد؛ اعلام در وبلاگ رسمی شرکت از زبان جک برودی، مدیر محصول ارشد.
ایدهٔ اصلی: صدای گوینده و موسیقی متن اصلی در یک ترک ساخته میشوند، نه دو فایل جدا که بعداً میکس شوند؛ به گفتهٔ شرکت، این ادعای «اولین مدل صوتی» با چنین کاری است و بنچمارک مستقلی برایش منتشر نشده.
دو حالت: Simple (یک خط توضیح میدهی و مدل خودش متن گفتار را هم مینویسد) و Advanced (متن خودت را کلمهبهکلمه میخواند؛ با کنترل جنسیت صدا، سبک گفتار و تنوع خروجیها).
سقف خروجی: هر ترک حدود ۸ دقیقه (به گزارش The Verge) و دکمهای برای خاموش کردن موسیقی دارد تا خروجی نریشن خالص بگیری.
قیمت: سونو قیمت جداگانهای برای Speech اعلام نکرده؛ نسلها از همان کردیتهای آهنگ کم میشوند و دانلودها در همان سقف ماهانه (۲۰ در Pro و ۶۰ در Premier) حساب میشوند.
اول زمینه: متنبهگفتار (TTS) یعنی چه؟
متنبهگفتار، یعنی Text-to-Speech — مدلی که متن نوشتهشده را به صدای گفتاری تبدیل میکند. نمونهٔ روزمرهاش را دیدهای: دستیار صوتی گوشی که پیام را برایت میخواند، یا دکمهٔ «خواندن متن» در اپهای کتابخوان. ابزارهای حرفهایتر — مثل ElevenLabs که نسخهٔ v4 آن را بررسی کردهایم — همین کار را با کیفیت بالاتر، انتخاب صدا و گاهی تقلید لحن انجام میدهند و برای پادکست، دوبله و ویساور تبلیغات استفاده میشوند.
چرا نسخهٔ سونو فرق دارد؟
فرایند معمولی ساخت یک ویساور موزیکدار سه مرحله است: اول متن را به صدا تبدیل میکنی، بعد یک موسیقی متن مناسب پیدا میکنی (یا میسازی)، و آخر سر دو فایل را در نرمافزار تدوین روی هم میچینی و حجم و ریتم را تنظیم میکنی. Speech سونو مرحلهٔ دوم و سوم را حذف میکند: صدا و موسیقی همزمان و در یک مدل ساخته میشوند و یک فایل تحویل میگیری. تشبیه سادهاش این است: بهجای اینکه نریتور و نوازنده جداگانه ضبط کنند و تو در استودیو وصلشان کنی، هر دو در یک اتاق، هماهنگ با هم اجرا میکنند.
«ترک» و «بتا» یعنی چه؟
ترک یعنی همان یک فایل صوتی کامل — چیزی که در نهایت دانلود و منتشر میکنی. بتا هم یعنی محصول هنوز کامل نشده و شرکت آن را در دست عموم گذاشته تا با بازخورد واقعی بهترش کند؛ پس قرار است گاهی خطا ببینیم و سونو خودش هم این را صراحتاً میگوید.
Speech دقیقاً چه میکند؟
تو دو چیز میدهی و یک چیز میگیری. ورودی اول، متن یا ایده است: میتواند متنی باشد که خودت نوشتهای، یک شعر، یا فقط یک جمله توصیف. ورودی دوم، توصیف صدا و سبک موسیقی است: مثلاً «صدای گرم زنانه» با «پیانوی آرام». خروجی، یک ترک واحد است که در آن نریشن و موسیقی از اول با هم طراحی شدهاند — نه دو لایهای که بعداً بهزور به هم چسبیدهاند.
مثالهای خود سونو اینها هستند: داستان شبانه روی پیانوی ملایم، سخنرانی انگیزشی روی درامهای ورزشگاهی و حتی «لیست خرید به سبک ASMR». تیم سونو در زمان توسعه هم پیامهای متنی دوستان را به «خوانشهای دراماتیک اغراقشده» تبدیل کرده و برای بچههایشان مدیتیشن و داستان شبانه ساخته است.
سوییچ موسیقی: نریشن خالص هم میشود
نکتهٔ مهم برای کسانی که فقط صدای تمیز میخواهند: یک دکمهٔ جداگانه موسیقی را کاملاً خاموش میکند و Speech عملاً به یک ابزار متنبهگفتار معمولی تبدیل میشود. یعنی حتی اگر ایدهٔ «موزیک زیر صدا» به کارت نیاید، همان کار نریشن را هم انجام میدهد.
دو حالت: Simple و Advanced
سونو Speech را در تب Create، کنار ابزارهای آهنگسازی و با برچسب Beta گذاشته است. وقتی واردش میشوی، دو راه داری؛ انتخابت به این بستگی دارد که میخواهی متن را خودت بنویسی یا نه.
حالت Simple: یک خط توصیف، بقیه با مدل
در این حالت فقط یک جمله توصیف مینویسی و مدل خودش هم متن گفتار را مینویسد، هم اجرایش میکند. مثال رسمی سونو: «a pirate captain rallying his crew» — «یک کاپیتان دزد دریایی که خدمهاش را جمع میکند». خروجی میشود یک نریشن داستانی با موسیقی حماسی زیرش. این حالت برای ایدهپردازی سریع و سرگرمی عالی است؛ ولی چون متن را خودت ننوشتهای، کنترل دقیقی روی کلمهها نداری.
حالت Advanced: متن خودت، کلمهبهکلمه
اینجا متن آمادهات را میچسبانی و مدل دقیقاً همان را میخواند — مناسب سناریوهای واقعی مثل متن پادکست یا تبلیغ. سه کنترل در دست داری: جنسیت صدا (مذکر/مؤنث)، سبک گفتار (مثلاً آرام، پرانرژی، رسمی) و میزان تنوع بین نسلهای مختلف (یعنی هر بار که دکمه را میزنی چقدر خروجی با قبلی فرق کند). این همان جایی است که میتوانی چند تیک بگیری و بهترین را انتخاب کنی.
قدمبهقدم: چطور Speech را شروع کنی
حساب بساز یا وارد شو: Speech به همهٔ کاربران سونو — وب، iOS و اندروید — باز است. اگر حسابت را نداری، از سایت یا اپ سونو ثبتنام کن (پلن رایگان برای شروع کافی است).
به تب Create برو: در صفحهٔ ساخت، گزینهٔ Speech را با برچسب Beta پیدا کن.
حالت را انتخاب کن: اگر ایدهٔ کلی داری، Simple؛ اگر متن آماده داری، Advanced و متن را بچسبان.
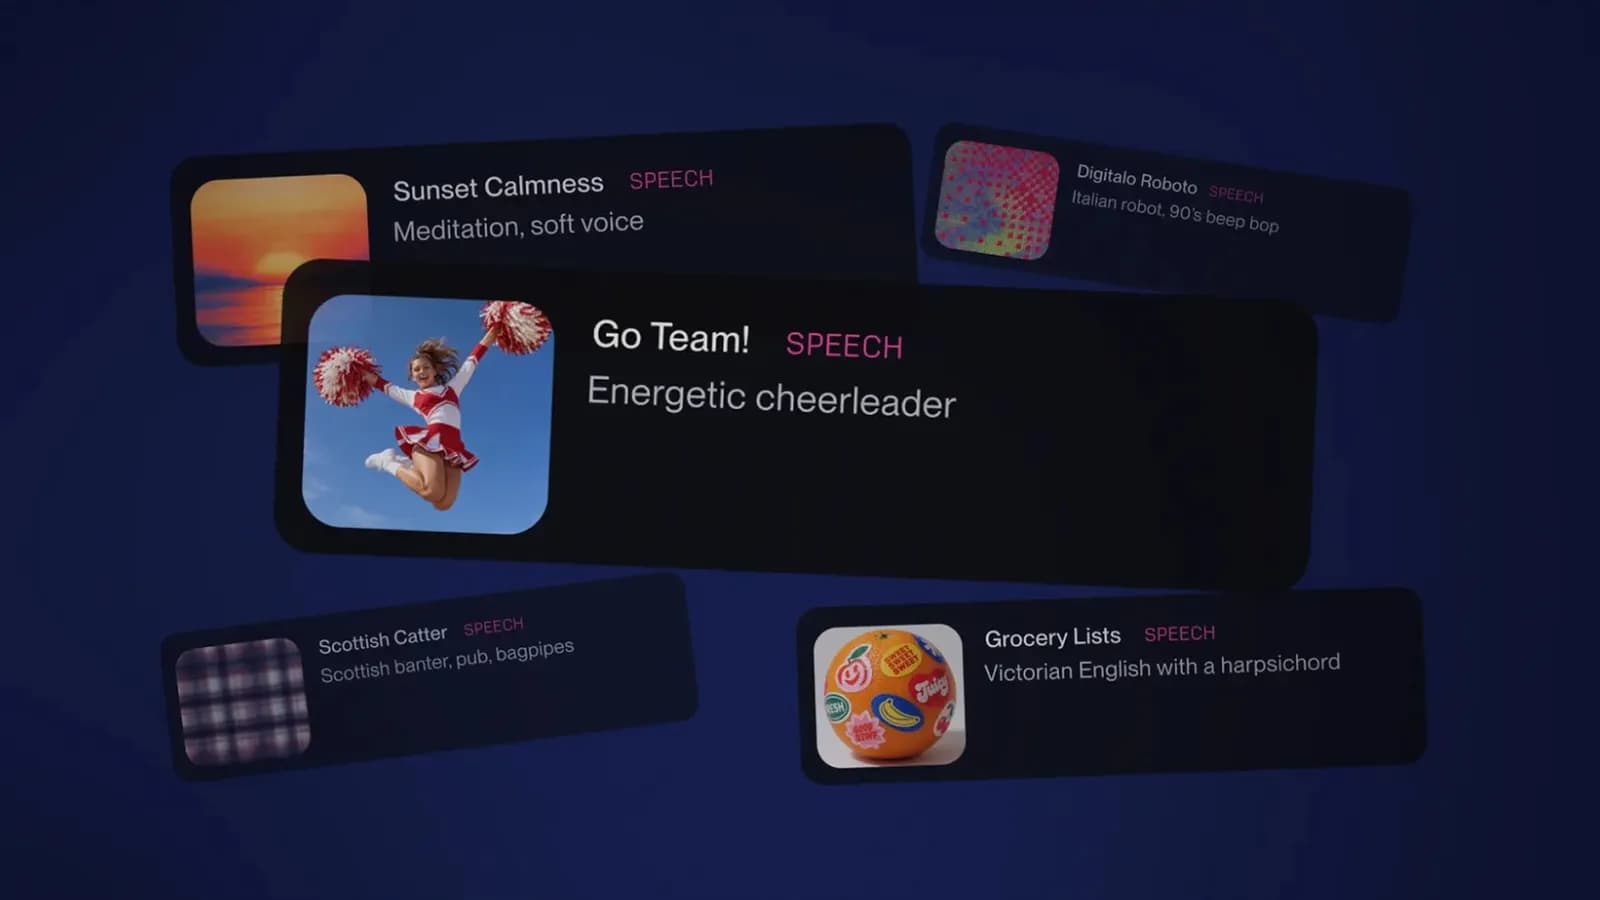
صدا و موزیک را توصیف کن: در Simple، همان یک خط توصیف (مثلاً «چیرلیدر پرانرژی»)؛ در Advanced، جنسیت صدا، سبک گفتار و سبک موسیقی متن را مشخص کن. الگوهای گرافیک رسمی معرفی — مثل «Energetic cheerleader» یا «Victorian English with a harpsichord» — نشان میدهند توصیفها میتوانند هم احساسی باشند، هم تصویری.
تولید را بزن و صبر کن: مدل هر دو بخش را با هم میسازد. اگر موسیقی نمیخواهی، سوییچ آن را خاموش کن.
گوش بده و بازسازی کن: خروجی را کامل گوش کن؛ اگر لهجه یا مکثی اذیتت کرد، با همان تنظیمات یا کمی تغییر دوباره تولید بگیر (در بتا همین چرخهٔ «تولید-گوش-تولید دوباره» روش کار است).
دانلود: دانلود در همان سقف ماهانهٔ آهنگها حساب میشود — در Pro ماهانه ۲۰ و در Premier ماهانه ۶۰ دانلود. پس هر ترک را فقط وقتی دانلود کن که ازش راضی هستی.
چه چیزهایی میتوانی بسازی؟
کاربردهایی که خود سونو پیشنهاد داده، در دو دسته میگنجند: محتوای احساسی و محتوای کاربردی. چند نمونهٔ مشخص:
داستان شبانهٔ بچهها: متن داستان خودت را بده با صدای آرام و پیانوی ملایم — آمادهٔ پخش قبل از خواب.
اینتروی پادکست: یک متن معرفی ۳۰ ثانیهای با موسیقی امضادار زیرش؛ هر قسمت همان سبک را تکرار میکنی تا برند صوتیات شکل بگیرد.
تبلیغ صوتی کوتاه: متن تبلیغ فروشگاه یا رویداد را با ریتم پرانرژی بخوان؛ مناسب استوری و ریلز.
مدیتیشن و ریلکسیشن: متن آرامشبخش با صدای نرم و موسیقی محیطی — همان چیزی که تیم سونو برای خودشان ساختهاند.
محتوای آموزشی: خلاصهٔ یک درس یا جزوه را به نریشن تبدیل کن و موقع رفتوآمد گوش بده (فقط یادت باشد: در بتا گاهی کلمهها اشتباه خوانده میشوند).
سرگرمی و هدیه: پیام تبریک تولد با موسیقی حماسی، یا خوانش دراماتیک پیامهای گروه دوستان — همان کاربردهایی که تیم سونو را خنداندهاند.
پلنها و قیمتها: هر ترک چقدر آب میخورد؟
سونو برای خودِ Speech هیچ قیمت یا سقف جداگانهای اعلام نکرده — نه در پست معرفی، نه در یادداشت انتشار. پس باید از پلنهای فعلی سونو حساب کنی. نسلهای Speech از همان کردیتهای آهنگ کم میشوند و دانلودها هم در همان سقف ماهانه. اعداد زیر از صفحهٔ رسمی قیمتگذاری سونو هستند (اکتبر ۲۰۲۶):
پلن | قیمت ماهانه | قیمت سالانه | کردیت | دانلود ماهانه | استفادهٔ تجاری |
|---|---|---|---|---|---|
Free | ۰ دلار | — | ۵۰ کردیت در روز (حدود ۱۰ آهنگ) | ۷ دانلود در کل عمر حساب | ندارد |
Pro | ۱۰ دلار | ۸ دلار در ماه (۹۶ دلار سالانه) | ۲٬۵۰۰ در ماه | ۲۰ | دارد (با قوانین دانلود مجاز سونو) |
Premier | ۳۰ دلار | ۲۴ دلار در ماه (۲۸۸ دلار سالانه) | ۱۰٬۰۰۰ در ماه | ۶۰ | دارد + Suno Studio |
جدول را اینطور بخوان: پرداخت سالانه روی هر دو پلن پولی حدود ۲۰٪ تخفیف دارد و مالیات در مرحلهٔ پرداخت جداگانه حساب میشود. یک بررسی مستقل (Songtested) گزارش داده هر نسل Speech مثل آهنگها ۱۰ کردیت میگیرد و دو تیک تحویل میدهد — یعنی با ۵۰ کردیت روزانهٔ پلن رایگان، روزی حدود ۵ نسل میتوانی بگیری. این عدد رسمی نیست ولی مقیاس خوبی میدهد: تست و سرگرمی روی پلن رایگان کاملاً ممکن است.
مقایسه با جایگزینها
جدول زیر Speech را کنار نزدیکترین گزینهها میگذارد. دقت کن: هیچکدام را خودمان تست نکردهایم؛ مشخصات از اعلامیهها و پوششهای رسانهای معتبر است:
ابزار | صدا + موسیقی یکجا؟ | نقطهٔ قوت اصلی | شروع قیمت |
|---|---|---|---|
Suno Speech (بتا) | بله — در یک مدل، یک ترک | نریشن و موزیک متن همزمان، بدون میکس دستی | رایگان (۵۰ کردیت روزانه) |
ElevenLabs (Eleven v4) | نه — فقط صدا | کیفیت صدا، ۹۰+ زبان و تگهای احساسی داخل جمله (معرفی ۲۸ سپتامبر ۲۰۲۶) | پلن رایگان محدود؛ پلنهای پولی از حدود ۵ دلار |
Adobe (ابزارهای صوتی Firefly) | نه — موزیک، گفتار و افکت جدا | اکوسیستم ادوبی و یکپارچگی با Premiere | در اشتراک Creative Cloud |
TTS معمولی + میکس دستی | نه — دو مرحلهٔ جدا | کنترل کامل روی هر لایه | رایگان تا گران (بسته به ابزار) |
نتیجهٔ جدول ساده است: اگر «موزیک متن آماده زیر صدا» میخواهی، Speech تنها گزینهای است که این کار را خودش میکند. اگر کیفیت صدای خالص، زبانهای زیاد یا کنترل دقیق لحن برایت مهمتر است، ElevenLabs هنوز جلوتر است. و اگر حرفهای تدوین میکنی و میخواهی هر لایه دست خودت باشد، روش قدیمیِ صدا + میکس دستی را نگه دار.
محدودیتهای بتا — بدون تعارف
سونو خودش صادقانه گفته «بتا واقعاً یعنی بتا». اینها چیزهایی است که باید قبل از ساختن چیزی جدی بدانی:
لهجه و مکث، هنوز ناپایدار
به گفتهٔ جک برودی، گاهی «لهجهٔ بریتیش وسط کار به استرالیایی میرود و برمیگردد» و «مکثهای دراماتیک ممکن است خیلی دراماتیک شوند». یک پوشش دیگر هم از اشتباه خوانده شدنِ گاهیِ کلمهها گزارش داده. برای محتوای تفریحی اینها بامزهاند؛ برای تبلیغ مشتری، نه.
کنترل صدا محدود است
در Speech جنسیت صدا، سبک کلی گفتار و تنوع خروجی را تنظیم میکنی — ولی صدای خاصی را نمیتوانی انتخاب یا کلون کنی. اگر دنبال «صدای خودت» هستی، قابلیت جداگانهٔ Voices سونو (از خانوادهٔ v5.5، فقط پلنهای پولی) مسیر درست است، نه Speech.
حقوق تجاری Speech مشخص نیست
سونو برای آهنگها روشن گفته: استفادهٔ تجاری فقط با پلن پولی و دانلود مجاز. ولی برای خروجیهای Speech هنوز شرایط تجاری جداگانهای منتشر نکرده. تا وقتی متن رسمی نیامده، روی ترکهای Speech برای کار پولی حساب نکن — این را ما نمیگوییم، سکوت خودِ شرکت میگوید.
طول و جزئیات فنی، نیمهکاره
سقف حدود ۸ دقیقهای از گزارش The Verge میآید، نه از خود سونو. بررسی Songtested هم گزارش داد در یک نسل، مدل بعد از تمام شدن متن هم ادامه داد؛ و سوییچ جنسیت صدا وقتی با توصیف لحن ترکیب میشد، گاهی به توصیف میباخت. همهٔ اینها بوی بتای واقعی میدهند، نه محصول نهایی.
چیزهایی که هنوز روشن نیست
هزینهٔ دقیق هر نسل: نرخ «۱۰ کردیت برای دو تیک» از یک بررسی مستقل است؛ خود سونو هنوز عدد رسمی برای Speech اعلام نکرده.
زبانها: سونو فهرستی از زبانهای پشتیبانیشدهٔ Speech منتشر نکرده؛ با توجه به ناپایداری لهجهها در بتا، برای زبانهای غیرانگلیسی هیچ وعدهای نیست.
شرایط تجاری: همانطور که گفتیم، حقوق استفادهٔ تجاری خروجیهای Speech رسماً اعلام نشده.
زمان خروج از بتا: سونو تاریخی برای نسخهٔ نهایی نگفته؛ گفته بر اساس بازخورد کاربران بهترش میکند.
برای خوانندهٔ فارسیزبان
زبان فارسی؟ پشتیبانی رسمی از فارسی اعلام نشده. با توجه به اینکه حتی لهجههای انگلیسی در بتا میلغزند، انتظار خوانش درست و روانِ فارسی را نداشته باش؛ اگر تست کردی، اول یک متن کوتاه بده و گوش کن.
دسترسی از ایران: سونو برای Speech شرایط منطقهای جداگانهای اعلام نکرده. قبل از هر خرید، صفحهٔ شرایط استفاده (Terms) را خودت بخوان و بهروز بودن دسترسی را از همانجا چک کن.
پرداخت: پلنهای پولی با کارت بینالمللی تسویه میشوند و مالیات جداگانه حساب میشود؛ قیمت نهایی همیشه در صفحهٔ پرداخت مشخص است، نه در جدولهای خبری.
بهترین شروع برای تو: پلن رایگان با ۵۰ کردیت روزانه برای تست کاملاً کافی است. با همان نرخ تقریبی ۱۰ کردیت برای هر نسل، روزی چند ترک میتوانی بسازی — بدون اینکه یک دلار خرج کنی.
نکتهٔ عملی: متنهای فارسی را فعلاً برای خروجی نهایی استفاده نکن؛ ولی میتوانی متن انگلیسی آمادهات (مثلاً اینتروی پادکست انگلیسیزبان) را همین امروز با Speech بسازی و ببینی به کارت میآید یا نه.
جمعبندی
Speech سونو یک ایدهٔ تازه را به ابزار تبدیل کرده: نریشن و موسیقی متن که از اول با هم ساخته میشوند، نه دو فایلی که بعداً به هم بچسبند. برای ساخت سریع اینتروی پادکست، داستان صوتی، تبلیغ کوتاه یا فقط سرگرمی، همین امروز با پلن رایگان میتوانی امتحانش کنی و چیزی از دست نمیدهی. ولی اگر قرار است خروجیاش را بفروشی، به مشتری تحویل بدهی یا یک پادکست جدی رویش بسازی، صبر کن: تا وقتی شرایط تجاری، زبانها و پایداری لهجهها روشن نشده، Speech یک اسباببازیِ خلاقانهٔ قدرتمند است، نه یک ابزار تولید. بتای واقعی را مثل بتای واقعی رفتار کن. و اگر از عرضههای تازهٔ این روزها خوشت میآید، معرفی Vidu Q4 Preview را هم ببین — مدل ویدیویی که همین هفته در بتای عمومی عرضه شد.
سؤالات پرتکرار
Suno Speech رایگان است؟
بتا برای همهٔ کاربران سونو — از جمله پلن رایگان — باز است و سونو قیمت جداگانهای برای Speech اعلام نکرده. نسلها از همان کردیتهای حسابت کم میشوند؛ پلن رایگان روزانه ۵۰ کردیت میدهد.
هر ترک Speech چقدر کردیت مصرف میکند؟
عدد رسمی اعلام نشده؛ یک بررسی مستقل (Songtested) گزارش داده هر نسل ۱۰ کردیت میگیرد و دو تیک تحویل میدهد — همان نرخ آهنگها. با این حساب، پلن رایگان روزی حدود ۵ نسل میدهد.
حداکثر طول هر ترک چقدر است؟
حدود ۸ دقیقه، به گزارش The Verge. خود سونو سقف رسمی اعلام نکرده، پس این عدد را تقریبی بدان.
میشود موسیقی متن را کاملاً حذف کرد؟
بله؛ یک سوییچ جداگانه موسیقی را خاموش میکند و خروجی نریشن خالص میگیری. در این حالت Speech عملاً مثل یک ابزار متنبهگفتار معمولی کار میکند.
میتوانم از خروجی Speech برای کار تجاری استفاده کنم؟
هنوز نه — با اطمینان نه. سونو شرایط استفادهٔ تجاری را فقط برای آهنگها (پلن پولی + دانلود مجاز) روشن کرده و برای Speech چیزی منتشر نکرده. تا اطلاعیهٔ رسمی، خروجیها را فقط شخصی و آزمایشی بدان.
Speech به فارسی هم حرف میزند؟
پشتیبانی رسمی از فارسی اعلام نشده. در بتایی که حتی لهجههای انگلیسیاش میلغزد، روی خوانش درست فارسی حساب نکن؛ اگر کنجکاوی، یک متن کوتاه تست کن و خودت قضاوت کن.
فرق Speech با ElevenLabs چیست؟
Speech صدا و موسیقی متن را همزمان و در یک ترک میسازد؛ ElevenLabs فقط صدا تولید میکند ولی کیفیت صدا، تعداد زبانها (۹۰+) و کنترل لحن بهتری دارد — جزئیاتش را در بررسی Eleven v4 آوردهایم. اگر «موزیک زیر صدا» میخواهی، Speech؛ اگر نریشن حرفهای خالص، ElevenLabs.
میتوانم صدای خودم را در Speech داشته باشم؟
نه؛ Speech فقط جنسیت و سبک کلی صدا را تنظیم میکند، نه کلون صدای خاص. برای صدای خودت باید سراغ قابلیت جداگانهٔ Voices سونو بروی که از خانوادهٔ v5.5 است و فقط روی پلنهای پولی فعال است.
منابع
وبلاگ رسمی سونو: «Introducing Speech (beta)» — جک برودی، ۱ اکتبر ۲۰۲۶ — suno.com/blog/introducing-speech-beta
یادداشت انتشار سونو — ۱ اکتبر ۲۰۲۶ (وب، iOS، اندروید، تب Create)
TPS Report: «Suno Speech Beta: AI Voice and Music in One Track» — ۲ اکتبر ۲۰۲۶ — tpsreport.news
Songtested: بررسی اولیهٔ Suno Speech (بتا) — ۲ اکتبر ۲۰۲۶ — songtested.com
The AI Musicpreneur: «Suno Speech Beta: Spoken Word and Music in One Track» — ۲ اکتبر ۲۰۲۶ — aimusicpreneur.com
OpenAIMaster: «5 New AI Tools Launched This Week (October 2026)» — اکتبر ۲۰۲۶ — openaimaster.com
Stimlau در Dev.to: «Suno vs Udio» (قیمتهای رسمی اکتبر ۲۰۲۶) — اکتبر ۲۰۲۶ — dev.to
AMPM AI Ops: راهنمای پلن رایگان سونو — اکتبر ۲۰۲۶ — ampm-aiops.com