فهرست مطالب
علیبابا در ۲۲ سپتامبر ۲۰۲۶ از Zhenwu V900، تراشهٔ هوش مصنوعی نسل بعدی خود، و برنامهای گستردهتر برای پیوند تراشه، مدل و خدمات ابری خبر داد. این اعلام در رویداد فناوری شرکت در هانگژو انجام شد و بخشی از آن نقشهٔ راه بود، نه فهرست محصولاتی که همگی همان روز برای خرید یا استفادهٔ عمومی عرضه شده باشند. برای مخاطبی که زیرساخت مدلهای زبانی را دنبال میکند، پرسش اصلی این است: آیا علیبابا میتواند وابستگی به شتابدهندههای بیرونی را کمتر کند و همزمان ابزار قابلاستفادهتری به مشتریان ابری بدهد؟
این خبر را در کنار گزارش فناوریکده دربارهٔ عاملهای هوشمند Google AX و ائتلاف مدیریت انرژی هوش مصنوعی AEMA بخوانید؛ هر دو به این پرسش نزدیکاند که زیرساخت و عاملهای هوشمند چگونه از نمایش آزمایشی به کاربرد واقعی میرسند.
چه چیزی در ۲۲ سپتامبر اعلام شد؟
علیبابا در اطلاعیهٔ رسمی خود از راهبردی تمامپشته گفت: تراشههای اختصاصی، خانوادهٔ مدلهای Qwen و خدمات ابری و عاملمحور. مهمترین جزء سختافزاری خبر، Zhenwu V900 بود؛ تراشهای که شرکت آن را برای بارهای کاری هوش مصنوعی معرفی کرد. خبرگزاری رویترز گزارش داد علیبابا برای این تراشه عملکردی حدود سه برابر نسل قبلی را ادعا کرده است. این عدد، تا وقتی آزمون مستقل با پیکربندی و بار کاری روشن منتشر نشود، باید ادعای شرکت تلقی شود؛ «سه برابر» بدون مشخصکردن معیار، بهتنهایی نمیگوید یک مدل مشخص با چه سرعت یا هزینهای اجرا میشود.
اعلام دیگر به مدلهای بزرگتر مربوط بود. رویترز نوشت شرکت از برنامهٔ توسعهٔ مدل Qwen با مقیاس پنج تا ده تریلیون پارامتر سخن گفته است. این را نباید با یک مدل منتشرشده یا قابلدسترسی اشتباه گرفت: در زمان خبر، جزئیات کافی دربارهٔ زمان عرضه، روش آموزش، سختافزار نهایی یا دسترسی توسعهدهندگان در اطلاعیهٔ عمومی تثبیت نشده بود. مقیاس پارامتر هم بهتنهایی کیفیت پاسخ، هزینهٔ استنتاج یا توانایی مدل را تعیین نمیکند.
چرا تراشهٔ اختصاصی برای علیبابا اهمیت دارد؟
آموزش و اجرای مدلهای بزرگ به شتابدهندههای محاسباتی، شبکهٔ سریع و برق و سرمایش نیاز دارد. شرکتی که هم تراشه طراحی میکند و هم مرکز داده و سرویس ابری دارد، میتواند اجزای این زنجیره را برای یکدیگر بهینه کند؛ البته تنها اگر تراشه واقعاً تولیدپذیر باشد، نرمافزارها از آن پشتیبانی کنند و مشتریان بتوانند بار کاری خود را منتقل کنند. از همین رو، اعلام یک تراشه فقط خبر طراحی سیلیکون نیست؛ آزمون هماهنگی میان سختافزار، چارچوبهای نرمافزاری و اقتصاد سرویس ابری است.
علیبابا این مسیر را در برابر محدودیت عرضهٔ تراشههای پیشرفته و رقابت جهانی در خدمات هوش مصنوعی پیش میبرد. گزارش AP نیز اعلام شرکت را در همین زمینهٔ رقابت سختافزاری چین پوشش داد. اما از این خبر بهتنهایی نمیتوان نتیجه گرفت که V900 جایگزین مستقیم محصول مشخصی شده یا محدودیتهای زنجیرهٔ تأمین را حل کرده است. برای مشتریان، پشتیبانی نرمافزاری، ظرفیت موجود و هزینهٔ هر کار مفید از نام تراشه مهمتر خواهد بود.
از نقشهٔ راه تا محصول قابلاستفاده
در اطلاعیهٔ علیبابا، تراشه بخشی از مجموعهای بود که مدل Qwen، سرویسهای ابری و عاملهای هوشمند را کنار هم میگذاشت. این اتصال میتواند برای سازندهٔ محصول جذاب باشد: بهجای گردآوری جداگانهٔ مدل، زیرساخت و ابزار اجرا، بخشی از چرخه را از یک ارائهدهنده بگیرد. بااینحال، یکپارچگی هم هزینه دارد؛ وابستگی به یک ابر میتواند مهاجرت را دشوار کند و انتخاب مدل یا سختافزار را محدود سازد.
باید میان سه سطح فرق گذاشت: معرفی رسمی محصول، آغاز ارسال یا دسترسی محدود، و ظرفیت پایدار برای مشتریان. اطلاعیهٔ ۲۲ سپتامبر دربارهٔ راهبرد و برنامههاست؛ برای ارزیابی دسترسی عمومی V900 باید اسناد فنی، فهرست سرویسهای ابری و اعلام ظرفیت عرضه را دید. همچنین جزئیات معیار بنچمارک و مقایسهٔ مستقل هنوز برای نتیجهگیری قطعی کافی نیست.
چه چیزی تغییر میکند؟
در کوتاهمدت، خبر برای مشتریان فعلی ابر علیبابا نشانهای است که شرکت میخواهد کنترل بیشتری بر زنجیرهٔ محاسبات AI داشته باشد؛ اما تغییر عملی زمانی رخ میدهد که V900 در سرویس مشخصی قابل انتخاب باشد و مستندات مهاجرت و پشتیبانی منتشر شود. برای توسعهدهندگان Qwen، برنامهٔ مدل بزرگتر میتواند جهت حرکت شرکت را نشان دهد، نه اینکه امروز مدل تازهای برای آزمایش فراهم کرده باشد. تیمهای خرید زیرساخت بهتر است معیارهایی مانند دسترسپذیری منطقهای، سازگاری چارچوبها، هزینهٔ اجرای بار کاری خود و امکان انتقال داده را بررسی کنند.
برای کاربران فارسیزبان، نکتهٔ مهمتر از عدد پارامتر یا ادعای سرعت آن است که آیا مدلها و سرویسهای همراه کیفیت زبان فارسی، مستندات روشن و شرایط دسترسی پایدار دارند. این موارد را باید در محصول واقعی و با دادهٔ آزمایشی خود سنجید؛ اطلاعیهٔ شرکتی بهتنهایی پاسخ این پرسش نیست.
پرسشهای پرتکرار
Zhenwu V900 چیست؟
تراشهٔ هوش مصنوعی علیباباست که شرکت در ۲۲ سپتامبر ۲۰۲۶ معرفی کرد. جزئیات عرضه و ارزیابی مستقل عملکرد آن باید جداگانه بررسی شود.
آیا V900 سه برابر سریعتر است؟
علیبابا چنین بهبودی را نسبت به نسل قبلی مطرح کرده است. بدون معیار آزمون و سنجش مستقل، این عدد را باید ادعای شرکت دانست.
مدل پنج تا ده تریلیون پارامتری Qwen منتشر شده؟
خیر؛ گزارشها از برنامهٔ شرکت برای توسعهٔ مدلی در این مقیاس میگویند، نه عرضهٔ قطعی یک مدل عمومی با این مشخصات.
چه زمانی مشتریان میتوانند از تراشه استفاده کنند؟
اعلام مورد استناد، زمانبندی و دسترسی عمومی را بهطور کافی مشخص نمیکند. فهرست سرویسهای ابری و مستندات رسمی بعدی معیار مناسبتری است.
منابع
راهبرد هوش مصنوعی و معرفیهای علیبابا — Alibaba Cloud، ۲۲ سپتامبر ۲۰۲۶.
گزارش دربارهٔ تراشه و برنامهٔ مدل علیبابا — Reuters، ۲۲ سپتامبر ۲۰۲۶.
پوشش اعلام علیبابا — Associated Press، ۲۲ سپتامبر ۲۰۲۶.
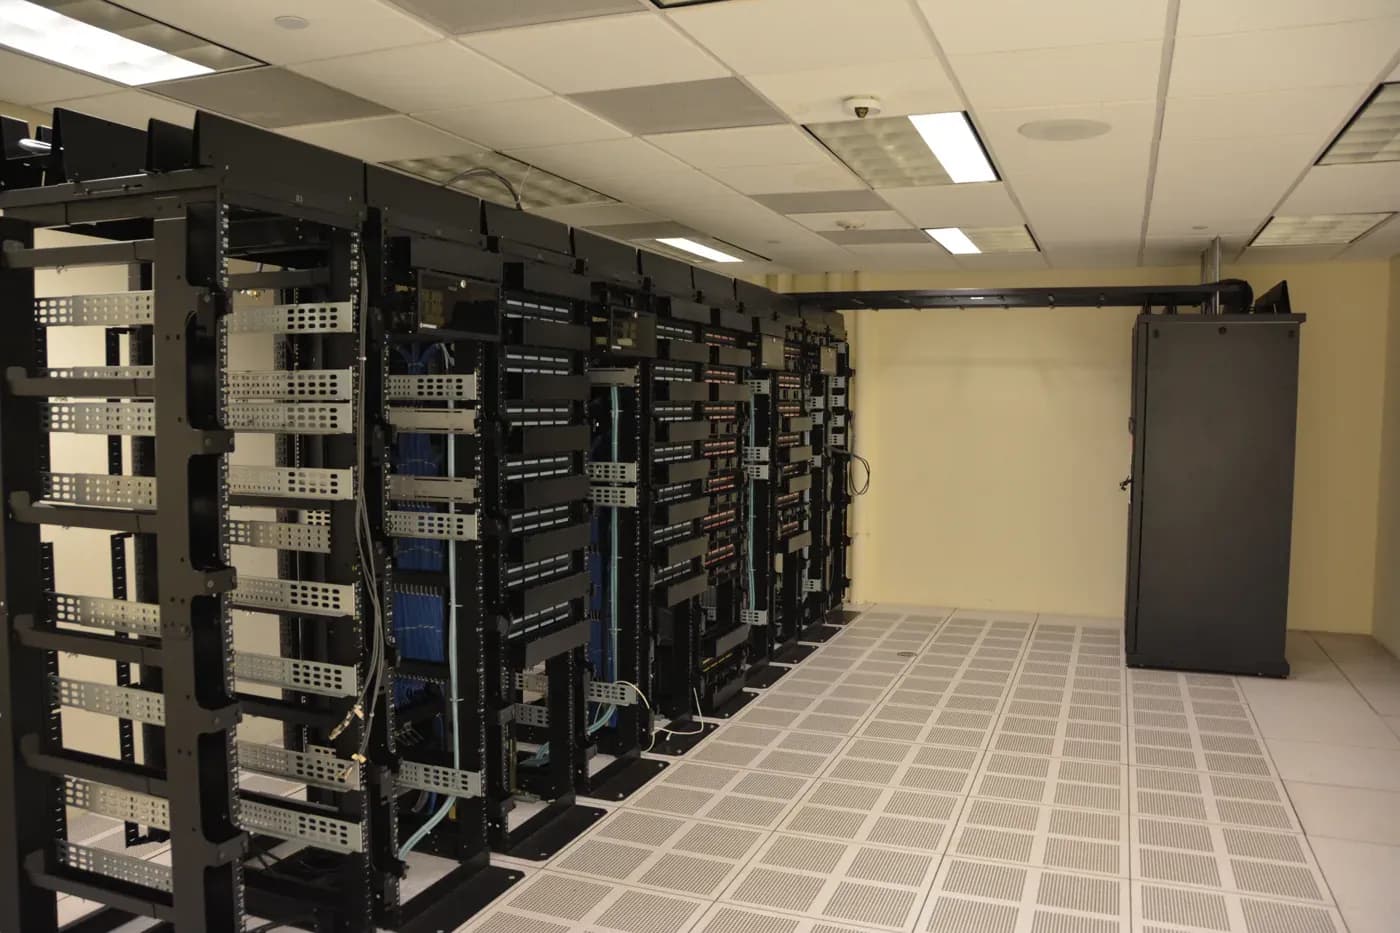
تصویر مفهومی: Datacenter Server Racks (22370909788).jpg — Carl Lender، مجوز CC BY 2.0؛ تصویر مرکز داده است و خود تراشهٔ V900 را نشان نمیدهد. تبدیل و تغییر اندازه به WebP.