فهرست مطالب
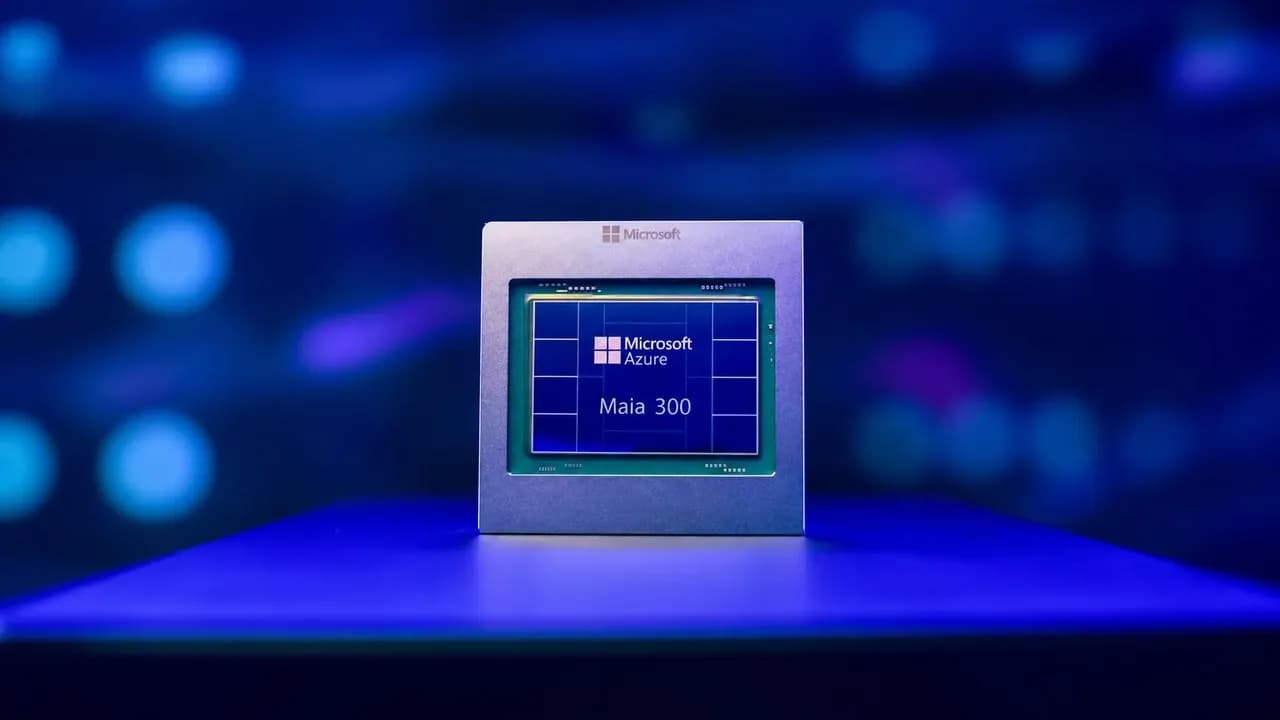
مایکروسافت از مایا ۳۰۰ رونمایی کرد؛ نسل سوم تراشهٔ هوش مصنوعی اختصاصی آژور که قرار است از سال ۲۰۲۷ به سامانهٔ اصلی اجرای مدلها در محصولات این شرکت — از کاپایلت و گیتهاب کاپایلت تا تیمز — تبدیل شود. ادعای بزرگ مایکروسافت: ۴۰ درصد توکن بیشتر به ازای هر مگاوات برق، نسبت به سیستمهای مبتنی بر پردازندههای گرافیکی. اگر از سرویسهای مایکروسافت استفاده میکنید یا بازار چیپهای هوش مصنوعی را دنبال میکنید، این خبر مستقیماً روی قیمت و سرعت خدماتی اثر میگذارد که هر روز با آنها کار میکنید.
در این مطلب میگوییم مایا ۳۰۰ دقیقاً چیست و چرا تراشهٔ «استنتاج» با تراشهٔ «آموزش» فرق دارد، اعداد مایکروسافت (۴۰ درصد و ۷ برابر) را با دقت و تردید لازم میخوانیم، مشخصاتش را با نسل قبلی مقایسه میکنیم، میبینیم این حرکت در موج بزرگتر چیپهای اختصاصی غولهای فناوری کجا میایستد، و در پایان هم برای خوانندهٔ فارسیزبان میگوییم این خبر عملاً چه معنایی دارد و چه کاری میشود با آن کرد.
پاسخ کوتاه
مایا ۳۰۰ نسل سوم شتابدهندهٔ هوش مصنوعی اختصاصی مایکروسافت (Azure Maia) است که ۱۲ اکتبر ۲۰۲۶ (۲۰ مهر ۱۴۰۵) معرفی شد؛ استقرار تولیدی آن از سال ۲۰۲۷ آغاز میشود.
این تراشه برای «استنتاج» ساخته شده — یعنی اجرای مدلها و پاسخگویی به کاربران — نه آموزش مدل. به گفتهٔ مایکروسافت برای استدلال با زمینهٔ طولانی، گفتوگوهای حساس به تأخیر و کارهای چندمرحلهای ایجنتهای هوش مصنوعی بهینه شده است.
ادعاهای مایکروسافت (که هنوز آزمون مستقلی ندارند): ۴۰ درصد توکن بیشتر به ازای هر مگاوات نسبت به سیستمهای مبتنی بر پردازندههای گرافیکی، و تا ۷ برابر توان خروجی توکن در سطح رک نسبت به مایا ۲۰۰.
مشخصات اعلامشده: ۸ استک حافظهٔ HBM4 با ۲۸۸ گیگابایت حافظه و ۱۸ ترابایت بر ثانیه پهنای باند، چیپلت محاسباتی با فرایند N2P شرکت TSMC و توان حرارتی ۹۵۰ وات.
مایکروسافت میخواهد خانوادهٔ مایا را از ۲۰۲۷ به استقرارهایی در مقیاس «چند گیگاوات» برساند و آن را به سامانهٔ اصلی استنتاج همهٔ محصولاتش تبدیل کند؛ یعنی یک قدم بزرگ برای کمکردن وابستگی به خرید پردازنده از انویدیا.
اول زمینه: شتابدهندهٔ هوش مصنوعی یعنی چه؟
قبل از عددها، سه مفهوم را ساده میکنیم؛ بدون آنها خبر مایا ۳۰۰ فقط یک مشت عدد بیمعناست.
استنتاج با آموزش چه فرقی دارد؟
مدلهای هوش مصنوعی دو مرحلهٔ زندگی دارند. «آموزش» یعنی همان مرحلهای که مدل روی دیتاسنترهای عظیم و با هزاران پردازنده ساخته میشود؛ یکبار رخ میدهد و خیلی گران است. «استنتاج» یعنی کاری که هر روز میلیاردها بار اتفاق میافتد: شما به کاپایلت پیام میدهید و مدلِ آماده جواب میدهد. استنتاج ارزانتر از آموزش است، اما چون حجمش باورنکردنی است، هزینهٔ برق و سختافزار آن برای شرکتها بهمرور به بزرگترین قلم هزینه تبدیل میشود. مایا ۳۰۰ دقیقاً برای همین مرحله ساخته شده: پاسخگویی سریع و ارزان به کاربران، نه آموزش مدل.
توکن یعنی چه؟
«توکن» یعنی واحد اطلاعاتی که مدل پردازش میکند؛ تقریباً هر کلمه یا بخشی از یک کلمه یک توکن است. وقتی مایکروسافت میگوید «توکن بیشتر به ازای هر مگاوات»، دارد میگوید با همان مقدار برق، پاسخهای بیشتری میتوانیم به کاربران بدهیم. برای شما به زبان ساده یعنی: هزینهٔ هر جوابی که از کاپایلت میگیرید پایینتر میآید.
چرا غولهای فناوری دارند چیپ خودشان را میسازند؟
تا چند سال پیش همه — از مایکروسافت تا استارتاپها — مدلهایشان را روی پردازندههای گرافیکی انویدیا اجرا میکردند. اما حالا گوگل تراشهٔ TPU خودش را دارد، آمازون Trainium را میسازد، متا MTIA را توسعه میدهد و مایکروسافت هم مایا را دارد. دلیلش ساده است: وقتی سالی دهها میلیارد دلار برق و سختافزار خرج میکنی، دیگر نمیخواهی سرنوشتت دست یک فروشندهٔ واحد باشد. تراشهٔ اختصاصی یعنی کنترل روی قیمت، روی موجودی و روی معماریای که دقیقاً برای کار خودت بهینه شده. مایا ۳۰۰ تازهترین حلقهٔ همین رقابت است.
مایا ۳۰۰ دقیقاً چه چیزی است؟
مایا ۳۰۰ سومین نسل از خانوادهٔ Azure Maia است؛ خانوادهای که مایکروسافت برای اجرای مدلهای هوش مصنوعی در دیتاسنترهای خودش طراحی میکند. اسکات گاتری، معاون اجرایی بخش ابر و هوش مصنوعی مایکروسافت، در پست رسمی وبلاگ مایکروسافت آن را یک «سیستم هوشمند کامل» توصیف کرد: ساختهشده برای استدلال با زمینهٔ طولانی، گفتوگوهای حساس به تأخیر و کارهای چندمرحلهای ایجنتها.
مشخصات تراشه
قلب مایا ۳۰۰ یک طراحی «چیپلت» است؛ یعنی بهجای یک تراشهٔ یکپارچهٔ غولپیکر، چند تراشهٔ کوچکتر کنار هم قرار میگیرند که هر کدام یک کار را انجام میدهند: یکی محاسبه، یکی کنترل حافظه و یکی ورودیخروجی. چیپلت محاسباتی با فرایند N2P شرکت TSMC ساخته میشود؛ یعنی نسل ۲ نانومتری که از پیشرفتهترین فرایندهای تولید تراشه در جهان است. مزیتی که مایکروسافت از این طراحی میگیرد این است که فقط بخش محاسباتی روی فرایند گرانقیمت ساخته میشود و بقیهٔ بخشها روی فرایندهای ارزانتر؛ هم کارایی بالاتر میرود، هم هزینهٔ ساخت کنترل میشود.
از نظر عددی، هر تراشه ۸ استک حافظهٔ HBM4 دارد: ۲۸۸ گیگابایت حافظه با پهنای باند ۱۸ ترابایت بر ثانیه، در یک پاکت حرارتی ۹۵۰ واتی. توان محاسباتی هم ۱۳.۸ پتافلاپس در دقت پایین FP4 اعلام شده. اما خودِ مایکروسافت هم تأکید میکند که فلاپسِ خام، داستان واقعی استنتاج نیست؛ چیزی که برای پاسخگویی به شما تعیینکننده است، سرعت خواندن وزنهای مدل و حافظهٔ موقت (KV cache) است — و دقیقاً همینجاست که آن ۱۸ ترابایت بر ثانیه وارد بازی میشود.
رک ۹۶تایی و ابرپاد
مایا ۳۰۰ قرار نیست تکتک کار کند. هر رک ۹۶ شتابدهنده را در یک پاکت برقی ۱۶۷ کیلوواتی کنار هم مینشاند؛ در این مقیاس، کل رک ۲۷.۶ ترابایت حافظهٔ HBM و ۱.۷ پتابایت بر ثانیه پهنای باند تجمیعی دارد. مایکروسافت حتی از اتصال ۱۲۸ رک به هم حرف میزند: یک «ابرپاد» با ۱۲٬۲۸۸ شتابدهنده که با شبکهٔ پرسرعتِ مخصوص به هم وصلاند. این مقیاسهاست که کلمهٔ «چند گیگاوات» را معنا میکند: وقتی از گیگاوات حرف میزنیم، دیگر بحث چند سرور نیست؛ بحث نیروگاه برق است.
خنکسازی
رک ۱۶۷ کیلوواتی را نمیشود با فن خنک کرد. به گفتهٔ مایکروسافت، خنکسازی مایع بیش از ۸۰ درصد بار حرارتی رک را دفع میکند و بقیه با هوا خنک میشود. طراحی طوری است که هم میتواند به آب تأسیسات دیتاسنتر وصل شود و هم با مبدل حرارتی در محیط هواخنک کار کند. این جزئیات شاید برای شما خشک به نظر برسد، ولی برای کسی که دیتاسنتر میسازد، یعنی مایا ۳۰۰ را میشود واقعاً در دیتاسنترهای امروزی جا داد، نه فقط در آزمایشگاه.
اعداد مایکروسافت را با دقت بخوانیم
دو عدد تیتر خبرند و هر دو را باید با احتیاط خواند، چون هر دو ادعای خود مایکروسافتاند و هنوز بنچمارک مستقلی برایشان منتشر نشده.
تحلیلگران مستقل هم همین را میگویند: برای راستیآزمایی این عدد به بار کاری یکسان و اندازهگیری توان خروجی، تأخیر و کیفیت خروجی نیاز است. پس این عدد را یک «انتظار مهندسی» بدانید، نه یک نتیجهٔ آزمون.
عدد دوم: «تا ۷ برابر توان خروجی توکن در سطح رک نسبت به مایا ۲۰۰». این مقایسه با نسل قبلیِ خود مایکروسافت است و در پیکربندی کامل ۹۶ شتابدهندهای اندازه گرفته شده. یک تحلیل مستقل (CellCog) از روی مشخصات اعلامشده حساب کرده که پهنای باند حافظهٔ رک مایا ۳۰۰ حدود ۵.۱ برابر رک مایا ۲۰۰ است، پهنای باند حافظه به ازای هر وات تقریباً دو برابر شده و توان محاسباتی FP4 به ازای هر وات فقط حدود ۸ درصد رشد کرده. پیامش روشن است: مایا ۳۰۰ اول یک «تراشهٔ حافظه» است، بعد یک تراشهٔ محاسباتی.
مایکروسافت یک عدد سوم هم میدهد: بیش از ۲.۵ برابر کارایی به ازای هر وات نسبت به مایا ۲۰۰ در سطح رک. اگر این سه عدد را کنار هم بگذارید، تصویر این است: مایکروسافت دارد روی بهینهسازی کل سیستم — نرمافزار، سیلیکون، رک، شبکه و دیتاسنتر — شرط میبندد، نه فقط روی یک تراشهٔ سریعتر.
مایا ۳۰۰ در برابر مایا ۲۰۰
جدول زیر مشخصات اعلامشدهٔ دو نسل را کنار هم میگذارد؛ همهٔ اعداد از اعلامیههای رسمی مایکروسافتاند.
ویژگی | مایا ۲۰۰ | مایا ۳۰۰ |
|---|---|---|
تاریخ معرفی | ۲۶ ژانویهٔ ۲۰۲۶ | ۱۲ اکتبر ۲۰۲۶ |
فرایند ساخت | نسل ۳ نانومتری TSMC | نسل ۲ نانومتری TSMC (N2P) |
حافظه | ۲۱۶ گیگابایت HBM3e | ۲۸۸ گیگابایت HBM4 |
پهنای باند حافظه | ۷ ترابایت بر ثانیه | ۱۸ ترابایت بر ثانیه |
توان حرارتی تراشه | ۷۵۰ وات | ۹۵۰ وات |
معماری | اعلام نشده | چیپلت چندتراشهای (محاسبه، کنترلر حافظه و ورودیخروجی جدا) |
وضعیت استقرار | در حال بهرهبرداری تولیدی (آمریکا، اروپا، استرالیا) | برنامهٔ استقرار از ۲۰۲۷ |
جدول را اینطور بخوانید: جهش اصلی در حافظه است (۳۳ درصد ظرفیت بیشتر و حدود ۲.۵ برابر پهنای باند)، نه در توان خام محاسباتی؛ و مایا ۲۰۰ همین حالا دارد بار واقعی را میکشد، ولی مایا ۳۰۰ هنوز روی کاغذ و در برنامهٔ ۲۰۲۷ است.
چرا مایکروسافت میخواهد از صف انویدیا بیرون بزند؟
خبرگزاری CNBC خلاصهٔ ماجرا را یک جملهای نوشت: مایکروسافت میخواهد «عمدتاً به سیلیکون خودش» برای پاسخگویی به درخواستهای هوش مصنوعی تکیه کند، و این کار را از همین نسل سوم مایا شروع میکند. وقتی شرکتی در مقیاس مایکروسافت تصمیم میگیرد بار اصلی را از روی دوش انویدیا بردارد، یعنی دو چیز: اول اینکه صورتحساب خرید GPU دیگر قابلتحمل نیست، دوم اینکه کنترل زنجیرهٔ تأمین برایش از راحتیِ خرید آماده مهمتر شده.
این تصمیم در خلأ گرفته نشده. همان هفتهای که مایا ۳۰۰ معرفی شد، برادکام هشدار داد که محدودیت اصلی گسترش هوش مصنوعی دیگر «دسترسی به چیپ» نیست؛ محدودیتهای سرمایه و معماری سیستم است. ترجمهاش این است: مشکل دیگر خرید تراشه نیست، مشکل برق، ساختمان، خنکسازی و پولی است که باید برای همهٔ اینها خرج شود. مایکروسافت با مایا ۳۰۰ دارد دقیقاً به همین محدودیت حمله میکند: توکن بیشتر با همان برق.
ساتیا نادلا، مدیرعامل مایکروسافت، در پست لینکدینش این حرکت را «بزرگترین شرطبندی ما روی سیلیکون خودمان» خواند. و رویترز هم گزارش داد که مایکروسافت ممکن است سال آینده بیش از یک میلیون عدد از این چیپها را مستقر کند. اگر این عدد درست باشد، دیگر بحث یک پروژهٔ آزمایشی نیست؛ بحث جابهجایی صنعتی است.
برای کاربر کاپایلت و گیتهاب چه چیزی عوض میشود؟
مایکروسافت میگوید مایا ۳۰۰ بهمرور به سامانهٔ اصلی استنتاج محصولاتش تبدیل میشود: کدنویسی کارآمدتر با گیتهاب (کاپایلت)، استقرار منعطفتر مدلها از طریق Microsoft Foundry، و تعامل سریعتر با کاپایلت، تیمز و دراگون کاپایلت. اما این «بهمرور» مهم است: استقرار تولیدی مایا ۳۰۰ از ۲۰۲۷ شروع میشود، پس اگر امروز کاپایلت استفاده میکنید، فردا صبح هیچچیز عوض نمیشود.
در کوتاهمدت، خبر مهمتر برای شما مایا ۲۰۰ است: همین حالا دارد بارهای تولیدی واقعی را میکشد، از جمله مایکروسافت کاپایلت، و به گفتهٔ مایکروسافت تا پایان همین سال گیتهاب کاپایلت و Microsoft Foundry هم به آن اضافه میشوند. به گفتهٔ مایکروسافت، مایا ۲۰۰ برای قابلیتهای هوش مصنوعی داخلی تیمز، کاپایلت و کوورک تا ۱.۷ برابر توکن بیشتر به ازای هر وات نسبت به زیرساخت GPUای میدهد.
اگر توسعهدهندهاید و روی APIها محصول میسازید، این روند را جدی بگیرید: وقتی غولها هزینهٔ استنتاج را پایین میآورند، قیمت APIها هم بهمرور رقابتیتر میشود. در همین زمینه بد نیست نگاهی هم به بررسی Decisions API اوپنایآی بیندازید که نشان میدهد بازی قیمتگذاری APIها به کدام سمت میرود.
چرا همهچیز حول حافظه میچرخد؟
اگر یک نکتهٔ فنی از این مطلب ببرید، همین است: در استنتاج مدلهای زبانی، گلوگاهِ واقعی حافظه است، نه محاسبه. وقتی مدل دارد جواب میدهد، مدام باید وزنهای خودش و حافظهٔ موقت گفتوگو را بخواند؛ هرچه متن طولانیتر و هرچه ایجنت قدمهای بیشتری بردارد، این خواندنها بیشتر میشود. برای همین مایکروسافت ۸ استک HBM4 روی هر تراشه گذاشته و برای همین تحلیلگران میگویند مایا ۳۰۰ اول یک تراشهٔ حافظه است.
HBM یعنی چه؟
HBM یعنی «حافظهٔ با پهنای باند بالا»؛ نوعی حافظه که بهصورت لایهلایه روی هم سوار میشود و مستقیم کنار تراشه مینشیند تا داده با سرعت باورنکردنی جابهجا شود. HBM4 نسل تازهٔ همین فناوری است. برای مقیاس ذهنی: ۱۸ ترابایت بر ثانیه یعنی در هر ثانیه میشود معادل چند هزار فیلم سینمایی را از حافظه خواند. این عددها برای خوانندهٔ عادی شاید انتزاعی باشند، ولی برای کسی که مدل ۷۰ میلیارد پارامتری اجرا میکند، فرق بین «کار میکند» و «کار نمیکند» است.
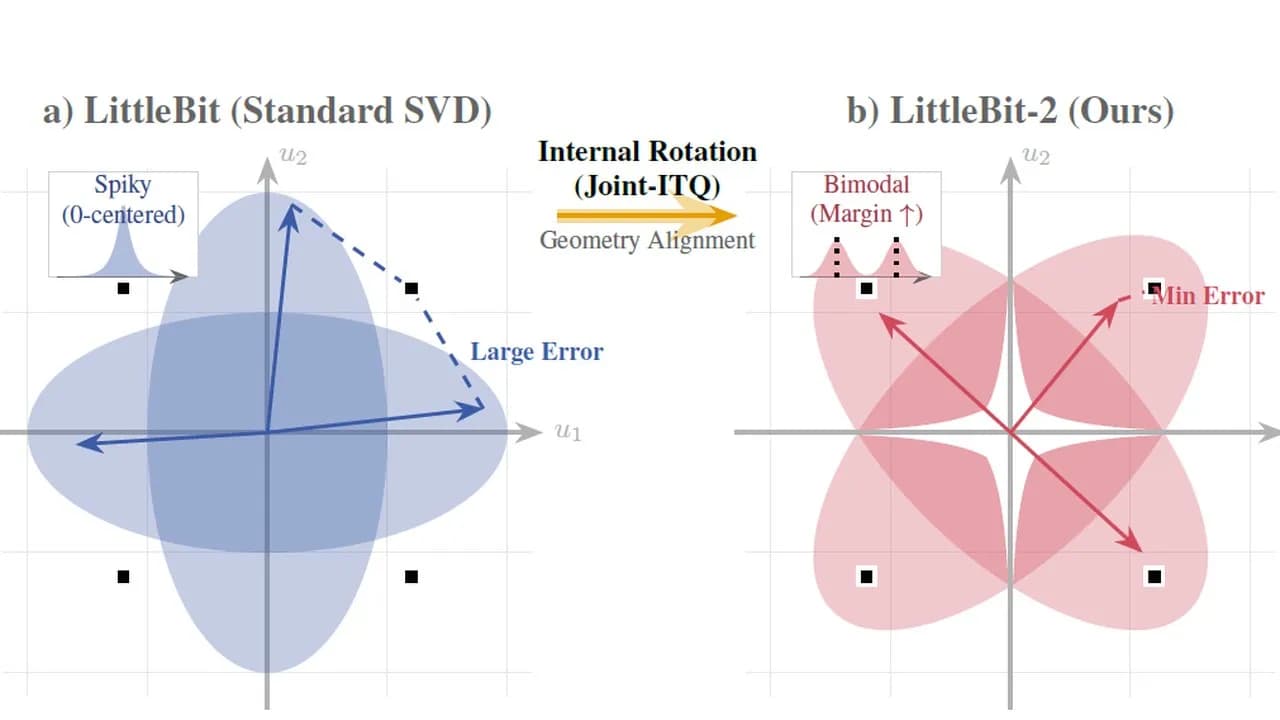
جالب اینجاست که بحران حافظه فقط با سختافزار حل نمیشود. همین دیروز در فناوریکده از فشردهسازی زیر یک بیت LittleBit-2 سامسونگ نوشتیم؛ روشی نرمافزاری که مدلها را تا ۰.۱ بیت به ازای هر وزن کوچک میکند. مایا ۳۰۰ و LittleBit-2 دو پاسخ متفاوت به یک سؤالاند: چطور با حافظهٔ محدود، مدلهای بزرگتر را اجرا کنیم؟ یکی با سیلیکون، یکی با ریاضی.
چیزهایی که هنوز روشن نیست
صداقت خبری ایجاب میکند بگوییم چه چیزهایی را نمیدانیم:
بنچمارک مستقل: همهٔ اعداد این مطلب — ۴۰ درصد، ۷ برابر، ۲.۵ برابر — ادعای خود مایکروسافتاند. تا وقتی یک نهاد مستقل با بار کاری مشخص این تراشه را نیازماید، این اعداد را باید با احتیاط خواند.
قیمت تمامشده: مایکروسافت دربارهٔ هزینهٔ ساخت هر تراشه یا اثر آن روی قیمت اشتراکها چیزی نگفته. تراشهٔ اختصاصی لزوماً بهمعنای سرویس ارزانتر برای شما نیست؛ ممکن است فقط حاشیهٔ سود مایکروسافت را بالا ببرد.
جزئیات معماری: از «معماری دیتافلوی نرمافزارمحور» و «بهینهسازی کرنل با کمک هوش مصنوعی» حرف زده شده، ولی جزئیات فنی عمیق — مثل تحلیلهای مستقلی که برای تراشههای انویدیا منتشر میشود — هنوز در دسترس نیست.
فروش به بیرون: مایا ۳۰۰ مثل TPU گوگل یک محصول فروشی نیست؛ زیرساخت داخلی مایکروسافت است. پس اگر مدیر دیتاسنترید و دلتان برای این رکها ضعف رفته، باید ناامیدتان کنم: فقط مشتری آژور میتوانید باشید، نه خریدار تراشه.
دسترسی، محدودیتها و وضعیت برای کاربر ایرانی
راستش را بخواهید: مایا ۳۰۰ تراشهای نیست که شما بخرید. این زیرساخت داخلی مایکروسافت است و اثرش روی شما غیرمستقیم میآید — از طریق سرعت و قیمت سرویسهایی مثل کاپایلت و آژور. و همین سرویسها هم داستان خودشان را در ایران دارند: بسیاری از سرویسهای مایکروسافت از جمله آژور و کاپایلت در ایران بهصورت رسمی عرضه نمیشوند و مشمول تحریماند. پس اگر در ایران هستید، خبر مایا ۳۰۰ را بیشتر باید بهعنوان «جهت صنعت» خواند تا «خبری که فردا زندگیتان را عوض میکند».
یک نکتهٔ مهم دربارهٔ تحریم: شرایط دسترسی را همانطور که هست میگوییم و راهی برای دور زدن تحریم پیشنهاد نمیدهیم. اگر برای کار به این سرویسها نیاز دارید، مسیر قانونی و رسمی را از مشاور حقوقی بپرسید، نه از مقالهٔ خبری.
نکتهای برای خوانندهٔ فارسیزبان
حالا سه کار عملی که میتوانید با این خبر بکنید:
اگر توسعهدهندهاید و محصولتان روی APIهای هوش مصنوعی سوار است، هزینهٔ استنتاج را در معماریتان یک متغیر جدی بگیرید، نه یک عدد ثابت. روند نزولی قیمت توکن — که مایا ۳۰۰ نماد آن است — یعنی مدلی که امروز گران تمام میشود، سال آینده ممکن است اقتصادی شود. طراحیتان را طوری بچینید که با عوض شدن قیمت، مجبور به بازنویسی نشوید.
اگر ایجنت هوش مصنوعی میسازید یا با آنها کار میکنید، بدانید که نسل بعدی زیرساخت دقیقاً برای کار شما بهینه میشود: زمینهٔ طولانی و کارهای چندمرحلهای. ورکفلوهای پویای کلاد برای ایجنتها را ببینید تا حس کنید این موج نرمافزاری و سختافزاری چطور همزمان پیش میروند.
اگر دانشجویید یا تازه وارد دنیای هوش مصنوعی شدهاید، دنبال کردن همین خبرها — نه فقط مدلها، بلکه زیرساخت پشتشان — بهترین راه برای فهمیدن این است که صنعت واقعاً به کدام سمت میرود. مدلها میآیند و میروند؛ کسی که برق و سیلیکون را کنترل کند، قیمت را تعیین میکند.
و اگر صرفاً کنجکاوید: این موج فقط مایکروسافت نیست. از شرکت رگنای اونداس و پلنتیر برای هوش مصنوعی حاکمیتی تا TPU گوگل، همه دارند یک درس را یاد میگیرند: در عصر هوش مصنوعی، زیرساختِ خودت را داشته باش.
جمعبندی
مایا ۳۰۰ مهم است، اما نه به دلیلی که تیترها میگویند. عدد ۴۰ درصد و ۷ برابر، فعلاً ادعای مایکروسافتاند و تا آزمون مستقل، همان ادعا میمانند. چیزی که واقعاً مهم است، «جهت» است: مایکروسافت دارد رسماً و با مقیاس چند گیگاواتی از صف خرید انویدیا بیرون میزند، و این یعنی نبرد بعدی هوش مصنوعی نه بر سر «چه مدلی»، که بر سر «هر توکن چند» است. اگر کاربر سرویسهای مایکروسافتید، در یکی دو سال آینده منتظر سرویسهای سریعتر و احتمالاً رقابتیتر باشید — ولی عجله نکنید، چون استقرار از ۲۰۲۷ شروع میشود. اگر هم ناظر صنعتید، این خبر را زنگ خطری برای انحصار انویدیا بدانید، نه مرگش: انویدیا هنوز فروشندهٔ همهٔ بقیه است.
پرسشهای متداول
مایا ۳۰۰ دقیقاً چه زمانی عرضه میشود؟
مایکروسافت گفته استقرار تولیدی مایا ۳۰۰ از سال ۲۰۲۷ آغاز میشود و از همان زمان، خانوادهٔ مایا به استقرارهای چند گیگاواتی میرسد. پس این یک محصولِ «امروز» نیست؛ یک برنامهٔ ۲۰۲۷ است.
آیا میتوانم تراشهٔ مایا ۳۰۰ را بخرم؟
نه. مایا ۳۰۰ زیرساخت داخلی مایکروسافت است و فروخته نمیشود. شما فقط میتوانید از سرویسهایی که روی آن اجرا میشوند — مثل کاپایلت و آژور — استفاده کنید.
مایا ۳۰۰ با پردازندههای انویدیا چه فرقی دارد؟
پردازندههای انویدیا همهمنظورهاند و به همه فروخته میشوند؛ مایا ۳۰۰ اختصاصی مایکروسافت است و فقط برای استنتاج در سرویسهای خودش بهینه شده. هدف مایکروسافت کمکردن وابستگی به خرید از انویدیا و پایین آوردن هزینهٔ هر توکن است، نه فروش تراشه.
ادعای ۴۰ درصد توکن بیشتر به ازای هر مگاوات چقدر معتبر است؟
این عدد ادعای خود مایکروسافت است؛ نه سیستم GPUایِ مقایسهشده نام برده شده، نه بار کاری مشخصی اعلام شده و نه بنچمارک مستقلی منتشر شده. آن را یک انتظار مهندسی بدانید تا وقتی آزمون مستقل بیاید.
مایا ۲۰۰ الان کجای کار است؟
مایا ۲۰۰، نسل قبلی، همین حالا در دیتاسنترهای آمریکا، اروپا و استرالیا بار تولیدی واقعی میکشد — از جمله مایکروسافت کاپایلت — و به گفتهٔ مایکروسافت تا پایان ۲۰۲۶ گیتهاب کاپایلت و Microsoft Foundry هم به آن اضافه میشوند.
این خبر برای کاربران ایرانی چه معنایی دارد؟
اثر مستقیم ندارد، چون هم تراشه فروخته نمیشود و هم بسیاری از سرویسهای مایکروسافت در ایران رسمی نیستند. ارزشش برای خوانندهٔ ایرانی، فهم جهت صنعت است: هزینهٔ استنتاج دارد پایین میآید و این روی قیمت APIها و سرویسهای جهانی اثر میگذارد.
رقیبهای مایا ۳۰۰ چه کسانیاند؟
در درجهٔ اول پردازندههای انویدیا که مایکروسافت میخواهد از آنها فاصله بگیرد، و در درجهٔ دوم تراشههای اختصاصی بقیهٔ غولها: TPU گوگل، Trainium آمازون و MTIA متا. هر چهار شرکت دارند یک بازی را میکنند: کنترل هزینهٔ استنتاج.
منابع
مرکز خبری مایکروسافت: معرفی مایا ۳۰۰، نسل بعدی تراشهٔ هوش مصنوعی اختصاصی (۱۲ اکتبر ۲۰۲۶)
CNBC: مایکروسافت عمدتاً به چیپهای مایا برای استنتاج هوش مصنوعی تکیه میکند (۱۲ اکتبر ۲۰۲۶)
DataCenter Dynamics: رونمایی از Azure Maia 300؛ تبدیل شدن به سامانهٔ اصلی استنتاج (۱۲ اکتبر ۲۰۲۶)
وبلاگ فناوری IEEE ComSoc: تحلیل فنی شتابدهندهٔ مایا ۳۰۰ مایکروسافت (۱۲ اکتبر ۲۰۲۶)
CellCog: مشخصات مایا ۳۰۰ و تحلیل ادعای ۴۰ درصدی (۱۲ اکتبر ۲۰۲۶)
Mobile World Live: رونمایی مایکروسافت از تراشهٔ اختصاصی مایا ۳۰۰ (۱۲ اکتبر ۲۰۲۶)