فهرست مطالب
یازدهلبز سهشنبه ۲۸ مهر (۲۰ اکتبر ۲۰۲۶) خانوادهٔ «Eleven Realtime» را معرفی کرد: دو مدل speech-to-speech که شنیدن، فهمیدن، نوبتگرفتن در گفتوگو و جوابدادن را — کاری که تا دیروز سه قطعهٔ جداگانه انجام میدادند — در یک مدل واحد جمع میکنند. نسخهٔ قویتر، مکس، در آزمون گفتاری Big Bench Audio به دقت ۹۸٫۸٪ رسیده و بهطور میانگین فقط ۰٫۵۷ ثانیه بعد از تمام شدن حرف شما شروع به صحبت میکند.
این خبر فقط «یک مدل صوتی دیگر» نیست. یازدهلبز دارد سختترین بخش ایجنتهای صوتی را حذف میکند: سیمکشی بین قطعهها. در ادامه میبینید این دو مدل دقیقاً چه فرقی با هم دارند، عددهای بنچمارک را چطور باید خواند (و کجایش ادعای شرکت است)، قیمت واقعیشان در عمل چقدر درمیآید، و اگر امروز بخواهید شروع کنید، از کجا.
پاسخ کوتاه
Eleven Realtime دو مدل speech-to-speech است: مینی برای گفتوگوی روزمره و ارزان (دستیار، معلم، کاراکتر تعاملی) و مکس برای کارهای جدیتر (پشتیبانی مشتری، فرایندهای چندمرحلهای با فراخوانی ابزار).
دقت گفتاری: مکس در آزمون Big Bench Audio — هزار سؤال گفتاری که مدل باید بشنود و جواب بدهد — ۹۸٫۸٪ گرفت؛ مینی ۷۵٫۹٪. این عددها را مؤسسهٔ Artificial Analysis اندازه گرفته و در بستهٔ خبری خود شرکت منتشر شده است.
تأخیر: شروع صدا بهطور میانگین ۰٫۵۷ ثانیه بعد از حرف شما برای مکس و ۰٫۶۲ ثانیه برای مینی.
پوشش: بیش از ۹۰ زبان (از جمله فارسی) و دسترسی به بیش از ۱۷ هزار صدای آمادهٔ کتابخانهٔ یازدهلبز.
دو راه استفاده: پلتفرم آمادهٔ ElevenAgents بدون حتی یک خط کد، یا API سازگار با پروتکل اوپنایآی که مهاجرت از ایجنت فعلیتان را به عوض کردن دو چیز در کد تقلیل میدهد.
اول زمینه: «گفتاربهگفتار» یعنی چه؟
تا امروز برای اینکه یک هوش مصنوعی با شما حرف بزند، معمولاً سه مدل جدا پشت سر هم کار میکردند. اول یک مدل «گفتاربهمتن» — یعنی چیزی که صدای شما را به نوشته تبدیل میکند — حرفهایتان را میشنید. بعد یک مدل زبانی به آن نوشته جواب میداد. و در آخر یک مدل «متنبهگفتار» جواب را با صدا میخواند. هر دستبهدست شدن بین این سه قطعه، هم کمی تأخیر اضافه میکرد و هم کمی خطا.
چرا ایجنتهای صوتی قدیمی «رباتی» حس میشدند؟
مشکل فقط تأخیر نبود. هر قطعه جداگانه آموزش دیده بود و از نیت کلی گفتوگو خبر نداشت؛ مثل سه نفری که هر کدام فقط تکهٔ کار خودشان را میدانند و با یادداشت به هم پیام میدهند. نتیجه مکثهای مصنوعی، قطع کردن حرف طرف مقابل در جای اشتباه، و لحنی بود که «خواندهشده» حس میشد نه «گفتهشده».
چرا نیمثانیه تأخیر اینقدر مهم است؟
در گفتوگوی واقعی، آدمها معمولاً با مکثی کوتاه — چیزی در حد چند دهم ثانیه — جواب هم را میدهند. وقتی تأخیر ایجنت از حدود یک ثانیه بیشتر میشود، مغز شما ناخودآگاه ثبت میکند که «طرف مقابل دارد فکر میکند» یا بدتر، «قطع شده». به همین دلیل است که در دنیای ایجنت صوتی، هر دهم ثانیه یک مزیت رقابتی حساب میشود و عدد ۰٫۵۷ ثانیهٔ مکس تیتر خبرها شد.
Eleven Realtime دقیقاً چه چیزی معرفی کرد؟
یازدهلبز میگوید دیگر لازم نیست خودتان آن سه قطعه را به هم بچسبانید. Eleven Realtime یک مدل واحد است که گوشدادن، فهمیدن، تصمیمگیری دربارهٔ «کی نوبت حرف زدن من است» و تولید صدا را یکجا انجام میدهد — و چون یکپارچه آموزش دیده، هر بخش از نیت کلی گفتوگو باخبر است. خود شرکت حرفش را اینطور خلاصه کرد: «نباید برای ساخت یک ایجنت صوتیِ طبیعی، متخصص پیکربندی شوی.»
دو نسخه: مینی و مکس
خانواده دو عضو دارد و تقسیم کارشان روشن است. مینی برای جاهایی ساخته شده که «روان بودن گفتوگو» مهمتر از «عمیق بودن جواب» است: دستیار شخصی، معلم خصوصی، کاراکتر تعاملی در بازی. نکتهٔ جالبش این است که به گفتهٔ یازدهلبز، مینی میفهمد شما حرفتان تمام شده یا فقط دارید «مم-هم» میگویید — یعنی همان نوبتگیری طبیعی که ایجنتهای قدیمی در آن لنگ میزدند.
مکس نسخهای است که قبل از جواب دادن «فکر میکند»: برای پشتیبانی مشتری، ارزیابی سرنخهای فروش و هر کاری که ایجنت باید چند قدم پشت سر هم بردارد و وسطش از ابزارها — مثل چک کردن سفارش یا رزرو نوبت — استفاده کند. اگر مینی «خوشبرخورد» است، مکس «خوشبرخوردِ دقیق» است.
مینی در برابر مکس؛ کدام به درد شما میخورد؟
جدول زیر همهٔ عددهای کلیدی را کنار هم میگذارد. منبع عددهای عملکرد، ارزیابی مستقل مؤسسهٔ Artificial Analysis است که در مواد خبری خود یازدهلبز منتشر شده؛ منبع قیمتها هم صفحهٔ قیمتگذاری رسمی شرکت (به گزارش رسانهها در ۲۱ اکتبر).
| مینی (v1 Mini) | مکس (v1 Max) |
|---|---|---|
بهترین کاربرد | دستیار، معلم، کاراکتر تعاملی | پشتیبانی مشتری، فرایندهای چندمرحلهای |
دقت گفتاری (Big Bench Audio) | ۷۵٫۹٪ | ۹۸٫۸٪ |
تأخیر تا شروع صدا | ۰٫۶۲ ثانیه | ۰٫۵۷ ثانیه |
موفقیت در فراخوانی ابزار | ۶۰٫۳٪ | ۸۷٫۱٪ |
گفتوگوی دوطرفه (Full-Duplex) | ۹۵٫۸٪ | ۹۴٫۱٪ |
امتیاز Speech Agent Arena | ۹۸۸ | ۹۹۸ |
برآورد هزینهٔ هر دقیقه مکالمه | حدود ۸٫۴ سنت | حدود ۱۰٫۲ سنت |
جدول را اینطور بخوانید: اگر برایتان «طبیعی حرف زدن» مهم است، مینی نهتنها کافی است، بلکه در نوبتگیری گفتوگو حتی کمی از مکس بهتر ظاهر شده. اما اگر ایجنت شما باید «کار را درست انجام دهد» — جواب دقیق بدهد و ابزارها را درست صدا بزند — اختلاف ۲۳ واحد درصدی در دقت گفتاری و ۲۷ واحد درصدی در فراخوانی ابزار، مکس را به انتخاب روشن تبدیل میکند.
بنچمارکها؛ عددها را با ذرهبین بخوان
عدد ۹۸٫۸٪ بهتنهایی چیزی نمیگوید مگر اینکه بدانید آزمون چه بوده و رقبا کجا ایستادهاند. بگذارید سه عدد اصلی را باز کنیم.
Big Bench Audio چیست و ۹۸٫۸٪ یعنی چه؟
این آزمون را مؤسسهٔ Artificial Analysis طراحی کرده: هزار سؤال بهصورت گفتاری پخش میشود، مدل باید آنها را بشنود، بفهمد و با صدا جواب درست بدهد — یعنی «استدلال شنیداری»، نه فقط رونویسی. دقت ۹۸٫۸٪ یعنی مکس از هر هزار سؤال، ۹۸۸ تا را درست جواب داده و فقط ۱۲ تا را اشتباه کرده. برای مقیاس: مینی در همین آزمون ۷۵٫۹٪ گرفت، یعنی تقریباً از هر چهار سؤال یکی را اشتباه جواب داد.
رتبه در میان رقبا
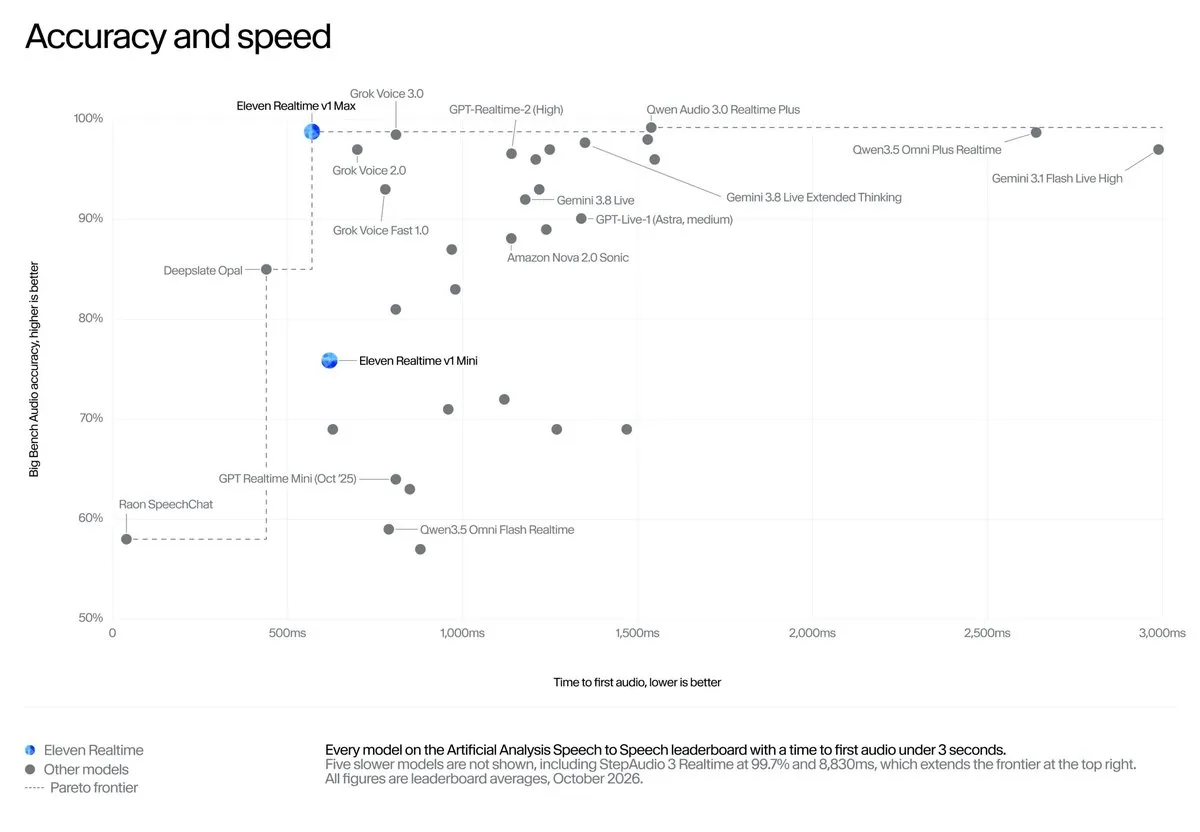
در میان ۴۳ مدلی که Artificial Analysis ارزیابی کرده، مکس سوم است: پشت StepAudio 3 Realtime با ۹۹٫۷٪ و Qwen Audio 3.0 Realtime Plus با ۹۹٫۲٪، و جلوتر از Grok Voice 3.0 با ۹۸٫۵٪ و Gemini 3.8 Live با ۹۷٫۷٪. نمودار زیر — تصویر رسمی خود یازدهلبز از لیدربورد — نشان میدهد مکس دقیقاً کجا ایستاده: گوشهٔ بالا-چپ، جایی که هم دقت بالاست هم تأخیر کم.
تأخیر ۰٫۵۷ ثانیه یعنی چه؟
یعنی از لحظهای که شما ساکت میشوید تا لحظهای که صدای ایجنت شروع میشود، بهطور میانگین کمی بیشتر از نیم ثانیه میگذرد. در عمل، این همان مکثی است که در یک تماس تلفنی عادی هم بین دو نفر پیش میآید و «طبیعی» حس میشود. برای مقایسه: Grok Voice 3.0 حدود ۰٫۸۱ ثانیه و نسخهٔ قوی GPT-Realtime حدود ۱٫۱۴ ثانیه تأخیر دارند. ادعای یازدهلبز این است که در لیدربورد Artificial Analysis هیچ مدلی همزمان هم سریعتر و هم دقیقتر از مکس نیست — این جمله ادعای خود شرکت است، نه نتیجهٔ داوری مستقل.
یک صداقت لازم
این تستها را Artificial Analysis — یک مرجع مستقل بنچمارک — اجرا کرده، اما در بستهٔ خبری لانچ خود یازدهلبز منتشر شدهاند. ما این مدلها را خودمان تست نکردهایم و عددها را همانطور که شرکت گزارش کرده نقل میکنیم. اگر ایجنت صوتی برای محصول شماست، هیچ بنچمارکی جای تست با مکالمههای واقعی مشتریهای خودتان را نمیگیرد.
چطور شروع کنی؛ از ایده تا ایجنت صوتی
خبر خوب لانچ این است که لازم نیست برای امتحان کردنش متخصص زیرساخت باشید. دو مسیر وجود دارد؛ یکی را انتخاب کنید.
مسیر اول: بدون کد، با ElevenAgents
اگر برنامهنویس نیستید یا فقط میخواهید سریع نمونه بسازید، پلتفرم آمادهٔ شرکت همین کار را میکند:
در سایت یازدهلبز حساب کاربری بسازید و وارد بخش ElevenAgents شوید.
یک ایجنت جدید بسازید و مدلش را انتخاب کنید: مینی برای گفتوگوی روان، مکس برای کارهای دقیق.
از میان بیش از ۱۷ هزار صدای آماده، صدای ایجنت را انتخاب کنید — یا صدای خودتان را کلون کنید.
به ایجنت «دانش» بدهید (مثلاً فایل راهنمای محصول) و ابزارهایش را مشخص کنید (مثلاً دسترسی به سیستم رزرو).
منتشرش کنید: روی وبسایت بهصورت ویجت، روی خط تلفن، در واتساپ یا داخل سیستمهای پشتیبانی مثل Zendesk.
کل این مسیر بدون نوشتن کد انجام میشود و برای تست ایده، سریعترین راه است.
مسیر دوم: API برای توسعهدهندهها
اگر محصول خودتان را دارید، Realtime API از طریق WebSocket در دسترس است — با یک نکتهٔ هوشمندانه: پروتکل آن با Realtime API اوپنایآی سازگار است. یعنی اگر قبلاً ایجنت صوتیتان را با API اوپنایآی ساختهاید، برای مهاجرت فقط «آدرس endpoint» و «نام مدل» را در کد عوض میکنید و همان SDK اوپنایآی بدون تغییر کار میکند. دو استثنا را بدانید: WebRTC در زمان لانچ پشتیبانی نمیشود (اگر یکپارچهسازی WebRTC دارید، اول باید transport را عوض کنید) و دسترسی به API بهتدریج و workspaceبهworkspace باز میشود — پس ممکن است امروز برای حساب شما فعال نباشد.
قیمتها؛ یک دقیقه مکالمه چقدر تمام میشود؟
قیمتگذاری دو بخش دارد: «صدای متصل» که دقیقهای حساب میشود، و «توکنها» که جدا. جدول زیر نرخهای رسمی صفحهٔ قیمتگذاری یازدهلبز است (به گزارش رسانهها در ۲۱ اکتبر ۲۰۲۶):
| مینی | مکس |
|---|---|---|
صدای متصل، هر دقیقه | ۰٫۰۸ دلار | ۰٫۰۸ دلار |
توکن ورودی، هر یک میلیون | ۰٫۲۰ دلار | ۱٫۸۰ دلار |
توکن خروجی، هر یک میلیون | ۶ دلار | ۹ دلار |
دقیقهٔ مازاد بالای سقف همزمانی | ۰٫۱۶ دلار | ۰٫۱۶ دلار |
برآورد هر دقیقه مکالمهٔ واقعی* | حدود ۸٫۴ سنت | حدود ۱۰٫۲ سنت |
جدول را اینطور بخوانید: هزینهٔ دقیقهایِ پایه برای هر دو مدل یکی است و تفاوت اصلی در توکنهاست — مکس برای ورودی ۹ برابر گرانتر است. ستارهٔ آخر جدول برآورد تحلیلگران است، چون خود شرکت نگفته هر دقیقه مکالمه چند توکن مصرف میکند؛ رقم تومان را اینجا اختراع نمیکنیم. برای مقیاس عملی: خود یازدهلبز برآورد میکند پلن Pro با ماهی ۹۹ دلار، در استفادهٔ معمولی حدود ۹۷۱ دقیقه مکالمه با مکس (یا ۱٬۱۷۹ دقیقه با مینی) پوشش میدهد — یعنی یک تیم پشتیبانی کوچک، با یک اشتراک ماهانه حدود هزار دقیقه مکالمهٔ دقیق دارد.
Eleven Realtime در برابر جایگزینها
بازار ایجنت صوتی این روزها شلوغ است و انتخاب شما فقط «بهترین مدل» نیست؛ «بهترین معماری برای کار شما» است. جدول زیر تصویر کلی را نشان میدهد:
| Eleven Realtime | Mistral Voxtral 3 | OpenAI Realtime API | Grok Voice 3.0 |
|---|---|---|---|---|
معماری | یک مدل یکپارچه | پایپلاین ماژولار + SDK | API بلادرنگ یکپارچه | speech-to-speech |
نقطهٔ قوت | سادگی + دقت گفتاری بالا | اجرا روی زیرساخت خودتان | اکوسیستم بزرگ و سازگاری | دقت نزدیک به مکس (۹۸٫۵٪) |
به درد چه کسی میخورد | شروع سریع بدون سیمکشی | تیمهایی که کنترل کامل میخواهند | کسانی که از قبل در اکوسیستم اوپنایآیاند | کسانی که هزینهٔ مشابه با دقت بالا میخواهند |
نتیجهٔ عملی: اگر سرعت شروع برایتان مهم است، مدل یکپارچهٔ یازدهلبز کمترین اصطکاک را دارد. اما اگر میخواهید هر قطعه را جدا کنترل کنید — مثلاً رونوشت میانی را خودتان پردازش کنید — رویکرد ماژولار میسترال که صبح امروز جزئیاتش را پوشش دادیم و امکان اجرا روی زیرساخت خودتان را میدهد، دستتان را بازتر میگذارد. آموزش قدمبهقدم ساخت دستیار صوتی با وکسترال ۳ هم برای مقایسهٔ عملی مسیر توسعه مفید است.
بهای سادگی: کنترل کمتر
انتخاب مدل یکپارچه خنثی نیست. در پایپلاین سهتکه میتوانید هر قطعه را جدا عوض کنید — مثلاً فقط سنتز صدا را — یا روی رونوشت میانی پردازش اضافه کنید. در مدل یکپارچه، تأخیر و پیچیدگی کم میشود اما همین آزادیها را از دست میدهید: کسانی که میخواهند وسط جریان صدا را عوض کنند یا روی متن میانی دخالت کنند، گزینههای کمتری دارند. این را از اول بدانید تا بعداً غافلگیر نشوید.
محدودیتهایی که باید بدانید
همهجا و برای همهچیز نیست
چند محدودیت استقرار را خود شرکت اعلام کرده: مکس در محیطهای «دیتا-رزیدنسی» هند و سنگاپور عرضه نشده — یعنی دادهٔ شما در آن مناطق پردازش نمیشود، نه اینکه کاربر آن کشورها کلاً محروماند. مینی هم حالتهای Zero Retention (عدم نگهداری داده) و HIPAA را ندارد؛ این حالتها فقط برای مکس و در آمریکا و اروپا فعالاند. اگر کسبوکارتان در حوزهٔ سلامت یا دادهٔ حساس است، این جزئیات قبل از انتخاب مدل حیاتیاند.
حریم خصوصی صدا
صدای مشتریهای شما دادهٔ حساس است. یازدهلبز میگوید محل پردازش داده به محیط دیتای انتخابی شما بستگی دارد، ولی جزئیات قرارداد سازمانی (DPA و SLA) فقط در پلنهای سازمانی میآید. اگر ایجنت شما قرار است با اطلاعات واقعی مشتری کار کند، قبل از استقرار نهایی، بندهای حریم خصوصی قرارداد را با تیم حقوقیتان مرور کنید — نه بعد از آن.
چیزهایی که هنوز روشن نیست
چند نکته هنوز باز است: محاسبهٔ دقیق توکن در پلنهای اشتراکی شفاف نیست؛ دسترسی API هنوز برای همه باز نشده؛ و آزمون τ-Voice مؤسسهٔ Artificial Analysis هنوز روی این مدلها اجرا نشده، پس امتیاز کلی «شاخص speech-to-speech» برایشان ثبت نشده. اینها را میگوییم چون خبر کامل، خبری است که بگوید چه چیزی را نمیداند.
برای خوانندهٔ فارسیزبان چه معنایی دارد؟
دو خبر خوب و یک هشدار. خبر خوب اول: فارسی در فهرست زبانهای تحتپوشش مدلهای گفتاری یازدهلبز هست، پس ساخت ایجنت فارسیزبان از نظر فنی ممکن است — هرچند کیفیت فارسی را حتماً خودتان با چند مکالمهٔ واقعی تست کنید، چون عددهای بنچمارک بیشتر روی انگلیسی متمرکزند. خبر خوب دوم: با پشتیبانی از بیش از ۹۰ زبان، همین یک ایجنت میتواند همزمان به مشتری فارسیزبان و انگلیسیزبان جواب بدهد؛ برای استارتاپهایی که بازار چندزبانه دارند، این یعنی یک ایجنت بهجای چند ایجنت.
و هشدار: یازدهلبز مانند بسیاری از سرویسهای آمریکایی، در شرایط استفادهاش محدودیتهایی برای مناطق تحت تحریم دارد. اگر از ایران قصد استفاده دارید، قبل از هر برنامهریزی وضعیت دسترسی را از صفحهٔ رسمی شرکت چک کنید؛ ما در فناوری کده راه دور زدن تحریم را توصیه نمیکنیم.
جمعبندی: حالا چه کار کنی؟
اگر توسعهدهندهاید و ایجنت صوتی در نقشهٔ محصولتان است، همین هفته با مینی روی ElevenAgents یک نمونه بسازید و آن را به چند مکالمهٔ واقعی — نه سناریوی نمایشی — بسپرید؛ عددهای بنچمارک جای تست واقعی را نمیگیرند و تفاوت مینی و مکس را فقط در کار خودتان میفهمید. اگر فقط کنجکاوید، عجله نکنید: دسترسی API هنوز کامل باز نشده و بازار دارد هر هفته داغتر میشود — انتخاب فروشنده را به وقتی موکول کنید که همهٔ گزینهها روی میز باشند.
اگر برای ایجنت صوتی یا ویدیوی خود به صدای محیط و افکت هم نیاز دارید، الونلبز ابزار تازهای برای این کار دارد: مدل SFX v3 که چند صدا را در یک درخواست میسازد. جزئیاتش را در SFX v3 الونلبز؛ ساخت افکت صوتی با هوش مصنوعی بخوانید.
پرسشهای متداول
Eleven Realtime با Eleven v4 چه فرقی دارد؟
Eleven v4 یک مدل «متنبهگفتار» است: به آن متن میدهید و صدا تحویل میگیرید. Eleven Realtime یک «ایجنت کامل» است: خودش گوش میدهد، میفهمد و جواب میدهد. بررسی Eleven v4 را قبلاً منتشر کردهایم؛ اگر کار شما تولید صدا از متن است همان کافی است، اگر مکالمهٔ زنده میخواهید سراغ Realtime بروید.
برای ساخت ایجنت صوتی حتماً باید برنامهنویس باشم؟
نه. پلتفرم ElevenAgents بدون حتی یک خط کد ایجنت میسازد و روی وبسایت، تلفن و واتساپ منتشرش میکند. API فقط برای کسانی است که میخواهند ایجنت را عمیقاً داخل محصول خودشان ببرند.
هزینهٔ یک مکالمهٔ دهدقیقهای چقدر میشود؟
طبق برآوردهای مبتنی بر قیمت رسمی، حدود ۸۴ سنت با مینی و حدود ۱٫۰۲ دلار با مکس — یعنی تقریباً قیمت یک تماس تلفنی معمولی. رقم دقیق به میزان توکن مصرفی بستگی دارد که شرکت شفاف اعلام نکرده.
فارسی را پشتیبانی میکند؟
بله؛ فارسی در فهرست زبانهای تحتپوشش مدلهای گفتاری یازدهلبز قرار دارد. با این حال کیفیت و طبیعی بودن فارسی را حتماً خودتان با چند مکالمهٔ واقعی بسنجید.
مینی بگیرم یا مکس؟
قاعدهٔ سرانگشتی: اگر «طبیعی حرف زدن» مهم است، مینی کافی است و ارزانتر هم هست. اگر ایجنت باید «کار را درست انجام دهد» — جواب دقیق و فراخوانی درست ابزارها — مکس را انتخاب کنید.
ایجنت فعلی من که با OpenAI ساخته شده قابل مهاجرت است؟
به گفتهٔ یازدهلبز، بله: فقط آدرس endpoint و نام مدل را در کد عوض میکنید و همان SDK اوپنایآی کار میکند. تنها استثنای مهم این است که اگر از WebRTC استفاده میکنید، اول باید transport را عوض کنید چون در لانچ پشتیبانی نمیشود.
دادههای صوتی کاربران من کجا پردازش میشود؟
به محیط دیتای انتخابی شما بستگی دارد. بدانید که مکس در محیطهای هند و سنگاپور عرضه نشده، حالت عدم نگهداری داده (Zero Retention) فقط برای مکس در آمریکا و اروپا فعال است، و جزئیات قراردادی حریم خصوصی در پلنهای سازمانی میآید.
منابع
The Decoder: Elevenlabs releases two new speech-to-speech models designed for real-time AI conversations (۲۰ اکتبر ۲۰۲۶)
Journal du Net: ElevenLabs Unveils Faster, More Accurate Speech-to-Speech Models (۲۱ اکتبر ۲۰۲۶)
i-scoop.eu: Eleven Realtime speaks OpenAI's protocol, and that makes voice agents easier to switch (۲۱ اکتبر ۲۰۲۶)
AlexTech.ai: ElevenLabs launches Eleven Realtime: voice agents from a single model (۲۱ اکتبر ۲۰۲۶)
IA en un minuto: ElevenLabs launches Eleven Realtime speech-to-speech models (۲۱ اکتبر ۲۰۲۶)
Artiverse: ElevenLabs Brings Faster Voice Agents With Two New Realtime Models (۲۱ اکتبر ۲۰۲۶)
TechEnclave: ElevenLabs launches Realtime voice models, with an India residency limit on Max (۲۲ اکتبر ۲۰۲۶)
مستندات AvalAI از مدلهای گفتاری یازدهلبز: ElevenLabs Speech Models (فهرست زبانهای تحتپوشش)