فهرست مطالب
Jev مدلی از شرکت TypeSafe AI است که در ۱۵ سپتامبر ۲۰۲۶ (۲۴ شهریور ۱۴۰۵) معرفی شد و بهجای نوشتن متن آزاد، برای تصمیمهای محدود و قابلاستفاده در نرمافزار پاسخهای ساختاریافته میدهد؛ مثلاً تشخیص نوع درخواست پشتیبانی، سنجش شدت یک خطا یا برآورد احتمال وجود دادهٔ حساس. این راهنما از تعریف Jev و تفاوتش با چتباتها شروع میکند، بعد طراحی سؤال، اتصال به API، خواندن خروجی، آزمودن کیفیت و ملاحظات امنیتی را قدمبهقدم توضیح میدهد. جزئیات دسترسی، قیمت و محدودیتها را بر پایهٔ مستندات رسمی بررسیشده در ۲۸ سپتامبر ۲۰۲۶ میخوانیم؛ این اطلاعات ممکن است تغییر کند.
اگر میخواهید جایگاه Jev را در سامانههای عاملمحور بهتر ببینید، ابتدا مقالهٔ Google AX و ارکستراسیون عاملها را بخوانید؛ برای طراحی مسیرهای بازبینی انسانی نیز گزارش خطرهای عاملهای نابهجا و خارج از انتظار زمینهٔ مفیدی میدهد. در ادامه، تمرکزمان خود Jev است: چه ورودی میپذیرد، چه چیزی تحویل میدهد و چطور باید پیش از سپردن تصمیم واقعی به آن، کیفیتش را بسنجید.
Jev چیست و چه مسئلهای را حل میکند؟
بسیاری از مدلهای زبانی برای تولید پاسخ انسانی ساخته شدهاند. اگر برنامه فقط به یک برچسب یا انتخاب نیاز داشته باشد، معمولاً باید مدل را با دستور دقیق به قالبی مثل JSON وادار کرد، متن دریافتی را تجزیه کرد و بعد بررسی کرد که پاسخ واقعاً یکی از گزینههای مجاز است. Jev این گام را هدف گرفته است: برنامه یک وضعیت و پرسشهای نوعدار میفرستد و پاسخهای نوعدار، همراه با احتمالها، میگیرد.
TypeSafe نام «System One» را برای این دسته انتخاب کرده است. این نام اصطلاح محصولی خود شرکت است، نه یک ردهبندی جاافتاده و مستقل در پژوهش هوش مصنوعی. ادعای TypeSafe این است که Jev برای داوریهای سریع و محدود داخل نرمافزار طراحی شده؛ بنابراین بهتر است آن را یک جزء تصمیمگیری در خط لوله ببینید، نه دستیار گفتوگویی که هر موضوعی را از ابتدا تا انتها حل میکند.
یک مثال ساده، پیام «سفارش من دو بار هزینه خورده؛ لطفاً مبلغ اضافه را برگردانید» است. برنامه میتواند بپرسد درخواست اصلی بازپرداخت است یا پیگیری، آیا متن حاوی درخواست بازپرداخت هست، و میزان نارضایتی مشتری در کدام سطح قرار میگیرد. پاسخ اول یک شاخهٔ کاری را انتخاب میکند، پاسخ دوم یک شرط روشن را میسنجد و پاسخ سوم برای اولویتبندی کمک میکند؛ اما بازپرداخت واقعی همچنان باید با سابقهٔ تراکنش و سیاست کسبوکار کنترل شود.
پیش از شروع: این ابزار برای کار شما مناسب است؟
پیش از ساخت حساب یا نوشتن اتصال، خروجی موردنیاز را مشخص کنید. اگر خروجی را میتوان با گزینههای محدود، سطحهای مرتب یا یک پاسخ بله/خیر تعریف کرد، Jev ممکن است مناسب باشد. اگر کار به تولید متن نهایی، نوشتن کد، توضیح بلند، جستوجوی وب، تحلیل چندمرحلهای یا فهم مستقیم تصویر و صدا نیاز دارد، این مدل بهتنهایی ابزار مناسبی نیست.
مستندات فعلی Jev را متنی معرفی میکنند: ورودی میتواند رشته، شیء ساختاریافته یا آرایهای از مقادیر متنی باشد؛ تصویر، صدا و ویدئو را مستقیماً نمیپذیرد. برای چنین دادههایی باید پیشتر اطلاعات لازم را با ابزار دیگری به متن یا فیلدهای ساختاریافته تبدیل کنید. این تبدیل هم خودش خطاپذیر است و کیفیت کل سامانه را تحتتأثیر میگذارد.
اگر مسئلهتان این است | شکل مناسب در Jev | مثال |
|---|---|---|
انتخاب یک مسیر از چند مسیر همرده | Choice | فروش، پشتیبانی، بازپرداخت یا سایر |
تعیین جایگاه روی یک نردبان تعریفشده | Score | شدت باگ از کم تا بحرانی |
بررسی یک گزارهٔ دقیق | Noul | آیا پیام درخواست لغو اشتراک دارد؟ |
نوشتن پاسخ یا تحلیل باز | بهتنهایی مناسب نیست | نوشتن توضیح شخصیسازیشده برای مشتری |
سه نوع پرسش: Choice، Score و Noul
در Jev هر پرسش باید نوع پاسخ مشخصی داشته باشد. انتخاب نوع اشتباه، حتی با پاسخ ظاهراً مرتب، مسئله را حل نمیکند: مثلاً «آیا این رزومه در پایتون قوی است؟» اگر «قوی» تعریف نشده باشد، بله/خیر مبهمی میسازد؛ برای سنجش طیفی مهارت بهتر است سطحها را صریح تعریف کنید.
Choice وقتی به کار میرود که گزینهها متفاوتاند اما ترتیب طبیعی ندارند؛ مثل دستهبندی موضوع درخواست. باید همهٔ مسیرهای واقعی را بیاورید و اگر فهرست ممکن است ناکامل باشد، گزینهای مانند «سایر» یا «هیچکدام» در نظر بگیرید. برای هر گزینه توضیح روشن بنویسید تا مرز گزینههای نزدیک معلوم باشد.
Score برای پاسخهای دارای ترتیب است؛ برای نمونه شدت مشکل با سطحهای «اثر جزئی»، «اختلال در یک قابلیت» و «ازکارافتادن سرویس». سطحها را با نشانههای قابل مشاهده تعریف کنید، نه با واژههای سلیقهای تنها. خروجی میتواند بین سطحها قرار بگیرد؛ برنامه باید آن را بر اساس نیاز خودش به یک سیاست عملی نگاشت کند.
Noul پرسش بله/خیر را به احتمالِ درستبودن گزاره تبدیل میکند؛ نام آن از وارونهٔ واژهٔ «لوُن» در مستندات محصول آمده است. مقدار نزدیک صفر یعنی پاسخ «نه» محتملتر است، نزدیک یک یعنی «بله»، و نزدیک نیم یعنی مدل میان دو حالت مردد است. Noul فیلد جداگانهای به نام confidence ندارد؛ احتمال خودش همان سیگنال را میدهد.
در Choice و Score، علاوه بر گزینه یا سطح انتخابشده، توزیع احتمال روی همهٔ پاسخها و مقدار confidence برمیگردد. Jev میگوید confidence را از شکل همین توزیع محاسبه میکند؛ آن را تضمین صحت ندانید. اگر گزینهها ناقص باشند، وضعیت ورودی مبهم باشد یا سؤال بد تعریف شده باشد، یک پاسخ نوعدار و حتی confidence بالا میتواند همچنان برای تصمیم شما نامناسب باشد.
طراحی سؤال خوب: یک داوری روشن در هر پرسش
اصل مهم در طراحی Jev این است که هر سؤال فقط یک داوری محدود بخواهد. پرسش «این پیام را بررسی کن و بهترین کار را انجام بده» چند مسئله را با هم مخلوط میکند: تشخیص درخواست، فوریت، سیاست مجاز و اقدام مناسب. مستندات TypeSafe توصیه میکنند این اجزا را به سؤالهای مستقل بشکنید و پاسخها را در منطق برنامه ترکیب کنید.
برای نمونهٔ پشتیبانی، ابتدا «موضوع اصلی پیام چیست؟» را با Choice بپرسید. جداگانه بپرسید «آیا مشتری صریحاً درخواست بازپرداخت دارد؟» با Noul و «شدت مشکل فنیِ گزارششده در کدام سطح است؟» را با Score بسنجید. همهٔ پرسشها باید اطلاعات لازم را در یک ورودی مشترک ببینند؛ جواب یک سؤال خودکار بهعنوان زمینهٔ سؤال دیگر استفاده نمیشود. اگر پرسش دوم واقعاً به پاسخ اول وابسته باشد، برنامه پس از پاسخ اول یک درخواست تازه میسازد.
در متن دستور، به فیلد دقیق ورودی اشاره کنید، معیار هر گزینه را توضیح دهید و حالتهای مرزی را در دادهٔ آزمایشی بگنجانید. برای دستهبندی، پیام خالی، درخواست ترکیبی، پیام نامرتبط و موردی که هیچ گزینهای را نمیگنجد از قبل بررسی کنید. هرچه گزینهها همپوشانی بیشتری داشته باشند، خروجی را باید بیشتر برای ارجاع انسانی در نظر گرفت.
گام ۱: ساخت حساب و آمادهکردن دسترسی
از وبسایت رسمی TypeSafe وارد مسیر شروع کار شوید و شرایط دسترسی روز را بخوانید؛ Jev هنگام معرفی در دسترسی زودهنگام بود و وضعیت محصول میتواند تغییر کرده باشد. برای فراخوانی API به حساب و کلید API نیاز دارید. کلید را در کد منبع، مخزن عمومی، اسکرینشات یا فایل ارسالی به همکاران نگذارید؛ آن را در مدیریت اسرار محیط اجرا نگه دارید، دسترسی را به سرویس لازم محدود کنید و اگر احتمال افشا هست، کلید را لغو و جایگزین کنید.
برای شروع میتوانید از یکی از SDKهای رسمی یا HTTP مستقیم استفاده کنید. مستندات در زمان بررسی، نشانی API را به شکل دامنهٔ api.typesafe.ai و مسیر v1/systemone معرفی میکنند؛ احراز هویت با کلید Bearer انجام میشود و بدنهٔ درخواست از state، نام مدل و نقشهٔ questions تشکیل میشود. پیش از پیادهسازی، دستور نصب و امضای دقیق SDK زبان خود را از صفحهٔ رسمی همان SDK بردارید؛ نام بستهها و نسخههای کتابخانه را از روی مقالههای قدیمی کپی نکنید.
گام ۲: ساخت state از اطلاعات لازم
state همان وضعیتی است که مدل باید دربارهاش داوری کند. برای آزمایش پشتیبانی، میتواند شامل متن پیام، موضوع سفارش، مرحلهٔ فعلی رسیدگی و بخش مرتبط از سیاست بازپرداخت باشد. اطلاعاتی را که به پرسش ربط ندارند حذف کنید؛ فرستادن کل پرونده یا سابقهٔ طولانی گفتگو ممکن است هم هزینه را بالا ببرد و هم دادهٔ اضافی را در اختیار سرویس بگذارد.
ساختار ورودی را طوری نگه دارید که فیلدها قابل ارجاع باشند. اگر سؤال دربارهٔ متن مشتری است، مشخص کنید منظور فیلد پیام مشتری است، نه پاسخ کارشناس یا سیاست داخلی. شناسهٔ سفارش یا اطلاعات تماس شخصی را فقط وقتی بفرستید که برای ارزیابی واقعاً ضروری باشد؛ در بسیاری از طبقهبندیها میتوان دادهٔ حساس را پیش از ارسال حذف یا جایگزین کرد.
پیش از فراخوانی واقعی، state را در لاگ آزمایشی چاپ و بررسی کنید تا توالی گفتگو و نقش گویندهها اشتباه نشده باشد. پیامی که در آن کاربر نقلقول یک دستور خصمانه را آورده، نباید بهسادگی با خود دستور یکی گرفته شود. Jev زمینهٔ ارسالی را میخواند، اما این واقعیت بهتنهایی دفاع در برابر تزریق دستور یا ابهام زمینه نیست.
گام ۳: تعریف پرسشها و ارسال درخواست
در درخواست، نام مدل را روی نسخهٔ مشخص یا نام مستعار رسمی قرار دهید. مستندات کنونی Jev 1.13 را با شناسهٔ jev-1.13.0 نشان میدهند و نام مستعار jev-latest به نسخهٔ پایدار جاری اشاره میکند. نام مستعار با انتشار نسخهٔ تازه ممکن است جابهجا شود؛ اگر آستانههایتان را برای یک نسخه تنظیم کردهاید، نسخهٔ پاسخدادهشده را ثبت کنید و تغییر نسخه را آگاهانه آزمایش کنید.
برای هر پرسش یک شناسهٔ یکتا، نوع، دستور روشن و معیارهای لازم تعریف کنید. برای Choice معیارها فهرست گزینهها و توضیح هرکداماند؛ برای Score نردبان سطحهای مرتباند؛ برای Noul توضیح اختیاریِ معنای بله و خیر را اضافه کنید. درخواست میتواند چند نوع پرسش را همزمان داشته باشد. پاسخ رسمی API برای هر شناسه جدا برمیگردد، پس نام شناسهها را ثابت و قابل خواندن انتخاب کنید.
در نمونهٔ پشتیبانی، یک درخواست واحد میتواند سه نتیجه بخواهد: گروه مسئول از میان «فنی»، «صورتحساب»، «بازپرداخت» و «سایر»؛ وجود یا نبود درخواست صریح بازپرداخت؛ و شدت مشکل فنی در سه سطح تعریفشده. برنامه بعداً میتواند فقط اگر گروه «فنی» است، شدت را به کار بگیرد؛ اما چون هر پرسش مستقل ارزیابی میشود، خودتان باید ترکیب این نتایج و سیاست نهایی را بنویسید.
گام ۴: پاسخ را بخوانید و سیاست را خودتان اجرا کنید
در پاسخ، ابتدا کلید پرسش موردنظر را پیدا کنید و مطمئن شوید نوع خروجی با نوعی که فرستادهاید یکی است. در Choice مقدار انتخابشده را همراه توزیع احتمال بررسی کنید؛ در Score سطح و توزیع متناظر را بخوانید؛ در Noul فقط احتمال گزاره را در دست دارید. خطای شبکه، محدودیت نرخ درخواست یا پاسخ ناقص را از «نه» مدل جدا کنید؛ شکست API نباید بهطور پیشفرض مجوز اقدام شود.
برای مثال، انتخاب «بازپرداخت» بهتنهایی نباید پولی را جابهجا کند. برنامه باید درخواست را با سوابق پرداخت تطبیق دهد، واجدشرایطبودن را طبق سیاست قطعی بررسی کند و برای اقدامهای مالی، تأیید لازم را بگیرد. Jev میتواند پیشنهاد یا مسیر رسیدگی بدهد؛ اجرای مجاز باید در قواعد قابلآزمون نرمافزار شما بماند.
گام ۵: confidence را کالیبره کنید و مسیر انسانی بسازید
برای Choice و Score مقدار confidence خلاصهای از تمرکز توزیع احتمال است. مستندات TypeSafe الگوی سهسطحی را پیشنهاد میکنند: نتیجهٔ مطمئن برای اقدام کمریسک، نتیجهٔ میانی برای بررسی یا پرسش تکمیلی، و نتیجهٔ نامطمئن برای توقف خودکارسازی و ارجاع. اینها رفتارهای نمونهاند، نه آستانههای آماده برای همهٔ پروژهها. یک اشتباه در برچسبزدن ایمیل و یک اشتباه در تأیید انتقال پول پیامد یکسانی ندارند.
آستانه را با دادهٔ برچسبخوردهٔ خودتان تعیین کنید. بخشی از نمونهها را برای تنظیم و بخشی جداگانه را برای آزمون نگه دارید؛ موارد فارسی، غلط املایی، پیامهای بسیار کوتاه، درخواستهای چندگانه و نمونههایی که تصمیم اشتباه در آنها پرهزینه است، باید جداگانه دیده شوند. «اعتماد ۰٫۹» بهخودیخود یعنی ۹۰ درصد درستی در سامانهٔ شما نیست؛ این معنا فقط وقتی قابل اتکاست که روی دادهٔ نماینده کالیبره شده باشد.
برای هر مسیر، هزینهٔ خطای مثبت کاذب و منفی کاذب را مشخص کنید. اگر پیام عادی بهاشتباه اضطراری تشخیص داده شود چه اتفاقی میافتد؟ اگر مشکل واقعی از صف اضطراری جا بماند چه؟ بر اساس پاسخها، سطح اطمینان لازم، بازبینی انسانی و مسیر جایگزین را جداگانه طراحی کنید و تغییر آستانه را با مجموعهٔ آزمون ثابت بسنجید.
گام ۶: ارزیابی از نمونهٔ کوچک تا محصول واقعی
پیش از اتصال به کاربران، مجموعهای از ورودیهای واقعی اما پاکسازیشده بسازید که پاسخ مرجع آنها را کارشناسان کسبوکار تعیین کردهاند. معیارها را پیش از دیدن خروجی انتخاب کنید: دقت هر دسته، خطاهای مهم، نرخ ارجاع انسانی، عملکرد در گروههای زبانی، زمان کامل درخواست و هزینهٔ واقعی. یک baseline ساده مانند قواعد فعلی یا طبقهبند موجود نگه دارید؛ مدل تازه باید در مسئلهٔ شما ارزش افزوده داشته باشد، نه اینکه صرفاً در یک دمو خوب بهنظر برسد.
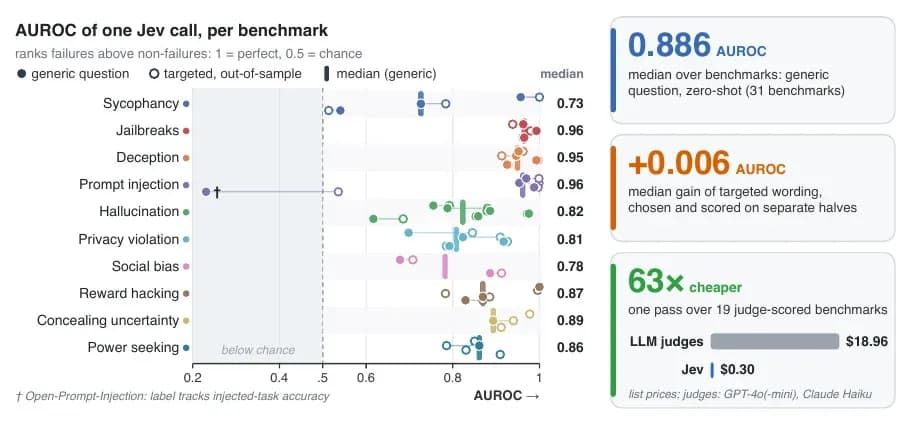
یک پیشچاپ پژوهشی مستقل با عنوان Just Ask Jev در ۲۴ سپتامبر ۲۰۲۶ روی arXiv ارسال شده و در صفحهٔ مقاله وضعیت «در دست داوری برای ICLR 2027» درج است. نویسندگان روی مجموعهای از بنچمارکهای تشخیص خطاهای همترازی، میانهٔ AUROC برابر ۰٫۸۸۶ برای پرسش عمومی در ۳۱ بنچمارک و هزینهٔ کمتر برای اجرای یک دور ارزیابی نسبت به داورهای زبانی گزارش میکنند. AUROC توان رتبهبندی نمونهٔ مثبت بالاتر از منفی را میسنجد و به معنی دقت ۸۸٫۶ درصد در محصول واقعی نیست؛ دادهها، تعریف برچسبها، زبان و نوع خطای پروژهٔ شما ممکن است متفاوت باشد.
این پژوهش شاهد جالبی برای بررسی بیشتر است، نه گواه قطعی کیفیت عمومی Jev. خود مقاله نشان میدهد کیفیت زمینه و برچسب اهمیت دارد، و بخشی از نتیجه به بنچمارکها و معیارهای مرجع آنها وابسته است. در کاربرد واقعی، نتیجه را روی دادهٔ خودتان تکرار کنید و میان ادعای سازنده، نتیجهٔ پژوهشی مستقل و اندازهگیری داخلی تفاوت بگذارید.
در پایلوت، ابتدا خروجی را فقط ثبت کنید و اجازه ندهید تصمیم مدل اقدام بیرونی انجام دهد. بعد از بررسی خطاها، مسیرهای کمریسک و برگشتپذیر را خودکار کنید؛ اقدامات حساس را تا زمانی که شواهد کافی ندارید با تأیید انسان نگه دارید. پس از عرضه نیز افت کیفیت، تغییر ترکیب پیامها و تغییر نسخهٔ مدل را پیوسته پایش کنید.
از پایلوت تا استقرار: خطاهایی که باید مهار شوند
برای خطای ارتباطی، timeout و پاسخ 429 برنامهٔ retry با مکث افزایشی و سقف تلاش داشته باشید؛ تکرار بیوقفه میتواند فشار را بیشتر کند. اگر سرویس در دسترس نبود، تصمیم امن را از پیش مشخص کنید: مثلاً نگهداشتن درخواست در صف یا فرستادن آن برای کارشناس، نه انتخاب تصادفی یک شاخه. مستندات میگویند SDKهای رسمی در برخی مسیرها retry با backoff را انجام میدهند، اما رفتار دقیق نسخهٔ نصبشده را بررسی کنید.
تغییرات مدل را هم بخشی از کنترل انتشار بدانید. مستعار jev-latest امکان دنبالکردن نسخهٔ جدید را ساده میکند، اما اگر تصمیمها بر اساس آستانه تنظیم شدهاند، تغییر مدل ممکن است توزیع احتمال یا نرخ ارجاع را عوض کند. نسخهٔ گزارششده، شناسهٔ پرسش، نسخهٔ معیارها و نتیجهٔ نهایی برنامه را ثبت کنید؛ متن خام حاوی دادهٔ شخصی را بیدلیل در لاگ نگه ندارید.
یک خطای رایج این است که چند داوری متفاوت در یک سؤال فشرده شوند. خطای دیگر، حذف گزینهٔ «سایر» و مجبورکردن همهٔ ورودیها به یکی از دستههای ناقص است. همچنین احتمال مدل را نباید با قانون کسبوکار یکی گرفت: Jev میتواند احتمال درخواست بازپرداخت را بسنجد، ولی فقط سامانهٔ سفارش میداند پرداخت واقعاً دوبار انجام شده یا نه.
پلن، قیمت، محدودیت و وضعیت زبان فارسی
صفحهٔ مدل TypeSafe در زمان بررسی، نسخهٔ Jev 1.13 را با هزینهٔ اعلامشدهٔ ۰٫۰۴۲ دلار برای هر یک میلیون توکن ورودی و بدون هزینهٔ جداگانهٔ توکن خروجی فهرست میکند. همان صفحه محدودیت نرخ درخواست را پویا میخواند و هشدار میدهد ممکن است بدون اطلاع قبلی تغییر کند؛ برای ظرفیت قراردادی یا سازمانی، مسیر تجاری جداگانه معرفی شده است. پیش از بودجهبندی یا استقرار، صفحهٔ رسمی قیمت و مدل را دوباره بررسی کنید؛ این مقاله وعدهٔ قیمت ثابت نمیدهد.
طبق مستندات، متن انگلیسی زبان اصلی آموزش است و دقت اعلامشده برای انگلیسی بهتر است؛ زبانهای دیگر هم پذیرفته میشوند اما کیفیتشان برابر تضمین نشده است. برای فارسی، نمونههای دستنویس خودتان را بهصورت جداگانه بسنجید، نه اینکه از پشتیبانی متن نتیجه بگیرید همهٔ ظرافتهای فارسی، محاوره، نیمفاصله و لهجه درست فهمیده میشود. وضعیت دسترسی و پرداخت از ایران را از شواهد بررسیشده نمیتوانم تأیید کنم؛ آن را پیش از انتخاب سرویس از منبع رسمی و مسیرهای مجاز پیگیری کنید.
از نظر حریم خصوصی، TypeSafe میگوید درخواستها و پاسخهای مشتری را برای آموزش مدل استفاده نمیکند و برای مشتریان سازمانی امکان نگهداری صفر داده را با هماهنگی ارائه میدهد. این ادعا جای بررسی قرارداد پردازش داده، محل پردازش، مدت نگهداری، سیاست حذف و تعهدات قانونی شما را نمیگیرد. پیش از فرستادن دادهٔ شخصی یا محرمانه، متن حقوقی جاری را بخوانید و در صورت امکان داده را کمینه یا ناشناس کنید.
جمعبندی: Jev را بهعنوان قطعهٔ تصمیمگیری بیازمایید
Jev برای تبدیل ورودی متنی به چند داوری محدود و ساختاریافته طراحی شده است؛ Choice گزینه را انتخاب میکند، Score سطح را میسنجد و Noul احتمال یک گزارهٔ بله/خیر را میدهد. ارزش عملی آن زمانی روشن میشود که برنامه از پاسخ نوعدار و احتمالها استفاده کند و منطق ترکیب، آستانه و اجرای اقدام را خودش کنترل کند. از یک مجموعهٔ آزمون کوچک و کمریسک شروع کنید، فارسی و موارد مرزی را جدا بسنجید و خروجی را با سیاست کسبوکار و بازبینی انسانی محافظت کنید. اگر مسئله به متن آزاد، استدلال طولانی یا ورودی چندرسانهای نیاز دارد، Jev را تنها جزء سامانه نگذارید.
پرسشهای پرتکرار
آیا Jev همان چتبات یا یک مدل زبانی معمولی است؟
خیر؛ در محصول فعلی برای تولید متن آزاد معرفی نشده و پاسخهای تصمیمی نوعدار میدهد. میتوان آن را کنار یک مدل مولد در گردشکار گذاشت، بهطوریکه هرکدام مسئول بخش متناسب با توانایی خود باشند.
تفاوت Choice، Score و Noul چیست؟
Choice یکی از چند گزینهٔ مستقل را انتخاب میکند؛ Score یک موقعیت را روی سطحهای مرتب میسنجد؛ Noul احتمال درستبودن یک گزارهٔ بله/خیر را میدهد. انتخاب نوع به ساختار تصمیم در نرمافزار شما بستگی دارد.
آیا Jev میتواند پاسخ اشتباه بدهد؟
بله. محدودبودن شکل پاسخ به گزینههای مجاز جلوی خروجی خارج از قالب را میگیرد، اما تضمین نمیکند گزینهٔ برگزیده از نظر واقعیت یا سیاست کسبوکار درست باشد. ورودی و تعریف گزینهها را بررسی کنید و مسیر بازبینی بسازید.
آیا Jev ورودی فارسی و تصویر را میفهمد؟
مستندات متن طبیعی را میپذیرند و میگویند انگلیسی زبان اصلی آموزش است؛ کیفیت فارسی را تضمین نمیکنند. تصویر، صدا و ویدئو مستقیماً پشتیبانی نمیشوند و باید ابتدا با ابزار دیگری به متن یا فیلدهای متنی تبدیل شوند.
confidence چند باشد که تصمیم را خودکار کنم؟
آستانهٔ همگانی وجود ندارد. با نمونههای برچسبخوردهٔ نماینده کالیبره کنید و برای اقدام پرریسک آستانهٔ سختگیرانهتر و بازبینی انسانی بگذارید؛ confidence بهتنهایی تضمین صحت نیست.
برای ساخت نمونهٔ اولیه چه چیزهایی لازم است؟
حساب و کلید API، یک state کمینه، پرسشهای دقیق از نوع مناسب، و برنامهای برای خواندن پاسخ و مدیریت خطا لازم دارید. جزئیات نصب SDK و محدودیتهای روز را از مستندات رسمی پیش از اجرا کنترل کنید.
آیا میتوانم دادهٔ حساس مشتری را به Jev بفرستم؟
فقط پس از بررسی توافقنامهٔ پردازش داده و سیاست نگهداری همان پلن. شرکت میگوید از دادهٔ مشتری برای آموزش استفاده نمیکند، اما این به معنی بینیازی از کمینهسازی داده یا ارزیابی الزامات حقوقی شما نیست.
آیا دسترسی Jev از ایران قطعی است؟
اطلاعات بررسیشده برای تأیید دسترسی یا پرداخت از ایران کافی نیست. شرایط جاری را از صفحهٔ رسمی سرویس بررسی کنید و هیچ دادهٔ حساس را پیش از روشنشدن وضعیت و تعهدات سرویس ارسال نکنید.
منابع
Introducing System One Models & Jev — TypeSafe AI، ۱۵ سپتامبر ۲۰۲۶؛ معرفی رسمی محصول.
Introduction، Primitives و API reference — مستندات رسمی TypeSafe؛ مبانی، انواع پرسش و شکل API.
Models، Confidence و Legal — مستندات رسمی TypeSafe؛ نسخه و محدودیتها، تفسیر confidence و داده.
Guo و همکاران، Just Ask Jev: Reinforcement Learning for Calibrated Decisions as a Zero-Shot Detector of AI Alignment Failures — arXiv:2609.29429، ارسالشده در ۲۴ سپتامبر ۲۰۲۶؛ پیشچاپ در حال داوری برای ICLR 2027، مجوز CC BY 4.0.
تصویر جلد: شکل ۱ از مقالهٔ Guo و همکاران در arXiv:2609.29429؛ برش و تبدیل قالب از نسخهٔ PDF رسمی. سازندگان: Ruoqi Guo، Yi Liu، Gelei Deng، Yuekang Li، Lida Zhao، Yutao Wu، Simin Chen، Ying Zhang و Leo Yu Zhang. منبع: https://arxiv.org/abs/2609.29429 — مجوز Creative Commons Attribution 4.0 International (CC BY 4.0): https://creativecommons.org/licenses/by/4.0/.