فهرست مطالب
شرکت چینی مونشات روز ۲۳ اکتبر ۲۰۲۶ (۱ آبان ۱۴۰۵) مدل «کیمی K3.1 Pro» را معرفی کرد؛ مدلی در کلاس سه تریلیون پارامتری با پنجرهٔ زمینهٔ یک میلیون توکنی که قرار است وزنهای کامل آن تا ۴ نوامبر (۱۳ آبان) منتشر شود. نکتهای که این خبر را از یک معرفی معمولی جدا میکند، تصمیم عمدی مونشات است: این شرکت میگوید دادههای مرتبط با هک را از آموزش مدل حذف کرده تا وزنهای باز، مرز توانایی سایبری را جلو نبرند. در این مطلب میگوییم این مدل دقیقاً چیست، در بنچمارکها چه میگوید و چه نمیگوید، قیمتش چقدر است و اگر توسعهدهنده یا کاربر فارسیزبان هستید، امروز با آن چه کار میتوانید بکنید.
پاسخ کوتاه
کیمی K3.1 Pro نخستین مدل سری K3.1 مونشات است؛ نسخهٔ پسآموزشدیدهٔ کیمی K3 با ۲٫۸ تریلیون پارامتر در مجموع و ۱۰۴ میلیارد پارامتر فعال بهازای هر توکن.
پنجرهٔ زمینهٔ آن یک میلیون توکن است؛ یعنی مدل میتواند در یک درخواست، حجم بسیار بزرگی از کد یا سند را همزمان ببیند.
نسخهٔ Highspeed هم همزمان عرضه شده که به گفتهٔ شرکت دو تا سه برابر سریعتر است، با همان پنجرهٔ زمینه.
به گفتهٔ مونشات، در Terminal-Bench 4.0 امتیاز ۶۵٫۷٪ گرفته؛ نزدیک به کلاد اوپوس ۵٫۵ با ۶۶٫۴٪ و بالاتر از GPT-6 Astra با ۵۸٫۲٪ — اما این جدول خود شرکت است، نه داوری مستقل.
وزنهای کامل مدل تا ۴ نوامبر ۲۰۲۶ منتشر میشوند؛ تا آن روز فقط نسخهٔ میزبانیشده در کیمی، کیمی ورک، کیمی کد و API در دسترس است.
قیمت API طبق صفحهٔ قیمتگذاری کیمی، ۲ دلار ورودی و ۱۰ دلار خروجی بهازای هر میلیون توکن است؛ نسخهٔ Highspeed دو برابر این قیمت را دارد.
اول زمینه: «مدل باز» یعنی چه و چرا مهم است؟
اگر تازه با این واژهها آشنا میشوید، از همینجا شروع کنید. «مدل» یعنی برنامهٔ هوش مصنوعی که با خواندن حجم عظیمی از متن و کد، یاد گرفته است ادامهٔ متن را پیشبینی کند و دستورها را اجرا کند. «وزنها» یعنی عددهایی که مدل در آموزش یاد گرفته است؛ مثل حافظهٔ مهارتی آن.
وزن باز با متنباز فرق دارد
وقتی شرکتی «وزنهای باز» منتشر میکند، یعنی فایلهای مدل را میدهد تا توسعهدهندهها بتوانند آن را روی سختافزار خودشان اجرا کنند و تغییرش بدهند، بدون اینکه همیشه از سرور آن شرکت استفاده کنند. این با «متنباز کامل» فرق دارد: دادههای آموزشی و دستور کامل آموزش معمولاً منتشر نمیشوند. پس «باز» بودن در اینجا یعنی آزادی اجرا و تغییر، نه دیدن همهٔ رازهای آموزش.
پنجرهٔ زمینه یعنی چه؟
«پنجرهٔ زمینه» یعنی مقدار متنی که مدل در یک درخواست میتواند همزمان در نظر بگیرد. یک میلیون توکن یعنی یک پروژهٔ نرمافزاری بزرگ، با دهها فایل کد و سند، میتواند یکجا در حافظهٔ کاری مدل باشد. برای تو، این یعنی کمتر تکهتکه کردن کار و کمتر از دست رفتن رشتهٔ بحث در پروژههای طولانی.
عامل و پسآموزش یعنی چه؟
«عامل» یعنی مدلی که فقط جواب نمیدهد؛ ابزار به دست میگیرد، کد اجرا میکند، فایل میسازد و چند قدم پشت سر هم کار میکند. «پسآموزش» یعنی بعد از آموزش اولیه، مدل را با تمرین بیشتر — از جمله یادگیری تقویتی، یعنی پاداش دادن به رفتار درست در محیطهای تمرینی — برای کارهای مشخص قویتر کنند. مونشات میگوید K3.1 Pro دقیقاً همین است: همان پایهٔ K3، با پسآموزش بسیار بزرگتر.
مونشات دقیقاً چه چیزی معرفی کرد؟
طبق وبلاگ فنی خود شرکت، Kimi K3.1 Pro نخستین مدل سری جدید K3.1 و «توانمندترین مدل وزنباز در کلاس سه تریلیون پارامتری» این شرکت تا امروز است. این توصیف، ادعای خود مونشات است و باید همانطور خوانده شود: شرکتی که محصولش را معرفی میکند، طبیعتاً بهترین تعبیر را از آن میگوید.
مدل چندوجهی است، یعنی ورودی تصویر را هم میپذیرد، و از همان روز معرفی در کیمی (وب و اپ موبایل)، کیمی ورک، کیمی کد و API کیمی در دسترس قرار گرفت. شناسههای API آن kimi-k3.1-pro و kimi-k3.1-pro-highspeed هستند و طبق وبلاگ شرکت، API از «نگهداری صفر داده» پشتیبانی میکند؛ یعنی برای مشتریان API، دادهٔ درخواست برای آموزش نگه داشته نمیشود.
نسخهٔ Highspeed چه فرقی دارد؟
به گفتهٔ مونشات، نسخهٔ Highspeed همان تواناییها را دارد اما دو تا سه برابر سریعتر پاسخ میدهد. این سرعت برای کارهای تعاملی — مثل کدنویسی زنده که منتظر پیشنهاد بعدی هستی — معنا دارد. اما سرعت بیشتر، کل پروژه را به همان نسبت کوتاه نمیکند؛ چون تست، بازبینی انسانی و فراخوانی ابزارها هم زمان میبرند. قیمتش هم دو برابر نسخهٔ استاندارد است، پس انتخاب بین این دو، انتخاب بین سرعت و هزینه است، نه بین خوب و بد.
چرا مونشات عامدانه مدل را در یک زمینه ضعیفتر کرد؟
عجیبترین بخش این خبر، بخش امنیت سایبری آن است. خبرگزاری رویترز در گزارش ۲۴ اکتبر خود نوشت که مونشات همزمان با معرفی مدل اعلام کرده توانایی تهاجمی سایبری آن را کم کرده است، چون نگران است مدلهای خودگردانِ توانمند، هک را آسانتر و ارزانتر کنند.
طبق وبلاگ فنی شرکت، در جریان توسعه مشخص شد که دادههای مرتبط با سایبر، در دل دادههای عمومی آموزش میانی و در محیطهای یادگیری تقویتی حضور داشتهاند. مونشات میگوید برای نسخهٔ وزنباز، این دادهها را از هر دو مرحله حذف کرده، اما وظایف عمومی کدنویسی را نگه داشته تا مدل همچنان به کار بیاید. جملهٔ کلیدی شرکت این است: «هدف ما این نیست که وزنهای بازی منتشر کنیم که مرز مطلق توانایی سایبری را جلو ببرد.»
عددهای داخلی شرکت، اثر این تصمیم را نشان میدهند: در بنچمارک داخلی xdev-bench-hard — آزمونی از کشف آسیبپذیری و ساخت اکسپلویت در کد واقعی — نسخهٔ بدون این محدودیت ۹۰٫۵٪ مسئله را حل میکند، اما نسخهٔ نهایی K3.1 Pro به ۸۱٪ میرسد. یعنی محدودیت واقعاً کار کرده، اما توانایی را صفر نکرده است. خود شرکت هم صریح میگوید توانایی عمومی کدنویسی و اشکالزدایی طولانی، حتی بعد از این حذف، به کارهای سایبری هم سرریز میشود.
این تصمیم چه ربطی به قوانین چین دارد؟
رویترز در گزارش خود یادآوری کرده است که چین هفتهٔ گذشته پیشنویس کنترلهای صادراتی را پیشنهاد داده که صادرات فناوری تولید بدافزار با هوش مصنوعی و ابزارهای کشف آسیبپذیری به کمک هوش مصنوعی را محدود میکند. این پیشنویس هنوز در مرحلهٔ نظرخواهی عمومی است و قانون نهایی نیست. پس نباید تصمیم مونشات را مستقیماً «اجرای آن قانون» دانست؛ اما فضای نگرانی مشترک — از طرف دولتها، شرکتها و پژوهشگران امنیتی — همان فضایی است که رویترز توصیف میکند.
برای تو، پیام عملی این بخش ساده است: مدل باز، ذاتاً قابل کنترل از راه دور نیست. وقتی وزنها پخش شوند، سازنده دیگر نمیتواند دسترسی را پس بگیرد یا حفاظها را بهروز کند. به همین دلیل است که بحث «چه چیزی را باز منتشر کنیم» برای مونشات، یک بحث فنی صرف نیست؛ یک تصمیم دربارهٔ مسئولیتِ بعد از انتشار است.
در بنچمارکها چه میگوید؟ جدول خود شرکت را چطور بخوانیم؟
همهٔ عددهای این بخش، از جدول خود مونشات میآیند، مگر جایی که صراحتاً چیز دیگری گفته شده باشد. شرکت میگوید مدلش را با هارنس Claude Code اجرا کرده و امتیاز رقیبان را از گزارشهای منتشرشدهٔ خودشان یا جدول رسمی بنچمارک برداشته است. این روش، رایج است، اما داوری مستقل نیست. تا وقتی وزنها منتشر نشدهاند و آزمایشگرهای بیرونی مدل را با شرایط یکسان اجرا نکردهاند، این عددها را باید «ادعای قابل بررسی» دانست، نه «حکم نهایی».
جدول زیر، تصویر خلاصهشدهٔ همان جدول است؛ با این تفاوت که نقطهٔ ضعف بزرگ مدل را هم — که در متن تبلیغاتی کمتر دیده میشود — عمداً نگه داشتهایم.
بنچمارک | Kimi K3.1 Pro | کلاد اوپوس ۵٫۵ | GPT-6 Astra |
|---|---|---|---|
Terminal-Bench 4.0 (عامل کدنویسی در ترمینال) | ۶۵٫۷٪ | ۶۶٫۴٪ | ۵۸٫۲٪ |
BenchCAD با ابزار (بازسازی سهبعدی با کد CAD) | ۹۲٫۷٪ | ۹۶٫۲٪ | ۹۵٫۹٪ |
Terminal-Bench Science (کار علمی در ترمینال) | ۳۸٫۱٪ | ۶۳٫۳٪ | ۶۸٫۱٪ |
OfficeQA Pro v2 (تحلیل اسناد مالی پیچیده) | ۶۴٫۴٪ | اعلام نشده در این جدول | اعلام نشده در این جدول |
جدول را اینطور بخوانید: در کدنویسی عاملمحور، K3.1 Pro عملاً شانهبهشانهٔ اوپوس ۵٫۵ است و از GPT-6 Astra جلوتر است — اما در کار علمیِ ترمینالی، فاصلهٔ آن با هر دو رقیب بسیار زیاد است. اگر کارت کدنویسی عمومی یا کار اداری است، این مدل جدی است؛ اگر کارت محاسبات علمی سنگین است، هنوز مدلهای بستهٔ پیشرو جلوترند.
کدنویسی طولانیمدت چقدر بهتر شده؟
در بنچمارک داخلی خود شرکت، Kimi Code Bench 3.0 Long-horizon — که اجرای چندمرحلهای، استفاده از ابزار و حل مسئلهٔ سرتاسری را میسنجد — امتیاز از ۵۵٫۹۵٪ در K3 به ۶۱٫۲٪ در K3.1 Pro رسیده است. در وبلاگ شرکت یک نمونهٔ چشمگیر هم آمده: ساخت شبیهساز راهرفتن انسان با ۱۶۷ مأموریت و ۴۲۰ بازبینی مستقل، که در آن مدل پس از شکست در شکلدهی پاداش، خودش ۳۶ خطا در محاسبات عضلات شانه پیدا و اصلاح کرد. این نمونه، نمایش توانایی است، نه تضمین اینکه در پروژهٔ تو هم همینطور عمل کند؛ اما نشان میدهد چرا مونشات روی «کارهای طولانی» تمرکز کرده است.
دقت واقعی چقدر بهتر شده؟
مونشات میگوید در آزمون داخلی سختگیرانهٔ دقت واقعی خود، نرخ توهم در سطح تکگزاره از ۲۳٫۴٪ در K3 به ۸٫۳٪ رسیده است. خود شرکت هشدار میدهد که این آزمون، عمداً برای گیر انداختن مدل طراحی شده و این نرخها، نرخ خطای روزمره نیستند. پس عدد را اینطور بخوان: مدل در بدترین سناریوهای طراحیشده بهتر شده، نه اینکه دیگر خطا نمیکند. اگر با آن گزارش مالی یا تحلیل سرمایهگذاری میسازی، باز هم باید هر عدد را با منبع اصلی چک کنی.
سهبعدی و 3D Make؛ جایی که کیمی میخواهد متفاوت باشد
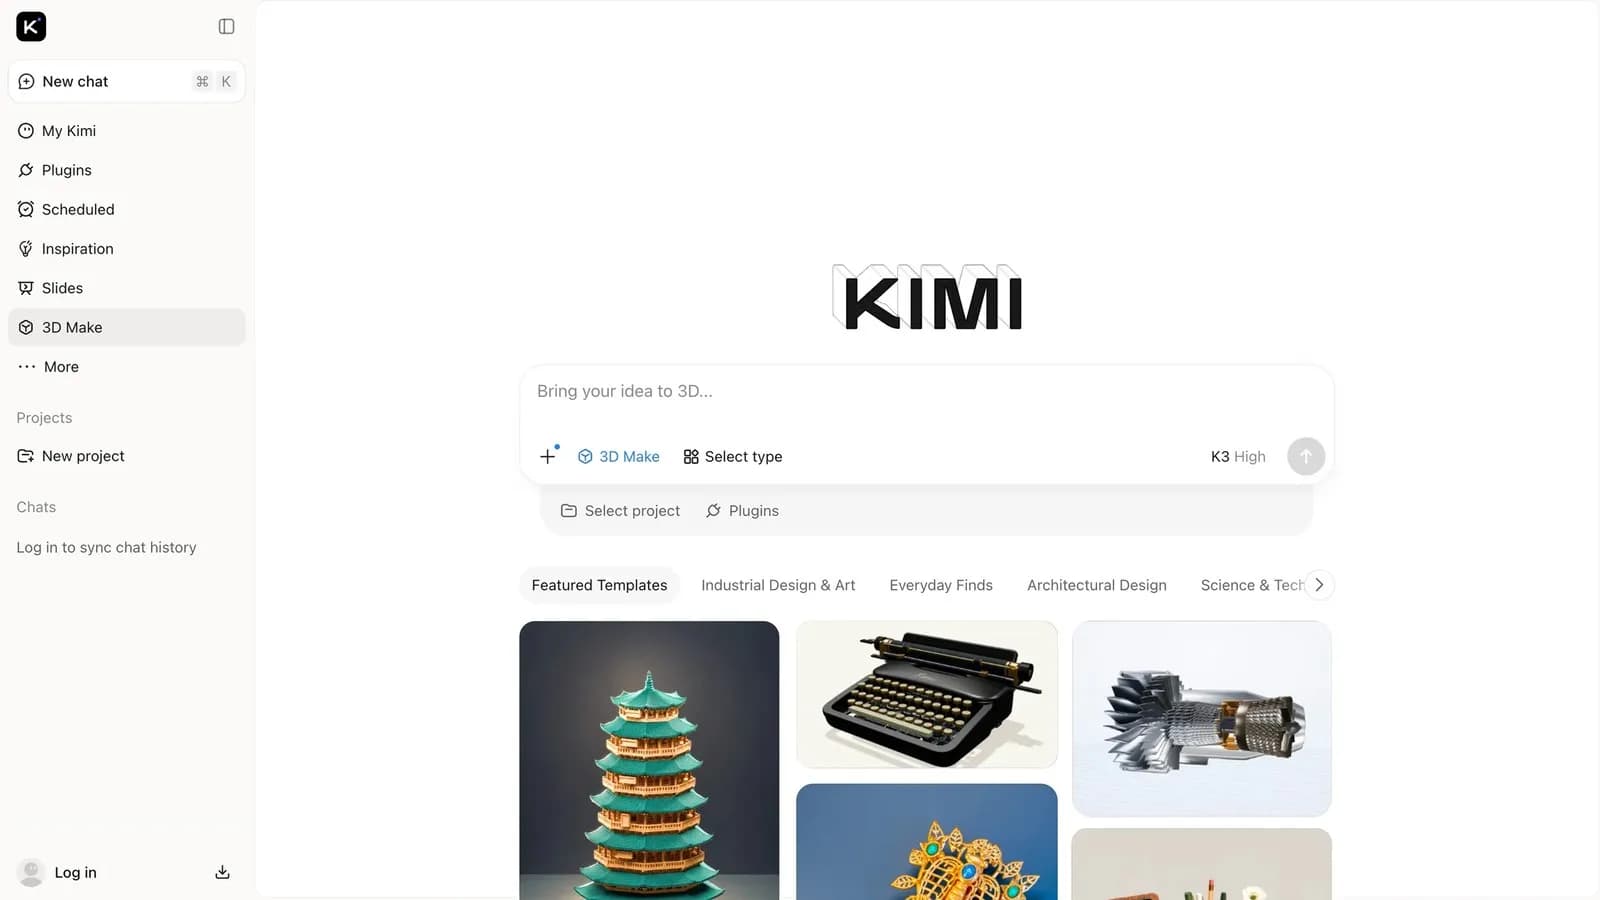
مونشات روی خلق سهبعدی هم شرط بسته است. طبق وبلاگ شرکت، مدل میتواند از یک شرح متنی، طرح اولیه یا تصویر مرجع، مدل سهبعدی بسازد، با ابزارهایی مثل بلندر و نرمافزارهای CAD اسکریپت بنویسد و قطعهها را ویرایش کند. قابلیت «3D Make» هماکنون در وب کیمی و اپ موبایل فعال است: مدل را پیشنمایش و ویرایش میکنی، برای چاپ سهبعدی دانلود میکنی یا بهصورت ویدیو و Live Photo خروجی میگیری.
اگر طراح محصول یا سازندهٔ بازی هستی، میتوانی ایدهٔ اولیه را سریع به مدل سهبعدی قابل لمس تبدیل کنی و بعد در ابزار تخصصی خودت پرداختش کنی. اما امتیاز BenchCAD مدل هنوز پشت اوپوس و GPT-6 Astra است؛ پس «خوب» با «بهترین» فرق دارد.
قیمت و دسترسی؛ دقیقاً چه چیزی، چقدر میارزد؟
طبق صفحهٔ قیمتگذاری کیمی که خلاصههای فنی متعدد آن را بازنشر کردهاند، قیمت API مدل استاندارد ۲ دلار ورودی و ۱۰ دلار خروجی بهازای هر میلیون توکن است؛ نسخهٔ Highspeed، ۴ دلار ورودی و ۲۰ دلار خروجی؛ و ورودیِ کششده (یعنی متنی که قبلاً دیده شده و دوباره فرستاده میشود) فقط ۰٫۲۰ دلار است. این قیمت، یکسوم کمتر از K3 با ۳ و ۱۵ دلار است و به گفتهٔ تحلیلگران، نصف قیمت کلاد اوپوس ۵٫۵ با ۴ و ۲۰ دلار است.
برای درک هزینه: یک میلیون توکن ورودی و دویست هزار توکن خروجی در نسخهٔ استاندارد، حدود ۴ دلار میشود — بدون احتساب کش. هزینهٔ واقعی تو به طول ورودی و استفاده از کش بستگی دارد. API به دلار صورتحساب میشود.
از کجا میتوانی امتحانش کنی؟
سادهترین مسیر، وب کیمی در kimi.ai و اپ موبایل آن است؛ مدل را از انتخابگر مدل برمیداری و شروع میکنی. برای کدنویسی، کیمی کد را باز کن و با دستور /model مدل را انتخاب کن. برای کار دسکتاپی، کیمی ورک نسخهٔ ۳٫۱٫۰ یا بالاتر لازم است که برای ویندوز و مکهای اپل سیلیکون عرضه شده است. برای سازمانها، دسترسی در ابتدا خاموش است و مدیر سازمان باید آن را فعال کند. اگر توسعهدهنده هستی و میخواهی مدل را در ابزار خودت صدا بزنی، API با شناسههای گفتهشده و نقطهٔ پایانی سازگار با OpenAI در دسترس است.
داوری مستقل چه میگوید؟
خبر خوب اینکه یک عدد مستقل هم زود رسید. به گزارش خلاصههای فنی از Artificial Analysis، این مرجع مستقل به Kimi K3.1 Pro امتیاز ۵۵ در شاخص هوش داده است؛ بالاتر از کلاد فبل ۵٫۱، GPT-6 Astra و جمینای ۴ آرگون که هر سه ۵۳ گرفتهاند، و پایینتر از کلاد اوپوس ۵٫۵ با ۵۸. این یعنی حتی با معیار بیرونی هم، K3.1 Pro در ردهٔ مدلهای پیشرو قرار میگیرد — هرچند هنوز صدرنشین نیست.
اما این امتیاز روی نسخهٔ میزبانیشده گرفته شده، نه روی وزنهای هنوز منتشرنشده. آزمون واقعی در ۴ نوامبر شروع میشود؛ وقتی جامعه بتواند مدل را خودش با شرایط یکسان بسنجد.
برای خوانندهٔ فارسیزبان چه معنایی دارد؟
در اطلاعیهٔ رسمی مونشات، صحبتی از محدودیت کشوری نشده است؛ اما این به معنای دسترسی رسمی و بیدردسر از ایران نیست. قیمتگذاری دلاری، نیاز به پرداخت بینالمللی و وضعیت سرویسهای خارجی در ایران، چیزهایی هستند که باید پیش از هر تعهدی، خودت بررسی کنی. در این مطلب، راه دور زدن هیچ محدودیتی پیشنهاد نمیشود؛ فقط این واقعیت گفته میشود که «در دسترس بودن جهانی» در اطلاعیه، با «در دسترس بودن عملی برای تو» یکی نیست.
از نظر زبان فارسی، مونشات در اطلاعیهاش ادعای خاصی دربارهٔ فارسی نکرده است. پس اگر میخواهی با آن فارسی کار کنی، با یک آزمون کوچک شروع کن: یک متن فارسی بلند بده، خلاصهاش را بگیر و با متن اصلی مقایسه کن. مدلهای چندوجهی و با پنجرهٔ بزرگ، معمولاً در خلاصهسازی و ترجمه خوباند، اما در جزئیات عددی و اسامی خاص، همان احتیاط همیشگی لازم است.
نکتهٔ عملی: اگر توسعهدهنده هستی، امروز چه کار کنی؟
یک کار واقعی از پروژهٔ خودت بردار — نه یک مثال تبلیغاتی — و همان را هم به K3.1 Pro بده، هم به مدلی که امروز استفاده میکنی؛ نتیجه را با تست واقعی بسنج، نه با حس کلی.
برای کار طولانی، کل پروژه را یکجا بده و ببین آیا مدل رشتهٔ بحث را تا آخر نگه میدارد یا وسط راه گم میشود؛ همین، آزمون اصلی پنجرهٔ یک میلیون توکنی است.
اگر سرعت برایت مهم است، نسخهٔ Highspeed را فقط در حلقههای تعاملی امتحان کن و هزینه را با نسخهٔ استاندارد مقایسه کن؛ دو برابر قیمت، همیشه دو برابر ارزش نیست.
برای خروجیهای حساس — گزارش مالی، تحلیل سرمایهگذاری، کد امنیتی — خروجی را پیشنویس بدان و هر عدد و ادعا را با منبع مستقل راستیآزمایی کن.
اگر قصد خودمیزبانی داری، تا ۴ نوامبر صبر کن و بعد لایسنس واقعی و نیاز سختافزاری را بخوان؛ مدلی با ۲٫۸ تریلیون پارامتر، حتی با ۱۰۴ میلیارد پارامتر فعال، روی لپتاپ معمولی اجرا نمیشود.
چیزهایی که هنوز روشن نیست
اینجا چیزی اختراع نمیکنیم؛ چند نکته هنوز باز است. اول، لایسنس وزنهای آینده در وبلاگ و خبرهایی که بررسی کردیم، مشخص نشده است؛ تا ۴ نوامبر نمیتوان گفت استفادهٔ تجاری از آن دقیقاً با چه شرایطی مجاز است. دوم، قیمت اشتراکهای مصرفی کیمی (جدا از API) در اطلاعیهٔ اصلی نیامده و نباید با قیمت API قاطی شود. سوم، آزمون مستقل ما نیست؛ عددهای بنچمارک تا وقتی جامعهٔ بیرونی آنها را تکرار نکند، ادعای شرکت باقی میمانند. و چهارم، اثر واقعی حذف دادههای سایبری در دنیای واقعی — نه در بنچمارک داخلی — هنوز معلوم نیست؛ چون مهاجم واقعی، فقط با نسخهٔ وزنباز کار نمیکند.
جمعبندی: صبر کنی یا امتحان کنی؟
اگر توسعهدهنده یا سازندهٔ محصول هستی، جواب «امتحان کن» است — اما با یک پروژهٔ واقعی و با چشم باز. K3.1 Pro به گفتهٔ خود شرکت و یک مرجع مستقل، در کدنویسی و کار عاملی به مدلهای بستهٔ پیشرو نزدیک شده، قیمتش نصف اوپوس است، پنجرهٔ یک میلیون توکنی دارد و قرار است تا ۱۳ آبان وزنهایش باز شود. اگر کارت علمی سنگین است یا به خروجی بدون خطا نیاز داری، «صبر کن» عاقلانهتر است: بگذار وزنها بیایند، آزمونهای مستقل تکرار شوند و لایسنس روشن شود. در هر دو حالت، یک چیز را فراموش نکن: بنچمارک، وعده است؛ پروژهٔ واقعی تو، داور نهایی است.
جزئیات بیشتر دربارهٔ ابزار کدنویسی این خانواده را در بررسی کیمی کد دسکتاپ پوشش دادهایم. برای مقایسه با رقیب اصلی این خبر، مطلب کلاد اوپوس ۵٫۵ چیست را ببین؛ و اگر میخواهی بدانی مدلهای OpenAI چطور وارد ابر گوگل شدند، مطلب ورود مدلهای OpenAI به گوگل کلاد را بخوان. دربارهٔ نسل تازهٔ مدلهای GPT هم معرفی GPT-6 Sol و Luna به کار تو میآید.
قدرت مدلهای باز در امنیت سایبری دو لبه دارد. Epoch AI در گزارشی تازه، کیمی K3.1 Pro را از مدلهایی دانسته که شاید در کارهای تهاجمی از GLM 5.3 هم قویتر باشد؛ همان مدلی که شش نسخهٔ فایرفاکس را هک کرد. ماجرا را در GLM 5.3 و خطر شکاف وصلهٔ فایرفاکس بخوانید.
اگر میخواهید توانایی سهبعدی همین مدل را در عمل ببینید: ابزار 3D Make کیمی از روی یک توصیف، طرح دستی یا عکس، مدل سهبعدی، صفحهٔ وب تعاملی یا فایل آمادهٔ چاپ میسازد. نحوهٔ کار، قیمت، محدودیتها و ماجرای اتصال آن به بلندر را در معرفی کامل Kimi 3D Make توضیح دادهایم.
کیمی تنها مدل بزرگ چینی برای کدنویسی نیست. لانگکت ۲٫۵ از شرکت میتوان ۱٫۶ تریلیون پارامتر کلی دارد و برای کارهای طولانی کدنویسی با عامل ساخته شده است، اما وزنهایش هنوز منتشر نشده است.
پرسشهای متداول
کیمی K3.1 Pro چیست؟
مدل هوش مصنوعی شرکت چینی مونشات است که ۲۳ اکتبر ۲۰۲۶ معرفی شد؛ مدلی در کلاس سه تریلیون پارامتری با پنجرهٔ زمینهٔ یک میلیون توکنی که برای کدنویسی، کار عاملی، خلق سهبعدی و تحلیل مالی طراحی شده است.
وزنهای باز آن کی منتشر میشوند؟
به گفتهٔ مونشات، وزنهای کامل مدل تا ۴ نوامبر ۲۰۲۶ (۱۳ آبان ۱۴۰۵) منتشر میشوند. تا آن روز، فقط نسخهٔ میزبانیشده در کیمی، کیمی ورک، کیمی کد و API در دسترس است.
نسخهٔ Highspeed چه فرقی با نسخهٔ استاندارد دارد؟
به گفتهٔ شرکت، همان تواناییها را دارد اما دو تا سه برابر سریعتر است. قیمت API آن دو برابر است: ۴ دلار ورودی و ۲۰ دلار خروجی بهازای هر میلیون توکن، در برابر ۲ و ۱۰ دلار نسخهٔ استاندارد.
آیا واقعاً به کلاد اوپوس ۵٫۵ نزدیک است؟
در جدول خود مونشات، در Terminal-Bench 4.0 با ۶۵٫۷٪ در برابر ۶۶٫۴٪ اوپوس، بله، نزدیک است. اما در کار علمی ترمینالی با ۳۸٫۱٪ در برابر ۶۳٫۳٪، فاصلهٔ زیادی دارد. پس «نزدیک» بودن، به نوع کار بستگی دارد و هنوز داوری مستقل کاملی روی وزنهای باز انجام نشده است.
قیمت استفاده از آن چقدر است؟
قیمت API طبق صفحهٔ قیمتگذاری کیمی، ۲ دلار ورودی و ۱۰ دلار خروجی بهازای هر میلیون توکن برای نسخهٔ استاندارد است و ورودی کششده ۰٫۲۰ دلار. قیمت اشتراکهای مصرفی کیمی جدا از این قیمتهاست و در اطلاعیهٔ اصلی نیامده است.
چرا مونشات توانایی سایبری مدل را کم کرد؟
شرکت میگوید دادههای مرتبط با سایبر را از آموزش حذف کرده تا وزنهای باز، مرز توانایی سایبری را جلو نبرند. رویترز این تصمیم را در فضای نگرانی فزاینده از آسانتر شدن هک با مدلهای خودگردان گزارش کرده است.
از ایران میتوان از آن استفاده کرد؟
در اطلاعیهٔ رسمی، محدودیت کشوری ذکر نشده، اما دسترسی عملی از ایران به پرداخت دلاری و وضعیت سرویسهای خارجی بستگی دارد و باید پیش از استفاده، خودت آن را بررسی کنی. در این مطلب راه دور زدن هیچ محدودیتی پیشنهاد نمیشود.
آیا میتوان آن را روی کامپیوتر شخصی اجرا کرد؟
هنوز نه؛ وزنها منتشر نشدهاند. حتی پس از انتشار هم مدلی با ۲٫۸ تریلیون پارامتر به سختافزار سنگین سروری نیاز دارد و روی لپتاپ معمولی اجرا نمیشود؛ بیشتر کاربران همچنان از نسخهٔ میزبانیشده یا API استفاده خواهند کرد.


