فهرست مطالب
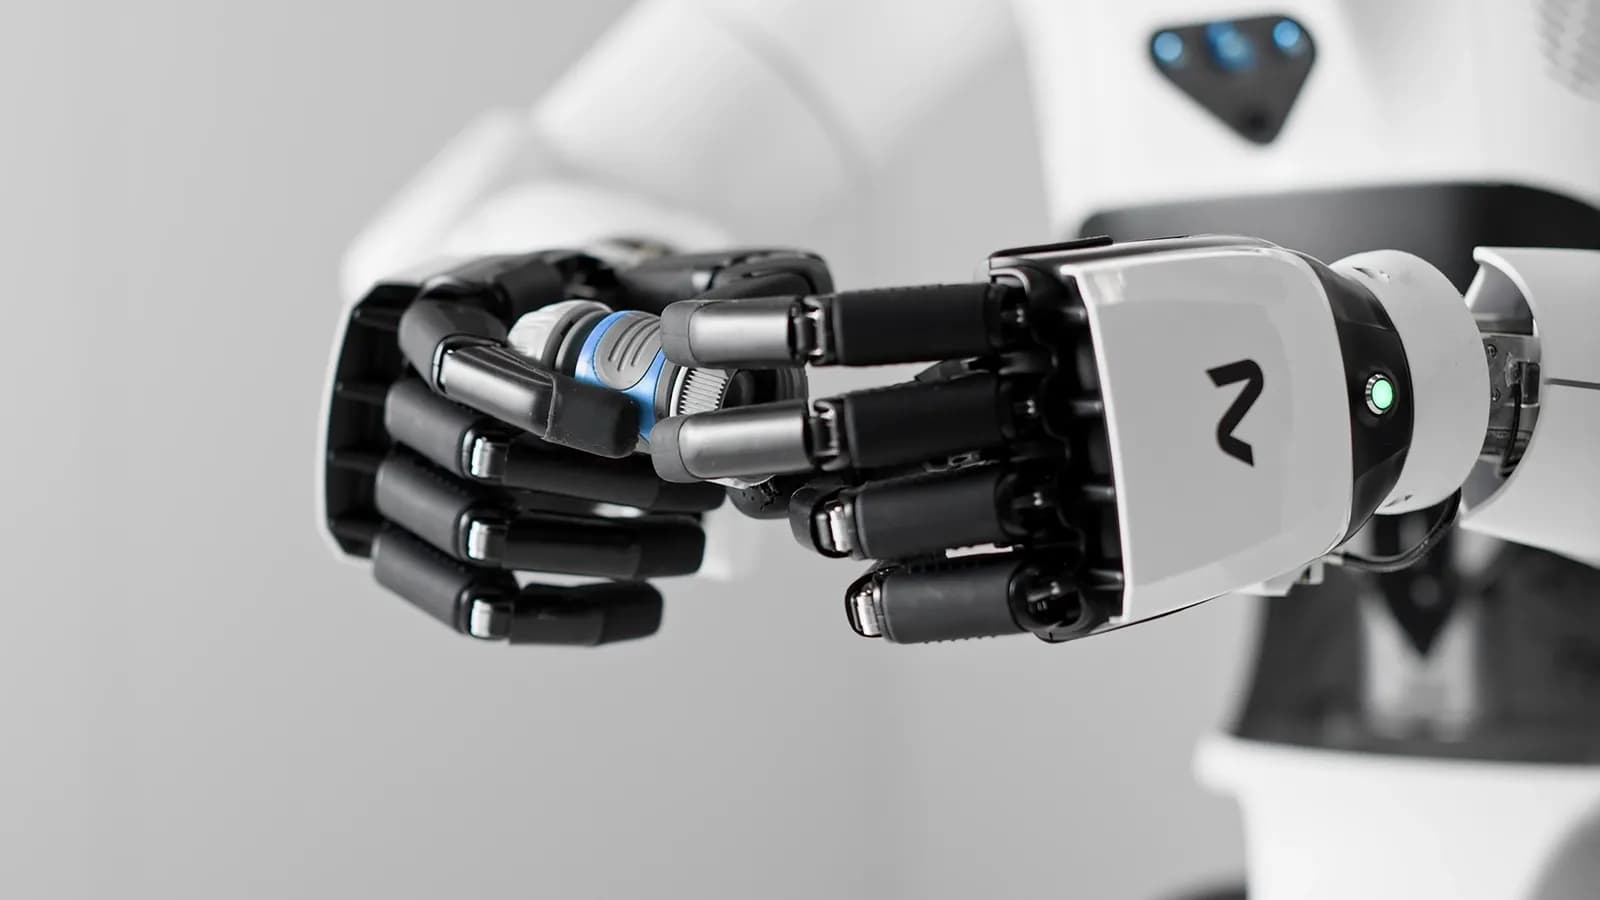
شرکت آلمانی نورا رباتیکس روز ۱۴ اکتبر ۲۰۲۶ (۲۲ مهر) مدل بنیادینی به نام «نورون AI» معرفی کرد؛ مدلی چندحسی که قرار است مغز رباتهای صنعتی و انساننمای این شرکت باشد: ربات با آن نهتنها میبیند، بلکه لمس میکند، میشنود و بهخاطر میسپرد. بهگفتهٔ خود شرکت، این مدل «مغز دنیای فیزیکی» است؛ اما توجه داشته باش که این فعلاً یک اعلام رسمیِ شرکتی است و هیچ بنچمارک مستقلی از آن منتشر نشده.
پاسخ کوتاه
نورون AI یک مدل بنیادین چندحسی برای «هوش فیزیکی» (Physical AI) است؛ یعنی هوش مصنوعیای که درون رباتها کار میکند، نه در چتباتها. — بهگفتهٔ نورا رباتیکس، نورون AI مدلی است که دیدن، لمسکردن، شنیدن و حافظه را در یک بازنمایی مشترک کنار هم میگذارد و از دل آن، حرکت ربات را میسازد.
معرفی رسمی: ۱۴ اکتبر ۲۰۲۶، از شهر متسینگن آلمان؛ مدیرعامل شرکت، دیوید رگر، آن را «مغز دنیای فیزیکی» توصیف کرده است.
معماری سهلایه (PLA): لایهٔ ادراک (دیدن، لمس، شنیدن، حس وضعیت بدن)، لایهٔ زبان (قرار دادن همهٔ ورودیها در یک فضای زبانی مشترک) و لایهٔ عمل (تبدیل تصمیم به حرکت دقیق و امن).
پیام اصلی: دوربین بهتنهایی کافی نیست؛ چیزهایی مثل گیرکردن یک پیچ، کلیکخوردن یک کانکتور یا کیفیت یک درز جوش، فقط با لامسه و صدا مشخص میشود.
مدل روی خود ربات تصمیم میگیرد؛ یعنی بدون اتصال به ابر هم کار میکند و دادههای کارخانه نزد مشتری میماند.
نکتهٔ مهم: Time-to-Skill (سرعت یادگیری یک مهارت جدید) معیار اصلی اعلام شده، اما هیچ عددی دربارهٔ آن منتشر نشده و هیچ ارزیابی مستقلی وجود ندارد.
زمینه برای مبتدی
رباتهایی که فقط «میبینند»
بیشتر رباتهای امروزی جهان را از پشت یک دوربین میشناسند. مدلهایی که مغز آنها هستند، بهطور سنتی سه کار میکنند: دیدن (Vision)، فهمیدن زبان (Language) و عمل (Action)؛ به همین خاطر به آنها مدلهای VLA میگویند. این مدلها در حرکت و جابهجایی خوباند، اما یک مشکل بنیادین دارند: همهچیز را به تصویر تقلیل میدهند. دوربین، هندسه، رنگ و موقعیت را ثبت میکند، اما از «تماس»، «نیرو» و «صدا» چیزی نمیفهمد.
حالا خودت را جای یک تکنسین کارخانه بگذار: وقتی داری یک پیچ را سفت میکنی، چشمات فقط نیمی از ماجرا را میبیند؛ آن چیزی که به تو میگوید پیچ «گیر کرده»، حسی است که از نوک انگشتات میگیری. وقتی یک کانکتور را جا میزنی، آن «کلیک» رضایتبخش را گوشات میشنود. نورا رباتیکس میگوید رباتها تا امروز از همین نیمهٔ دومِ ماجرا محروم بودهاند.
هوش فیزیکی یعنی چه؟
«هوش فیزیکی» (Physical AI) اصطلاحی است که این روزها زیاد میشنوی؛ یعنی هوش مصنوعیای که در دنیای واقعیِ پیوسته عمل میکند، نه در دنیای گسستهٔ متن و تصویر. مدل زبانی میتواند دربارهٔ بازکردن یک قفل بنویسد، اما ربات باید واقعاً آن را باز کند؛ و بهگفتهٔ نورا رباتیکس، بازشدن یک قفل را فقط صدا و لامسه تأیید میکنند، نه چشم. ایدهٔ مشابهی را قبلاً در مدل ادیسی ۳ هم دیده بودیم: مدلی که میخواست «دنیای فیزیکی» را بفهمد تا رباتها در آن عمل کنند.
تفاوت ادعایی نورون AI این است که از همان ابتدا برای چند حس ساخته شده: نهفقط بینایی، بلکه لامسه، شنوایی، حس وضعیت بدن (اینکه هر مفصل ربات دقیقاً کجاست) و البته دستور متنی کاربر. همهٔ اینها در یک بازنمایی مشترک و همزمان (time-aligned) کدگذاری میشوند و بعد به «یک جریان واحدِ عمل» تبدیل میگردند؛ یعنی خروجی نهایی، حرکت است، نه جمله.
نورون AI دقیقاً چه میکند؟
بهگفتهٔ نورا رباتیکس، معماری نورون AI سه لایه دارد که شرکت آن را PLA مینامد (ادراک، زبان، عمل). این سه لایه را مثل یک خط تولید فکر کن: ورودی خام از یک سو وارد میشود و حرکتِ امن از سوی دیگر بیرون میآید.
لایهٔ اول — ادراک: وقتی ربات «حس» میکند
لایهٔ ادراک، دنیای فیزیکی را میگیرد: ربات میبیند، لمس میکند، میشنود، موقعیت بدن خودش را حس میکند و دستور کاربر را هم دریافت میکند. نکتهٔ مهم اینجاست که لامسه و شنوایی، «ورودی درجهدو» نیستند؛ در این معماری همردیف بیناییاند. چرا؟ چون بهگفتهٔ شرکت، لمس کردن به ربات اجازه میدهد شیئی را بگیرد که اصلاً در دیدش نیست (پشت یک مانع، داخل یک جعبه) و صدای فرایند — مثلاً صدای جوشکاری — کیفیت درز را لو میدهد.
لایهٔ دوم — زبان: همهچیز به یک زبان
در لایهٔ دوم، یک مدل زبانی همهٔ این ورودیهای ناهمگون را وارد «یک فضای زبانی مشترک» میکند و روی درخواست استدلال میکند. به زبان ساده: بوی سوختن، صدای کلیک و تصویر یک پیچ، همه به یک «زبان میانی» ترجمه میشوند تا مدل بتواند دربارهشان فکر کند. این همان جایی است که مدلهای زبانیِ بزرگی مثل مدلهای بنیادین متنی تجربه دارند؛ نورا رباتیکس همان ایده را به دنیای حسها تعمیم داده است.
لایهٔ سوم — عمل: از تصمیم تا حرکت امن
لایهٔ آخر، تصمیم را به حرکت دقیق و امن ربات ترجمه میکند. «امن» اینجا کلمهٔ کلیدی است: در کارخانه، یک حرکت اشتباه یعنی خسارت یا خطر جانی؛ پس مدل عمل نهتنها باید بداند چه کاری انجام دهد، بلکه باید آن را در محدودهٔ امن اجرا کند. اگر مدلهای عاملی را که با کامپیوتر کار میکنند دیده باشی — مثل ایجنتی که نقش منشی رباتیک را بازی میکند — اینجا همان منطقِ «فهمیدن و بعد عمل کردن» را داری، فقط بهجای کلیک روی دکمه، با بازوی واقعیِ فلزی سروکار داری.
چرا دوربین بهتنهایی کافی نیست؟
نورا رباتیکس برای این ادعا سه صحنهٔ ملموس از دنیای واقعی مثال میزند؛ هر سه از جنس کارهاییاند که در کارخانه و خانه هر روز اتفاق میافتند:
سه صحنهای که چشم، «کور» است
گیرکردن پیچ: چشم، چرخش پیچ را میبیند، اما «گیرکردن» را فقط نوک انگشت حس میکند؛ همان مقاومتی که به تو میگوید بیشتر نچرخان.
بازشدن قفل: تصویرِ قفلِ باز و قفلِ بسته گاهی شبیه هماند؛ آنچه بازشدن واقعی را تأیید میکند، ترکیب صدا و لامسه است.
کیفیت جوش: درز جوشِ خوب و بد از دور شبیه هم به نظر میرسند؛ اما صدای فرایند جوشکاری، کیفیت را لو میدهد.
پیام این مثالها روشن است: بخش بزرگی از «فهمیدن» دنیای فیزیکی، اصلاً دیداری نیست. مدلی که فقط به دوربین تکیه کند، در بهترین حالت نیمی از واقعیت را میفهمد.
حافظه؛ قطعهای که رباتها نداشتند
شاید جالبترین بخش اعلام نورا رباتیکس، «حافظه» باشد. استدلال شرکت این است: برخلاف هوش مصنوعیِ صرفاً دیجیتال که در دنیای متن زندگی میکند، ربات در یک «دنیای فیزیکیِ پیوسته» عمل میکند؛ یعنی باید اشیاء و پیامدهای اعمال خودش را در طول زمان دنبال کند، حتی وقتی آنها را نمیبیند.
«ماندگاری شیء»؛ درسی از دو سالگی ما
روانشناسان به این توانایی «ماندگاری شیء» (object permanence) میگویند: اینکه بدانی شیئی که از دیدت خارج شد، هنوز وجود دارد. انسانها این را در دو سال اول زندگیشان میآموزند؛ رباتها تا امروز نداشتندش. بهگفتهٔ نورا رباتیکس، معماری نورون AI بهطور خاص برای واردکردن حافظه بازطراحی شده و روی مجموعهدادههای اختصاصیِ حافظه آموزش دیده است. اگر قرار باشد ربات لباسها را مرتب کند — کاری که در دموی آیندهٔ شرکت خواهیم دید — باید یادش بماند هر تکه لباس را کجا گذاشته، حتی وقتی زیر تلّی از لباسهای دیگر پنهان شده.
ایدهٔ حافظهٔ روی-دستگاه، در دنیای مدلهای زبانی هم داغ است؛ مثلاً دربارهٔ حافظه و پردازش خصوصی هوش مصنوعی روی خود دستگاه قبلاً نوشتهایم. تفاوت اینجاست که حافظهٔ نورون AI، حافظهٔ «دنیای فیزیکی» است: نه اینکه چه گفتی، بلکه اینکه چه چیزی کجاست و چه اتفاقی برایش افتاده.
نورون AI در برابر مدلهای VLA
نورا رباتیکس خودش را مستقیم با مدلهای VLA (بینایی-زبان-عمل) مقایسه میکند؛ پس بگذار این مقایسه را شفاف کنیم، با این یادآوری که این توصیف، روایت خود شرکت است، نه داوری مستقل:
جنبه | مدلهای VLA (روایت نورا) | نورون AI (ادعای نورا) |
|---|---|---|
ورودیهای حسی | عمدتاً بینایی + زبان | بینایی + لامسه + شنوایی + حس وضعیت بدن + زبان |
مبنای استدلال | بیشتر فریمِ فعلی دوربین | بازنمایی مشترک و همزمانِ همهٔ حسها |
حافظه | محدود یا غایب | بخشی از معماری؛ آموزشدیده روی دادههای حافظه |
تمرکز بهینهسازی | حرکت و جابهجایی | همان، بهعلاوهٔ تماس، نیرو و صدا |
بهعبارت دیگر، نورا رباتیکس نمیگوید VLAها بدند؛ میگوید آنها «بینایی-محور»اند و نورون AI همان زمین را پوشش میدهد «بهعلاوهٔ» حسهای دیگر. اینکه این «بهعلاوه» در عمل چقدر تفاوت میسازد، چیزی است که فقط بنچمارک مستقل میتواند نشان دهد — و چنین بنچمارکی هنوز منتشر نشده.
دادهها از کجا میآیند؟ سه ستون
هر مدل بنیادین به دادهٔ عظیم نیاز دارد؛ و دادهٔ «لمس و صدا و نیرو» را نمیشود از اینترنت جمع کرد. نورا رباتیکس میگوید دادهٔ نورون AI از سه ستون میآید:
ستون اول: باشگاههای نورا و دنیای واقعی
در «باشگاههای نورا» (NEURA Gyms) و محیطهای واقعی، رباتهایی با بدنهای مختلف کارهای واقعی انجام میدهند و جریانهای همزمانِ بینایی، لامسه، نیرو، صدا و حرکت تولید میکنند. کلید واژه «همزمان» است: ارزش داده در این است که حسِ نوک انگشت دقیقاً با همان لحظهای که دوربین میبیند، ثبت شده باشد.
ستون دوم: شبیهساز و «تقویتکنندهٔ داده»
ستون دوم، پشتهٔ شبیهسازی شرکت است: تنوعِ شبیهسازیشدهٔ وظایف و محیطها، با ابزاری به نام «تقویتکنندهٔ داده» (Data Amplifier). به زبان ساده، وقتی دنیای واقعی برای تولید یک سناریوی خاص گران یا کند است، شبیهساز هزاران نسخهٔ متفاوتِ آن را میسازد.
ستون سوم: انسانهایی با لباس حسگری
ستون سوم، نمایشهای انسانی است: انسانهایی با «لباسهای داده»ٔ مجهز به حسگر، کارها را انجام میدهند تا ربات از حرکت انسان یاد بگیرد. این همان روشی است که در آموزش رباتهای انساننما رایج شده: بهجای برنامهنویسیِ حرکت، «نشانش بده».
پنج بدن، یک مغز
نکتهٔ مهم معماری: نورون AI قرار نیست فقط روی یک ربات کار کند. بهگفتهٔ شرکت، یک مدل واحد روی پنج «بدن» مختلف آموزش دیده و مستقر میشود: نسل سوم و نسل چهارم ربات انساننمای 4NE-1، یک نسخهٔ چرخدارِ 4NE-1، و دو پلتفرم دومنظورهٔ دیگر. خانوادهٔ رباتهای شرکت هم شامل MAiRA و MiPA و MAV+ و 4NE1 میشود.
چرا «یک مدل برای همه» مهم است؟
ایده این است که «فهمیدن دنیا» از «بدنِ خاص» جدا شود: مغز یکی است، بدنها عوض میشوند. اگر این ادعا درست باشد، اضافهشدن یک ربات جدید به ناوگان، یعنی فقط تطبیق همان مغز با بدن تازه — نه آموزش از صفر. این دقیقاً همان چیزی است که معیار Time-to-Skill را که جلوتر میبینی، معنا میکند.
تصمیم روی خود ربات، بدون ابر
نورون AI تصمیمها را «بهصورت بلادرنگ روی خود ربات» میگیرد؛ یعنی برای هر تصمیم لازم نیست به سرور رفتوبرگرد داشته باشد و ربات بدون اتصال به ابر هم به کارش ادامه میدهد. بهگفتهٔ شرکت، دادههای تولیدی هم تحت کنترل مشتری میماند و همین نکته برای تولیدکنندگان اروپایی «کلیدی» توصیف شده است.
این انتخاب معماری، فقط فنی نیست؛ ژئوپلیتیک هم هست. کارخانهای که رباتش برای هر حرکت به ابرِ یک شرکت خارجی وصل باشد، عملاً کلید خط تولیدش را دست دیگری داده است. نورا رباتیکس — که همهچیز را «در آلمان توسعه داده و آموزش داده» — دقیقاً روی همین نقطه دست گذاشته: هوش فیزیکیِ «توسعهیافته در آلمان، ساختهشده برای جهان»، بهقول مدیرعامل شرکت.
نوراورس و معیار Time-to-Skill
کنار مدل، پلتفرمی به نام «نوراورس» (Neuraverse) هم معرفی شده که سه کار را به هم وصل میکند: جمعآوری داده، آموزش مهارت، و بنچمارک در باشگاههای نورا. بعد مهارتها را روی ناوگان رباتها مستقر و بهروز میکند؛ مشتریها هم میتوانند مهارتها را برای کار خودشان «تنظیم دقیق» (fine-tune) کنند. مهارتها میتوانند خصوصی بمانند، اما مهارتها و دادههای بهاشتراکگذاشتهشده، اکوسیستم بزرگتر را تغذیه میکنند.
Time-to-Skill یعنی چه؟
معیار مرکزی کل این داستان، «زمانِ رسیدن به مهارت» (Time-to-Skill) است: سرعتی که ربات یک وظیفهٔ جدید را یاد میگیرد و «قابلاعتماد» اجرایش میکند. مشتری صنعتی همین را میخواهد: هرچه این زمان کوتاهتر، ربات زودتر به خط تولید برمیگردد. اما — و این «اما» مهم است — شرکت هیچ عددی برای این معیار منتشر نکرده: نه زمان یادگیری، نه نرخ موفقیت. پس فعلاً Time-to-Skill یک «وعدهٔ معیار» است، نه یک رکورد.
چرا این خبر برای خوانندهٔ فارسیزبان مهم است؟
نکتهای که این خبر را از یک «معرفی محصولِ دیگر» جدا میکند، جغرافیایش است: این یک مدل «هوش فیزیکی» است که در اروپا — مشخصاً آلمان — توسعه یافته، با تکیه بر پایگاه صنعتی آلمان و همکاریهای دادهای با شرکتهایی مثل شفلر (Schaeffler) و بوش (Bosch). در دنیایی که رقابت هوش مصنوعی عمدتاً بین آمریکا و چین تعریف میشود، اروپا دارد تلاش میکند در لایهٔ «رباتهای صنعتی» — جایی که خودش کارخانه و زنجیرهٔ تأمین دارد — حرفی برای گفتن داشته باشد.
دربارهٔ تحریم یا محدودیت برای ایران، در این اعلام چیزی گفته نشده و گمانهزنی دراینباره بیمبناست؛ آنچه برای ما مهم است، «جهت» فناوری است: رباتهایی که حس میکنند و بهخاطر میسپارند، دارند از آزمایشگاه به کارخانه میآیند — و معیار رقابت دارد از «چه مدلی بزرگتر است» به «چه رباتی زودتر یک کار واقعی را یاد میگیرد» تغییر میکند.
چیزهایی که هنوز روشن نیست
حالا بخش مهمِ صداقت: این یک اعلام رسمیِ شرکتی است، نه یک مقالهٔ علمیِ داوریشده. تا لحظهٔ نگارش این مطلب:
هیچ بنچمارک منتشرشدهای از نورون AI وجود ندارد و هیچ ارزیابی مستقلی انجام نشده؛ پس ادعای برتری بر مدلهای VLA را نمیشود راستیآزمایی کرد.
Time-to-Skill بهعنوان معیار نام برده شده، اما هیچ عددی — نه زمان یادگیری، نه نرخ موفقیت — منتشر نشده است. در پرسشوپاسخ تحلیلی Implicator.ai هم دقیقاً همین خلأ برجسته شده.
قیمت، لایسنس و نحوهٔ دسترسی به خودِ نورون AI اعلام نشده است. (آنچه در برخی رسانهها دربارهٔ پیشخرید ۱۰۰ یوروییِ ربات 4NE-1 Gen 3.5 با تحویلِ وعدهدادهشدهٔ پایان ۲۰۲۶ آمده، گزارش همان رسانههاست — از جمله Implicator.ai — نه بخش رسمیِ این اعلام.)
جزئیات فنیِ معماری (اندازهٔ مدل، حجم دادهٔ آموزشی، توان محاسباتیِ لازم روی ربات) هم منتشر نشده.
اینها بهمعنای «دروغ بودن» اعلام نیست؛ بهمعنای «ناتمام بودن داستان» است. خبر خوب اینکه آزمون بعدی نزدیک است — بخش بعد را ببین.
جمعبندی: چه چیزی را رصد کنیم
اگر بخواهی فقط یک چیز را از این خبر نگه داری، آن «دموی زنده» است: در نمایشگاه GTC برلین (۲۰ تا ۲۲ اکتبر ۲۰۲۶، Station-Berlin، سالن ۳، غرفهٔ ۳۰۳۱) ربات انساننمای 4NE1 — که نامش مخفف «For Anyone» است — با نسخهٔ فعلیِ نورون AI یک سکانس ۱۱ دقیقهایِ رختشویی را کاملاً خودگردان و بدون دخالت انسان اجرا میکند: مرتبکردن لباسها، قراردادنشان در ماشین لباسشویی، بستن و دوباره بازکردن در، تخلیه، و انتقال به خشککن.
این دمو، آزمونِ واقعیِ همهٔ ادعاهاست: لامسه (گرفتن لباسِ نرم و لغزنده)، حافظه (یادآوری جای هر تکه لباس)، و توالیِ طولانیِ یک کار خانگیِ واقعی. اگر این ۱۱ دقیقه بدون توقف اجرا شود، نورون AI از «اعلام» به «اثبات» نزدیک میشود؛ اگر نه، دستکم میفهمیم فاصله چقدر است. پس تصمیمِ پیشنهادیِ ما ساده است: خبر را در حد «اعلامِ امیدوارکننده» نگه دار و چشمات به گزارشهای مستقل از GTC برلین باشد.
یک خط حاشیه هم بماند: ۱۴ اکتبر روز شلوغی برای دنیای رباتها بود؛ در همان روز، Faraday Future هم رویداد معرفی ربات انساننمای FF Nova را برگزار کرد.
سؤالات پرتکرار
نورون AI دقیقاً چیست؟
بهگفتهٔ نورا رباتیکس، نورون AI یک مدل بنیادینِ چندحسی برای «هوش فیزیکی» است؛ یعنی مدلی که ورودیهای بینایی، لامسه، شنوایی، حس وضعیت بدن و دستور متنی را در یک بازنمایی مشترک ترکیب میکند و از آن، حرکت ربات را میسازد. در ۱۴ اکتبر ۲۰۲۶ در متسینگن آلمان معرفی شد.
فرقش با مدلهای زبانیِ معمولی مثل چتباتها چیست؟
مدل زبانی در دنیای متن زندگی میکند و خروجیاش جمله است؛ نورون AI در دنیای فیزیکیِ پیوسته عمل میکند و خروجیاش «حرکت» است. بهعلاوه، برخلاف چتبات که گذشتهٔ مکالمه را بهیاد دارد، این مدل باید اشیاء و پیامدهای فیزیکیِ اعمال خودش را — حتی وقتی دیده نمیشوند — دنبال کند.
VLA یعنی چه و نورون AI چه فرقی با آن دارد؟
VLA مخفف بینایی-زبان-عمل است: مدلهایی که با دوربین میبینند، دستور را میفهمند و حرکت میکنند. بهروایت نورا رباتیکس، این مدلها «بینایی-محور»اند و بیشتر روی فریمِ فعلی دوربین استدلال میکنند؛ نورون AI همان مسیر را با معماری سهلایهٔ PLA میرود «بهعلاوهٔ» لامسه، صدا و حافظه. این مقایسه، ادعای خود شرکت است و هنوز با بنچمارک مستقل سنجیده نشده.
آیا نورون AI بدون اینترنت کار میکند؟
بهگفتهٔ شرکت، بله: تصمیمها بهصورت بلادرنگ روی خود ربات گرفته میشود، بدون رفتوبرگرد به سرور، و ربات بدون اتصال به ابر هم کار میکند. دادههای تولیدی هم تحت کنترل مشتری میماند؛ نکتهای که شرکت آن را برای تولیدکنندگان اروپایی «کلیدی» دانسته است.
Time-to-Skill چیست؟
معیار مرکزیِ معرفی نورا رباتیکس: سرعتی که یک ربات، یک وظیفهٔ جدید را یاد میگیرد و قابلاعتماد اجرایش میکند. هرچه کوتاهتر، ربات زودتر به خط تولید برمیگردد. اما هیچ عددی برای آن منتشر نشده — نه زمان یادگیری، نه نرخ موفقیت.
میشود نورون AI را خرید یا دانلود کرد؟
تا این لحظه، قیمت، لایسنس و نحوهٔ دسترسی به خودِ مدل اعلام نشده است. شرکت از پلتفرم «نوراورس» حرف زده که مشتریها میتوانند در آن مهارتها را تنظیم دقیق کنند، اما جزئیات تجاریِ مدل فعلاً روشن نیست.
کِی میشود آن را در عمل دید؟
نزدیکترین قرار، نمایشگاه GTC برلین است: ۲۰ تا ۲۲ اکتبر ۲۰۲۶، Station-Berlin، سالن ۳، غرفهٔ ۳۰۳۱. آنجا ربات 4NE1 با نورون AI یک سکانس ۱۱ دقیقهایِ کاملاً خودگردانِ رختشویی اجرا میکند: از مرتبکردن لباسها تا انتقال به خشککن.
منابع
نورا رباتیکس: NEURA Robotics Introduces Neuron AI — صفحهٔ رسمی معرفی
Business Wire: NEURA Robotics Introduces Neuron AI: The Brain of the Physical World — انتشار رسمی خبر
Unite.AI: NEURA Robotics Unveils Neuron AI: Foundation Model for Physical AI — پوشش خبری ۱۴ اکتبر
Dev.to: NEURA's Neuron AI: A Foundation Model That Lets Robots Feel, Hear, and Remember — تحلیل مستقل
Implicator.ai: NEURA Robotics' Neuron AI: Touch, Sound, Memory — پرسشوپاسخ تحلیلی و انتقادی