فهرست مطالب
انویدیا فردا، پنجشنبه ۲۳ مهر، مدل «نموترون ۳.۵ بولت ۷۴B» را منتشر میکند؛ مدلی با ۷۴ میلیارد پارامتر که فقط ۹ میلیاردشان در هر لحظه فعالاند و با فشردهسازی ۲بیتی در ۲۴ گیگابایت حافظه جا میشود. خبر بزرگ این نیست که مدل جدیدی آمده — خبر این است که انویدیا میگوید آن را کاملاً متنباز منتشر میکند: وزنها، دادههای آموزشی و حتی دستور پخت آموزش.
اگر لپتاپ یا کامپیوتری با حافظهٔ گرافیکی بالا دارید، این خبر برای شماست. و اگر توسعهدهندهاید و روی ایجنتهای محلی کار میکنید، برای شما مهمتر است. در این مطلب میبینید این مدل دقیقاً چه ساختاری دارد، چرا ۲۴ گیگابایت مهم است، فردا از کدام ابزارها میتوانید اجرایش کنید — و کدام ادعاها را باید با احتیاط شنید، چون هنوز هیچ بنچمارک مستقلی از آن در دست نیست.
پاسخ کوتاه
چه چیزی: مدل زبانی «نموترون ۳.۵ بولت ۷۴B»، با معماری «ترکیبی متخصصان» یعنی ۷۴ میلیارد پارامتر کلی و فقط ۹ میلیارد پارامتر فعال در هر پردازش.
کی: پنجشنبه ۱۵ اکتبر ۲۰۲۶، برابر ۲۳ مهر ۱۴۰۵ — یعنی فردا، یک روز پیش از عرضهٔ لپتاپهای RTX Spark در ۱۶ اکتبر.
چرا مهم: به گفتهٔ انویدیا، مدلی در این ردهٔ اندازه با دقت کامل به بیش از ۱۴۰ گیگابایت حافظه نیاز دارد؛ این مدل با کوانتیزاسیون ۲بیتی در ۲۴ گیگابایت مینشیند.
چقدر باز: انویدیا اعلام کرده وزنها، دادههای آموزشی و دستورهای آموزش را منتشر میکند — یعنی متنبازِ واقعی، نه فقط دانلود وزن.
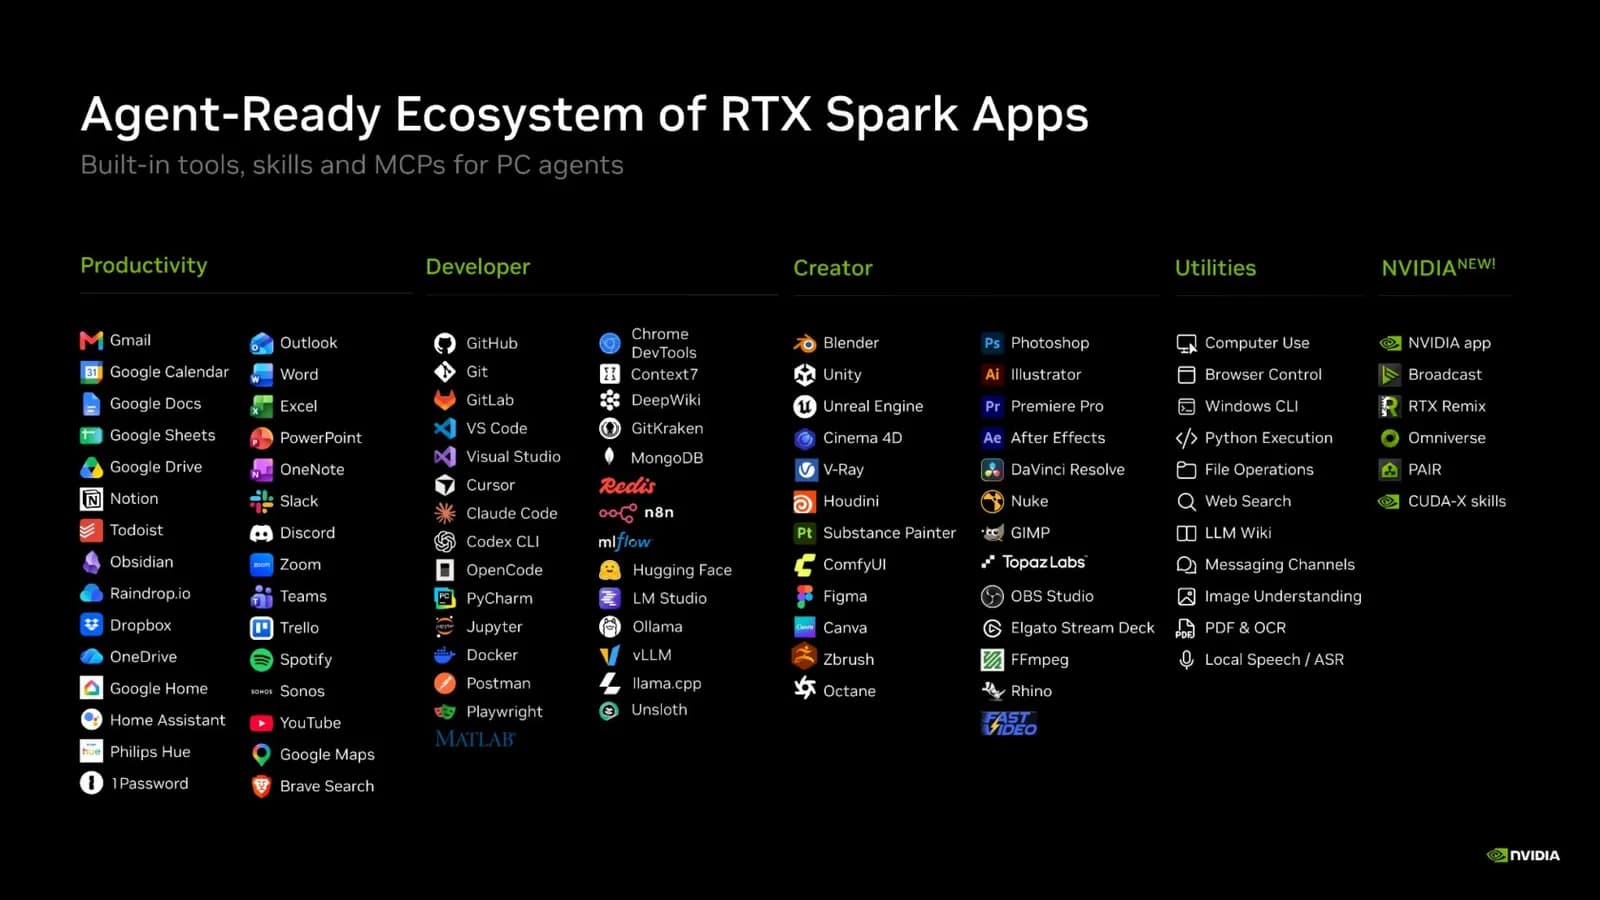
از کجا: در روز عرضه از طریق llama.cpp، vLLM، Ollama، Unsloth و LM Studio؛ و از داخل ایجنتهایی مثل Hermes و OpenClaw.
اول زمینه: مدل «ترکیبی متخصصان» یعنی چه؟
قبل از خبر، دو اصطلاح فنی را یکبار برای همیشه روشن کنیم. اولیاش MoE است که مخفف Mixture of Experts یا «ترکیبی از متخصصان» است.
یک مثال از دنیای واقعی
تصور کنید بهجای یک پزشک عمومی که همهچیز را خودش تشخیص میدهد، یک تیم پزشکی دارید: متخصص قلب، متخصص مغز، متخصص ارتوپد. وقتی بیمار میآید، یک «دروازهبان» هوشمند تشخیص میدهد سؤال به کدام متخصص مربوط است و فقط او را صدا میزند. بقیهٔ تیم استراحت میکنند.
مدلهای ترکیبی متخصصان دقیقاً همین کار را میکنند. بهجای اینکه ۷۴ میلیارد پارامتر برای هر کلمه فعال شوند — که یعنی محاسبهٔ سنگین و حافظهٔ پرمصرف — یک مکانیزم «گیتینگ» یعنی دروازهبانیِ هوشمند، هر سؤال را به زیرشبکهای میفرستد که برای همان نوع سؤال آموزش دیده. نتیجه: مدل ۷۴ میلیارد پارامتری، موقع استنباط مثل یک مدل ۹ میلیارد پارامتری رفتار میکند. نه از نظر دانش — چون کل ۷۴ میلیارد پارامتر در وزنها هست — بلکه از نظر هزینهٔ محاسبه و حافظه.
چرا این معماری مهم شد؟
این ایده تازه نیست؛ مقالهٔ معروف شازیر در ۲۰۱۷ پایهاش را گذاشت و مدلهایی مثل Mixtral میسترال و DeepSeek-V3 نشان دادند در مقیاس واقعی جواب میدهد. تازهٔ ماجرا این است که انویدیا حالا همین معماری را با یک تکنیک فشردهسازیِ تهاجمی ترکیب کرده و مدعی است بدون افت محسوس کیفیت، آن را در حافظهٔ یک لپتاپ جا داده.
اول زمینه: «کوانتیزاسیون» یعنی چه؟
کوانتیزاسیون ساده
وزنهای یک مدل زبانی معمولاً با دقت بالا — مثلاً ۱۶ بیت برای هر عدد — ذخیره میشوند. کوانتیزاسیون یعنی این عددها را با دقت کمتر ذخیره کنی؛ مثل اینکه بهجای نوشتن وزن دقیقِ «۷۲.۴۳۷ کیلوگرم» روی چمدان، بنویسی «حدود ۷۲.۴». هرچه دقت کمتر، حافظهٔ کمتر. قیمتش معمولاً افت کیفیت است.
آموزشِ آگاهازفشردهسازی
روش سنتی این است که مدل را کامل آموزش میدهی و بعد فشردهاش میکنی — مثل بستن چمدان بعد از سفر. روش QAT یا «آموزشِ آگاهازکوانتیزاسیون» برعکس است: مدل از همان وسطِ آموزش میداند که قرار است فشرده شود، پس خودش را طوری تنظیم میکند که افت کیفیت جبران شود. انویدیا میگوید برای بولت ۷۴B از همین روش استفاده کرده و به پژوهشهای ICLR 2026 دربارهٔ مدلهای استدلالیِ فوقفشرده استناد میکند. این ادعای شرکت است؛ آزمون مستقل هنوز در کار نیست.
خبر دقیقاً چیست؟
انویدیا سهشنبه ۱۳ اکتبر (۲۱ مهر) در وبلاگ توسعهدهندگانش، بهروزرسانی کامل اکوسیستم نرمافزاریِ RTX Spark را اعلام کرد. RTX Spark پلتفرم تازهٔ لپتاپیِ انویدیاست که طبق اعلامیهٔ مشترک ۷ اکتبرِ انویدیا و مایکروسافت، جمعه ۱۶ اکتبر به بازار میآید. ستارهٔ آن اعلامیهٔ سهشنبه، همین مدل بود: نموترون ۳.۵ بولت ۷۴B-A9B 24GB.
انویدیا مدل را «ساختهشده برای هوش مصنوعی ایجنتمحور روی RTX Spark» توصیف میکند و میگوید سریعتر از بیشتر مدلهای متراکمِ محبوب و هوشمندتر از بیشتر مدلهای MoEِ همحافظه است. این جمله را دقیق بخوانید: ادعای شرکت است، نه نتیجهٔ بنچمارک مستقل. Tom's Guide هم تاریخ عرضه و هدف ۲۴ گیگابایتی را تأیید کرده، ولی هیچکس بیرون از انویدیا هنوز وزنها را لمس نکرده.
زمانبندی سه روز آینده
فردا، ۲۳ مهر (۱۵ اکتبر): انتشار نموترون ۳.۵ بولت ۷۴B.
پسفردا، ۲۴ مهر (۱۶ اکتبر): فروش لپتاپهای RTX Spark از لنوو، ایسر و شرکای دیگر انویدیا آغاز میشود.
۱ آبان (۲۳ اکتبر): مدل کوچکتر خانواده، بولت E4B با ۴ گیگابایت حافظه، برای کاراکترهای بازی و ایجنتهای مکالمهای میآید — و با پلتفرم SkyrimNET میتوانید آن را داخل بازی اسکایریم امتحان کنید.
مشخصات فنی روی یک جدول
جدول زیر همهٔ چیزی است که انویدیا تا امروز دربارهٔ مدل اعلام کرده. هر خانهای که خالی است، یعنی شرکت هنوز چیزی نگفته — نه اینکه ما چیزی پنهان کرده باشیم:
ویژگی | مقدار اعلامشده | منبع |
|---|---|---|
نام کامل | Nemotron 3.5 Bolt 74B-A9B 24GB | وبلاگ رسمی انویدیا |
پارامتر کل | ۷۴ میلیارد | وبلاگ رسمی انویدیا |
پارامتر فعال در هر پردازش | ۹ میلیارد | وبلاگ رسمی انویدیا |
حافظهٔ موردنیاز | ۲۴ گیگابایت | وبلاگ رسمی انویدیا؛ Tom's Guide تأیید کرده |
تکنیک فشردهسازی | کوانتیزاسیون ۲بیتی + آموزش آگاهازفشردهسازی | وبلاگ رسمی انویدیا |
وضعیت متنباز بودن | وزنها، دادههای آموزشی و دستورهای آموزش — هر سه | وبلاگ رسمی انویدیا |
ابزارهای اجرای روز عرضه | llama.cpp ،vLLM ،Ollama ،Unsloth ،LM Studio | وبلاگ رسمی انویدیا |
دسترسی از داخل ایجنتها | Hermes و OpenClaw | وبلاگ رسمی انویدیا |
تاریخ انتشار | ۱۵ اکتبر ۲۰۲۶ (۲۳ مهر) | وبلاگ رسمی انویدیا |
بنچمارک مستقل | اعلام نشده — وزنها هنوز عمومی نیستند | — |
قیمت | رایگان (متنباز)؛ قیمت لپتاپهای RTX Spark اعلام نشده | وبلاگ رسمی انویدیا |
جدول را اینطور بخوانید: سه ستون اول «خبر» است، ستون آخر «صداقت». هرچه در ستون منبع خالی است، یعنی در فضای خبریِ این هفته وجود خارجی ندارد.
چرا ۲۴ گیگابایت خبر مهمی است؟
اینجا عدد را با مقیاس بگوییم. یک مدل ۷۴ میلیارد پارامتریِ متراکم با دقت کامل، به گفتهٔ تحلیل TechTimes، به بیش از ۱۴۰ گیگابایت حافظه نیاز دارد — یعنی حدود شش برابر ۲۴ گیگابایت. این همان دیواری بود که «هوش مصنوعی محلی» را دو سال زمینگیر کرده بود: مدلهای خوب در ابر زندگی میکردند، چون در خانه جا نمیشدند.
بولت ۷۴B اگر ادعای انویدیا درست باشد، این دیوار را از دو طرف خراب میکند: معماری MoE هزینهٔ محاسبه را کم میکند و کوانتیزاسیون ۲بیتی هزینهٔ حافظه را. نتیجهٔ عملیاش این است که یک ایجنتِ همیشهروشن — مدلی که در پسزمینه کدنویسی میکند، داده جمع میکند، APIها را صدا میزند — میتواند روی دستگاه خودتان بنشیند، نه روی سرور اجارهای. انویدیا میگوید دانلود مدلهای محلی امسال پنج برابر کل پارسال شده؛ این مدل دقیقاً برای همان موج ساخته شده.
یک واقعبینی دربارهٔ «لپتاپ»
۲۴ گیگابایت «حافظهٔ کم» نیست. بیشتر لپتاپهای موجود در بازار چنین حافظهٔ یکپارچهای ندارند. این مدل روی RTX Spark با حافظهٔ یکپارچهٔ تا ۱۲۸ گیگابایت (Grace و Blackwell با اتصال NVLink-C2C) یا روی کارتهای گرافیک دسکتاپِ ۲۴ گیگابایتی معنا پیدا میکند. اگر لپتاپ معمولی دارید، فردا صبح نمیتوانید آن را دانلود کنید و انتظار معجزه داشته باشید — این را انویدیا نمیگوید، ولی واقعیت سختافزار است.
«کاملاً متنباز» یعنی چه و چرا مهم است؟
خیلی از شرکتها «متنباز» میگویند و منظورشان فقط این است که فایل وزنها را میتوانید دانلود کنید — بدون اینکه بدانید مدل با چه دادهای آموزش دیده و چطور میتوانید همان مسیر را تکرار کنید. انویدیا برای بولت ۷۴B سه چیز را وعده داده: وزنها، دادههای آموزشی، و «رسیپیها» یعنی دستورهای آموزش. اگر این وعده عملی شود، توسعهدهنده میتواند مدل را فاینتیون کند، رفتارش را تغییر دهد و برای کاربرد خودش سفارشیاش کند.
چرا دادهٔ آموزشی مهم است؟ چون بدون آن، نمیدانید مدل چه چیزی دیده و چه چیزهایی را ندیده — مثل پزشکی که سابقهٔ بیمار را ندارد. انتشار داده، اعتمادِ پژوهشگران و شرکتها را جلب میکند و مسیر بهبود مدل را باز میگذارد. البته «وعده» با «تحویل» فرق دارد؛ فردا که فایلها منتشر شدند، میبینیم انویدیا واقعاً چه چیزی گذاشته.
فردا از کجا و چطور اجرایش کنیم؟
انویدیا پنج ابزار را برای روز عرضه نام برده. اگر تازهکارید، لازم نیست هر پنجتا را بشناسید — یکی کافی است:
برای شروعکنندهها: سادهترین راه
اگر تا حالا مدل محلی اجرا نکردهاید، راهنمای نصب و اجرای مدلها با Ollama را که در فناوریکده منتشر کردهایم بخوانید؛ Ollama سادهترین مسیر برای دانلود و اجرای مدلهاست و انویدیا هم آن را در فهرست روز عرضه گذاشته. LM Studio هم رابط گرافیکیِ دوستانهای دارد. نکتهٔ مهم: قبل از دانلود، مطمئن شوید دستگاهتان ۲۴ گیگابایت حافظهٔ آزاد دارد.
برای سازندگان ایجنت: مسیر حرفهای
اگر توسعهدهندهاید، llama.cpp و vLLM و Unsloth گزینههای فنیترند — Unsloth برای فاینتیون سریع شناخته شده و vLLM برای سرویسدهی. و اگر میخواهید مدل را داخل یک ایجنتِ واقعی ببینید، Hermes و OpenClaw از روز عرضه به آن دسترسی میدهند. جالب اینجاست که روتر هوش مصنوعی شخصی (PAIR) انویدیا هم که همین هفته از بتا خارج شد، میتواند کارهای استنباط را بین چند کامپیوتر شبکهٔ خانگیتان پخش کند — ترکیب این دو، یعنی ایجنتِ قدرتمند بدون اشتراک ابری.
امنیت: ایجنت محلی چطور کامپیوترتان را به خطر نمیاندازد؟
سؤالی که هر خوانندهٔ عاقلی میپرسد: اگر یک ایجنت بتواند روی کامپیوترم هر کاری بکند، چه چیزی جلوی یک دستور مخرب یا یک «تزریق پرامپت» را میگیرد؟ پاسخ انویدیا دو لایه است. لایهٔ اول «کانتینرهای اجرایی مایکروسافت» یا MXC است — یعنی جداسازی در سطح سیستمعامل که ایجنت را در یک محفظهٔ امن میدواند. لایهٔ دوم چارچوب امنیتی OpenShell است که روی همان محفظه سوار میشود و محافظت از اعتبارنامهها و پایش امنیتی اضافه میکند.
طبق اعلام انویدیا، GitHub Copilot و OpenClaw همین حالا از MXC پشتیبانی میکنند و Hermes تا آخر اکتبر اضافه میکند. موقع اولین روشنشدن RTX Spark، یک صفحهٔ «شروع کار» به شما پیشنهاد میدهد کدام اپ ایجنت را نصب کنید و همانجا مدل و تنظیمات بهینه را برای دستگاهتان پیشنهاد میدهد. برای کاربر عادی، این یعنی تجربهای نزدیک به نصب یک اپ موبایل — نه دستوپنجه نرم کردن با ترمینال.
رقابت و زمینه: دو راه برای حل «بحران حافظه»
بولت ۷۴B تنها تلاش این هفته برای حل مشکل حافظه نیست. دو روز پیش، سامسونگ مدل LittleBit-2 را معرفی کرد که از مسیر دیگری به همان دیوار حمله میکند: فشردهسازیِ زیرِ یک بیت. جدول زیر این دو مسیر را کنار هم میگذارد — هر دو خبر این هفته، هر دو برای یک مشکل:
| نموترون ۳.۵ بولت ۷۴B (انویدیا) | LittleBit-2 (سامسونگ) |
|---|---|---|
سازنده | انویدیا | سامسونگ |
تاریخ اعلام | ۱۳ اکتبر ۲۰۲۶ | ۱۲ اکتبر ۲۰۲۶ |
رویکرد فشردهسازی | کوانتیزاسیون ۲بیتی + آموزش آگاهازفشردهسازی | فشردهسازی زیر یک بیت |
وضعیت | انتشار ۱۵ اکتبر؛ کاملاً متنباز | معرفی پژوهشی |
هدف اعلامشده | ایجنتهای محلی در ۲۴ گیگابایت حافظه | کاهش حافظهٔ مدلهای بزرگ |
خوانش جدول: انویدیا مسیر «محصول» را رفته — مدل آماده، ابزار آماده، تاریخ عرضه مشخص. سامسونگ مسیر «پژوهش» را. هر دو میگویند آیندهٔ هوش مصنوعی، مدلی است که در جیبِ سختافزار شما جا شود، نه در دیتاسنتر.
چیزهایی که هنوز روشن نیست
کیفیت واقعی: هیچ بنچمارک مستقلی وجود ندارد. ادعای «سریعتر از مدلهای متراکم و هوشمندتر از مدلهای MoE همحافظه» فعلاً فقط حرف انویدیاست.
رفتار ۲بیت در عمل: کوانتیزاسیون ۲بیتی تهاجمی است؛ معلوم نیست در استدلالهای طولانی یا زبانهای غیرانگلیسی چقدر افت میکند.
قیمت لپتاپها: انویدیا هنوز قیمت RTX Spark را اعلام نکرده؛ فقط میدانیم از لنوو و ایسر میآیند.
پنجرهٔ زمینه: انویدیا دربارهٔ طول پنجرهٔ زمینه یعنی «حافظهٔ یکبارهٔ خواندن» مدل چیزی نگفته — برای ایجنتها که با اسناد بلند کار میکنند، عدد مهمی است.
جزئیات لایسنس: «کاملاً متنباز» دقیقاً با کدام لایسنس؟ فردا که فایلها آمدند مشخص میشود.
نکتهای برای خوانندگان فارسیزبان
این خبر برای شما یک زاویهٔ ویژه دارد: چون مدل متنباز است، برای دانلود و اجرایش به حساب کاربری، اشتراک یا API خارجی نیاز ندارید — همان چیزی که معمولاً برای کاربران ایرانی دردسرساز است. وزنها روی هاستهایی مثل هاگینگفیس قرار میگیرند و اجرای محلی یعنی دادهتان هم از دستگاهتان بیرون نمیرود.
دو احتیاط: اول، دربارهٔ عملکرد مدل در زبان فارسی هنوز هیچ دادهای نیست؛ مدلهای ایجنتمحور معمولاً روی انگلیسی بهینهاند. دوم، اگر سختافزار مناسب ندارید، عجله نکنید — نسخههای کوچکتر و بهینهترِ جامعه (مثل نسخههای Unsloth) معمولاً چند هفته بعد از انتشار اصلی میرسند و برای سختافزارهای ضعیفتر مناسبترند.
جمعبندی
نموترون ۳.۵ بولت ۷۴B مهم است چون یک وعدهٔ قدیمی را جدی میگیرد: هوش مصنوعیِ قدرتمندِ بدون ابر. اگر انویدیا فردا واقعاً وزنها، دادهها و دستورهای آموزش را منتشر کند و اگر کیفیت ۲بیتی در عمل حفظ شود، آنوقت میشود گفت نقطهٔ عطفی برای ایجنتهای محلی رخ داده. «اگر»های این جمله را جدی بگیرید.
توصیهٔ عملی: اگر توسعهدهندهاید و سختافزار مناسب دارید، فردا مدل را بگیرید و خودتان تست کنید — هیچ بنچمارکی جای آزمونِ روی کاربردِ خودتان را نمیگیرد. اگر کاربر عادیاید، صبر کنید تا هفتهٔ آینده که بررسیهای مستقل آمد؛ آنوقت با چشم باز تصمیم میگیرید. و در هر صورت، حواستان به مدل کوچکتر خانواده در ۱ آبان باشد — شاید همان چیزی باشد که واقعاً به کارتان میآید.
سؤالهای پرتکرار
نموترون ۳.۵ بولت دقیقاً چه مدلی است؟
یک مدل زبانی ۷۴ میلیارد پارامتری با معماری «ترکیبی متخصصان» که فقط ۹ میلیارد پارامترش در هر لحظه فعالاند. انویدیا آن را برای ایجنتهای هوش مصنوعیِ همیشهروشن روی لپتاپهای RTX Spark ساخته و فردا، ۲۳ مهر، منتشرش میکند.
۲۴ گیگابایت یعنی با چه سختافزاری اجرایش کنم؟
به ۲۴ گیگابایت حافظهٔ آزاد نیاز دارید: لپتاپهای RTX Spark با حافظهٔ یکپارچه، کارتهای گرافیک دسکتاپ ۲۴ گیگابایتی، یا مکهای با حافظهٔ یکپارچهٔ بالا. روی لپتاپ معمولی با ۸ یا ۱۶ گیگابایت رم، این مدل جا نمیشود.
مدل واقعاً متنباز است یا فقط وزنها بازند؟
طبق اعلام انویدیا، هر سه منتشر میشود: وزنها، دادههای آموزشی و دستورهای آموزش. این فراتر از «وزنِ باز» است، ولی جزئیات لایسنس هنوز اعلام نشده و باید فردا بررسی شود.
آیا بدون لپتاپ RTX Spark هم کار میکند؟
بله. انویدیا میگوید مدل از روز عرضه روی llama.cpp، vLLM، Ollama، Unsloth و LM Studio اجرا میشود — یعنی روی هر سختافزاری که ۲۴ گیگابایت حافظه داشته باشد، نه فقط RTX Spark.
چه فرقی با مدلهای متراکم ۷۰ میلیاردی دارد؟
مدل متراکم همهٔ پارامترهایش را برای هر کلمه فعال میکند و به ۱۴۰+ گیگابایت حافظه نیاز دارد. بولت فقط ۹ میلیارد پارامتر را فعال میکند و با فشردهسازی ۲بیتی در ۲۴ گیگابایت مینشیند. ادعای انویدیا این است که کیفیتش هم حفظ شده — ادعایی که هنوز آزمون مستقل ندارد.
بنچمارک مستقلی از آن هست؟
نه. وزنها هنوز عمومی نشدهاند و همهٔ اعداد و مقایسهها، ادعای خود انویدیاست. انتظار میرود از فردا که مدل منتشر شد، بنچمارکهای مستقل یکییکی بیایند.
از ایران میشود دانلود و اجرایش کرد؟
چون مدل متنباز است، به حساب کاربری یا اشتراک خارجی نیاز ندارد و از هاستهای عمومی مثل هاگینگفیس قابل دانلود است. اجرای محلی هم یعنی دادهتان از دستگاهتان خارج نمیشود. دربارهٔ کیفیتش در زبان فارسی هنوز دادهای در دست نیست.
با PAIR و Ollama چه نسبتی دارد؟
Ollama یکی از پنج ابزار رسمیِ روز عرضه است — سادهترین راه برای اجرای مدل. PAIR هم ابزار جداگانهٔ انویدیاست که کارهای استنباط را بین چند کامپیوتر شبکهٔ خانگی پخش میکند؛ ترکیب این دو یعنی میتوانید مدل را روی چند دستگاهتان توزیع کنید.