فهرست مطالب
انویدیا اعلام کرد که پلتفرم کامل Run:ai — نرمافزاری که GPUهای یک دیتاسنتر را بین تیمها تقسیم میکند و کارهای هوش مصنوعی را زمانبندی میکند — از این پس کاملاً متنباز است. این خبر روز ۱۳ اکتبر ۲۰۲۶ (۲۱ مهر ۱۴۰۵) منتشر شد و یعنی ابزاری که انویدیا دو سال پیش با حدود ۸۰۰ میلیون دلار خریده بود، حالا برای همهٔ تیمهای توسعه قابل دانلود و استفاده است.
چرا باید برایت مهم باشد؟ چون مشکل این روزهای دنیای هوش مصنوعی فقط «نداشتن GPU کافی» نیست؛ «بیاستفاده ماندن GPUهای موجود» هم هست. Run:ai دقیقاً به همین درد میخورد: اینکه از کارتهای گرافیکی که همین حالا داری، بیشتر کار بکشی. در این مطلب میبینی دقیقاً چه چیزی متنباز شده، هر بخشش به چه درد میخورد و اگر اهل زیرساخت یا توسعهٔ هوش مصنوعی هستی، از کجا باید شروع کنی.
پاسخ کوتاه
چه شد؟ انویدیا کل پلتفرم Run:ai را متنباز کرد؛ یعنی کد کاملش روی گیتهاب است و بدون لایسنس تجاری میشود نصب و استفادهاش کرد.
Run:ai چیست؟ یک ارکستراتور GPU برای کوبرنتیز: GPUهای مشترک را بین تیمها و پروژهها تقسیم میکند و ورکلودهای آموزشی و استنتاجی را زمانبندی میکند.
چه چیزهایی جداگانه قابل استفادهاند؟ چهار کامپوننت مستقل: KAI Scheduler، GPU Fractioning Operator، KAI Resource Management و Workload Map — بهعلاوهٔ دو پروژهٔ همراه: Model Streamer و Grove.
قیمتش چقدر است؟ نسخهٔ متنباز (Community) رایگان است و به اشتراک پولی انویدیا نیاز ندارد، ولی پشتیبانی سازمانی انویدیا را هم شامل نمیشود.
چرا الان مهم است؟ چون صنعت به نقطهای رسیده که «بهرهوری از GPUهای موجود» بهاندازهٔ «خرید GPUهای جدید» حیاتی شده؛ و این همان ضلعی از مثلث است که مایا ۳۰۰ مایکروسافت و لیتلبیت-۲ سامسونگ دو ضلع دیگرش را میسازند.
اول زمینه: Run:ai چیست؟
ارکستراسیون GPU یعنی چه؟
تصور کن یک شرکت ۱۰ کارت گرافیک قدرتمند دارد و ۵ تیم مختلف میخواهند همزمان مدل آموزش بدهند، چتبات تست کنند و نوتبوک تعاملی اجرا کنند. اگر هر تیم برای خودش کارت بگیرد، بیشتر وقتها نصف کارتها بیکار میمانند؛ اگر هم همه بدون قانون روی یک استخر مشترک بریزند، یک تیم پرمصرف بقیه را قفل میکند. ارکستراسیون GPU یعنی یک «مدیر سالن» هوشمند که تصمیم میگیرد چه کاری، کی، روی کدام کارت و با چه سهمیهای اجرا شود — با قوانین منصفانه بین تیمها.
Run:ai دقیقاً همین مدیر سالن است، ولی برای کوبرنتیز (یعنی سکوی استاندارد اجرای نرمافزار در دیتاسنترها و ابر). به گفتهٔ انویدیا، این پلتفرم منابع GPU را بهصورت پویا تخصیص میدهد و ورکلودها را در کل چرخهٔ حیاتشان — از پردازش داده و آموزش تا استنتاج — مدیریت میکند.
یک مثال ملموس برای تو
اگر تا حالا با کوبرنتیز کار کرده باشی، میدانی که زمانبند پیشفرضش برای کارهای معمولی وب خوب است ولی برای هوش مصنوعی کم میآورد: یک آموزش توزیعشده ممکن است به ۸ کارت نیاز داشته باشد که باید همزمان آزاد باشند، نه یکییکی. یا یک مدل کوچک استنتاجی شاید فقط به یکدهم حافظهٔ یک کارت نیاز داشته باشد و گرفتن کل کارت برایش اسراف است. Run:ai برای همین دو جور دردسر ساخته شده: یکی «زمانبندی دستهایِ همهیا-هیچ» و دیگری «تقسیم یک GPU بین چند کار».
دقیقاً چه اتفاقی افتاد؟
انویدیا روز ۲۱ مهر ۱۴۰۵ در وبلاگ توسعهدهندگانش اعلام کرد که پلتفرم کامل Run:ai را بهصورت نرمافزار متنباز منتشر کرده است. این انتشار بخشی از چیزی است که انویدیا «پلتفرم کارخانهٔ هوش مصنوعی DSX» مینامد؛ یعنی مجموعهٔ نرمافزارهای باز و ماژولاری که قرار است زیرساخت کارخانههای هوش مصنوعی را بسازند.
چه چیزی دقیقاً متنباز شد؟
نه فقط یک کتابخانهٔ کوچک: کل پلتفرم، بهعلاوهٔ چهار کامپوننتی که میشود جداگانه هم ازشان استفاده کرد — KAI Scheduler، GPU Fractioning Operator، KAI Resource Management و Workload Map. کد کامل روی گیتهاب، داخل سازمان «NVIDIA DSX AI Factory» قرار گرفته و نسخهٔ آمادهٔ نصب هم بهصورت «محصول اجتماع» (Community Product) روی NGC انویدیا با چارت Helm منتشر شده است.
DSX AI Factory یعنی چه؟
DSX مخفف همان اکوسیستم نرمافزاری انویدیاست که دور «کارخانهٔ هوش مصنوعی» ساخته شده؛ یعنی دیتاسنترهایی که خروجیشان بهجای کالا، «هوش» است: مدلهای آموزشدیده و توکنهای استنتاج. با متنباز شدن Run:ai، انویدیا میخواهد شریکهای اکوسیستمش — از ارائهدهندههای ابری تا سازندههای پلتفرم — سریعتر بتوانند همین قابلیتها را داخل محصول خودشان بگذارند. به زبان ساده: انویدیا دارد استاندارد نرمافزاریِ مدیریت GPU را به همه میدهد تا بازارش بزرگتر شود.
داستان Run:ai؛ از استارتاپ تا بازوی انویدیا
Run:ai یک استارتاپ اسرائیلی بود که انویدیا در اواخر سال ۲۰۲۴ خریدش؛ معاملهای که طبق گزارش تککرانچ در ۳۰ دسامبر ۲۰۲۴ نهایی شد و به گفتهٔ CTech ارزشش حدود ۸۰۰ میلیون دلار برآورد میشد — آن هم بعد از حدود هشت ماه بررسی رگولاتوری در آمریکا و اروپا. حالا چرا انویدیا چیزی را که با این قیمت خریده، رایگان میکند؟
وعدهای که بنیانگذاران داده بودند
به گفتهٔ CTech، بنیانگذاران Run:ai — عمری گلر و دکتر رونن دار — همان موقع خرید گفته بودند که متنباز شدن، دامنهٔ Run:ai را از GPUهای خود انویدیا فراتر میبرد. یعنی از روز اول قرار بود این اتفاق بیفتد و حالا آن وعده عملی شده. برای تو بهعنوان خواننده، نکتهٔ مهمش این است: این یک تصمیم تاکتیکیِ لحظهای نیست؛ بخشی از استراتژی بلندمدت انویدیاست که نرمافزار مدیریت GPU را به یک استاندارد باز تبدیل کند.
چهار کامپوننت اصلی؛ و یک جدول برای مقایسهٔ سریع
جدول زیر چهار بخشی را نشان میدهد که انویدیا میگوید میشود جداگانه هم به کارشان برد؛ یعنی لازم نیست کل پلتفرم را نصب کنی تا از یک قابلیتش استفاده کنی. بعد از جدول، هر کدام را ساده توضیح میدهیم.
کامپوننت | به زبان ساده چه میکند؟ | به درد چه کسی میخورد؟ |
|---|---|---|
KAI Scheduler | مغز زمانبندی؛ تصمیم میگیرد هر کار کی و کجا اجرا شود | تیمهایی با کلاستر مشترک و چند ورکلود همزمان |
GPU Fractioning Operator | یک GPU را به چند سهم حافظهای تقسیم میکند | کسانی که نوتبوک یا مدلهای کوچک اجرا میکنند |
KAI Resource Management | سهمیهٔ هر تیم و دپارتمان را مدیریت میکند | سازمانهایی با چند تیم روی یک زیرساخت |
Workload Map | قرارداد مشترک برای شناخت انواع ورکلودها | سازندههای پلتفرم و ابزارهای مانیتورینگ |
جدول را اینطور بخوان: دو ردیف اول (Scheduler و Fractioning) به «اجرای بهینهٔ کارها» مربوطاند و دو ردیف بعدی به «مدیریت سازمانی و یکپارچگی ابزارها». اگر فقط یک درد داری — مثلاً GPUهایت بیکار میمانند — احتمالاً همان یک کامپوننت کارت را راه میاندازد.
KAI Scheduler؛ مغز برنامهریزی
KAI Scheduler زمانبند بومی کوبرنتیز است که قلب Run:ai محسوب میشود. انویدیا آن را تحت لایسنس Apache 2.0 منتشر کرده و به بنیاد CNCF هم بهعنوان پروژهٔ Sandbox سپرده است؛ یعنی از این به بعد همهٔ توسعهٔ زمانبند در مخزن عمومی جامعه انجام میشود و انویدیا میگوید از نگهدارندههای پروژه حمایت میکند.
قابلیتهایش را که میخوانی، میفهمی چرا برای هوش مصنوعی ساخته شده: «زمانبندی گروهی» (یعنی اگر کاری به ۸ کارت نیاز دارد، هر ۸ کارت را با هم میگیرد یا اصلاً شروع نمیکند — نه اینکه ۵ تایش را بگیرد و ۳ تای دیگر را برای همیشه منتظر بگذارد)، «سهم عادلانه» بین صفهای مختلف، «آگاهی از توپولوژی» (یعنی میداند کدام کارتها با لینک سریعتر به هم وصلاند و کارها را همانجا میچیند)، و پشتیبانی از روشهای اشتراک GPU مثل MIG و MPS. به گفتهٔ انویدیا، میشود آن را کنار استک فعلیات در یک کلاستر موجود هم نصب کرد، بدون اینکه کل پلتفرم Run:ai لازم باشد.
GPU Fractioning Operator؛ یک GPU برای چند نفر
خیلی از کارهای روزمره — نوتبوک تعاملی، جلسهٔ توسعه، استنتاج مدل کوچک — به کل حافظهٔ یک کارت قدرتمند نیاز ندارند. این اپراتور اجازه میدهد چند ورکلود یک GPU را با هم شریک شوند، در حالی که درایور CUDA برای هر کدام یک «سقف سخت» حافظه اعمال میکند؛ یعنی هر کار فقط همان سهم خودش را میبیند و نمیتواند به حافظهٔ بقیه دست بزند. نکتهٔ فنی مهم: انویدیا میگوید پیادهسازی اختصاصی قدیمیاش را بازنشسته کرده و حالا از قابلیت بومی CUDA 13.4 استفاده میکند. این کامپوننت به زمانبند خاصی وابسته نیست و یک صادرکنندهٔ متریک هم دارد تا ببینی هر پاد دقیقاً چقدر سهم مصرف میکند.
KAI Resource Management؛ لایهٔ سازمانی
اگر زمانبند تصمیم میگیرد «کار کجا برود»، این لایه تصمیم میگیرد «چه کسی چقدر حق دارد». ساختار سازمانی — پروژهها و دپارتمانها — را تعریف میکند، ظرفیت GPU را بینشان با منطق سهم عادلانه و سهمیه تقسیم میکند و با «استخر نود» سختافزارهای ناهمگن را گروهبندی میکند تا هر کار روی سختافزار درستش بنشیند. مثال خود انویدیا: یک تیم پلتفرم میتواند ۵۰ درصد کلاستر را برای تیم تحقیق تضمین کند و در عین حال نگذارد هیچ تیمی بقیهٔ ظرفیت را انحصاری بگیرد. اگر تا حالا سهمیهها را با اکسل یا ساخت دستی نیماسپیس مدیریت میکردی، این همان لایهای است که جایگزینش میشود.
Workload Map؛ قرارداد مشترک برای همهٔ انواع ورکلود
در دنیای واقعی کوبرنتیز، یک «کار هوش مصنوعی» تقریباً هیچوقت یک Deployment ساده نیست؛ یک PyTorchJob است، یک RayCluster، یک KServe InferenceService یا یک گراف Dynamo. هر کدام ساختار داخلی خودشان را دارند. Workload Map یک قرارداد یکسان تعریف میکند تا همهٔ اینها بهعنوان «شیء درجهیک» شناخته شوند: توصیف پادها و نقشها، ارسال و پیکربندی، زمانبندی با آگاهی گروهی و توپولوژی، و مشاهدهٔ یکدست وضعیت. بهصورت یک کتابخانهٔ Go عرضه میشود که حتی آفلاین هم کار میکند؛ و عمداً محدودهاش باریک نگه داشته شده: فقط «ساختار ورکلود» را توصیف میکند و خودش زمانبندی یا مقیاسدهی نمیکند.
دو پروژهٔ همراه: Model Streamer و Grove
کنار چهار کامپوننت اصلی، انویدیا دو پروژهٔ متنباز مکمل را هم معرفی کرده که هر کدام یک درد مشخص را هدف گرفتهاند.
Model Streamer؛ خداحافظی با انتظار چنددقیقهای
شروع سرد (cold-start) یک ورکلود استنتاج روی کوبرنتیز گاهی چند دقیقه طول میکشد؛ و بدترین بخشش این است که در تمام این مدت، GPU تخصیص داده شده ولی بیکار است — فقط دارد وزنهای مدل را از حافظهٔ ذخیرهسازی به حافظهٔ کارت منتقل میکند. Model Streamer وزنها را همزمان میخواند و مستقیم به حافظهٔ GPU استریم میکند.
عددهایی که منتشر شده چشمگیرند، ولی با احتیاط بخوانشان چون تست مستقل ما نیستند و خود شرکتها گزارششان دادهاند: WEKA میگوید بارگذاری در ۳.۵ ثانیه انجام شده — حدود ۴۰ درصد سریعتر از خواندن از NVMe محلی. VAST Data عدد ۱.۷ ثانیه را گزارش کرده (۶۰ درصد بهبود). DDN میگوید مدل ۶۵.۵ گیگابایتی Qwen3-32B را روی ۸ کارت در کمتر از ۴ ثانیه استریم کرده و این یعنی صرفهجویی تا ۱۰ درصد از زمان اجرای روزانهٔ GPU. مایکروسافت هم در بنچمارکهای منتشرشدهاش برای آژور میگوید ۳ تا ۶ برابر سریعتر از لودر پیشفرض، با throughput پایدار ۸۰ گیگابیت بر ثانیه در برابر حدود ۴۰ گیگابیت مسیر پیشفرض.
از نظر پذیرش هم جلو رفته: بهصورت upstream داخل vLLM و SGLang ادغام شده (با فلگ --load-format runai_streamer)، داخل کانتینر vLLM Deep Learning آمازون (AWS) عرضه میشود و مسیر پیشنهادی مستندات EKS است، گوگل کلاد پشتیبانی بومی Cloud Storage را با همکاری انویدیا اضافه کرده و مستندات GKE دارد، و آژور هم یکپارچهسازی Blob Storage را با همکاری انویدیا توسعه داده. اگر با vLLM یا SGLang سرویس میدهی، این همان چیزی است که میتواند تأخیر اسکیلآپت را از دقیقه به ثانیه برساند.
Grove؛ یک API برای هر معماری استنتاج
الگوهای جدید ورکلود — مثل پایپلاینهای ایجنتیک، سروینگ تفکیکشده (disaggregated serving) و آموزش مدلهای MoE — از چند جزء بههمپیوسته تشکیل شدهاند که باید با هم مقیاس بگیرند. Grove یک API کوبرنتیزی برای ارکستراسیون همینهاست: از یک پاد تا استقرارهایی روی دهها هزار GPU. مقیاسدهی خودکارِ آگاه از توپولوژی و زمانبندی گروهی سلسلهمراتبی دارد؛ مثلاً اجزای prefill و decode را بهصورت واحدهای همهیا-هیچ بالا میآورد. روی رک GB200 NVL72 — یعنی رک ۷۲ پردازندهٔ گرافیکی انویدیا — منابع ComputeDomain را هم خودکار مدیریت میکند. Grove بخشی ماژولار از پروژهٔ NVIDIA Dynamo است ولی مستقل هم قابل استفاده است.
از کجا و چطور شروع کنی؟
دو مسیر داری: مستقیم و از طریق شریکهای اکوسیستم. مسیر مستقیم یعنی کد را از گیتهاب (سازمان NVIDIA DSX AI Factory) برداری، بررسیاش کنی و با چارت Helm نسخهٔ Community را از NGC نصب کنی. برای دانلود محصول Community از NGC باید توافقنامهٔ لایسنس نرمافزار انویدیا را بپذیری، ولی به گفتهٔ انویدیا نه اشتراک پولی لازم است نه مجوز پشتیبانی.
مسیر شریکها؛ اگر نمیخواهی خودت نگهش داری
اگر حوصلهٔ نصب و نگهداری نداری، چند شریک از روز اول محصول آماده دارند: vCluster قالبهای استقرار ازپیشآزمودهشده میدهد که برای هر مستأجر یک محیط کامل بالا میآورد (و طبق بیانیهشان بدون لایسنس تجاری انویدیا)؛ Nebius آن را بهصورت اپلیکیشن تککلیکی روی ابر خودش عرضه کرده؛ OpenNebula یکپارچهسازیاش را از طریق سرویس OneKS انجام داده و گواهی سازگاری انویدیا را هم گرفته؛ Mirantis آن را داخل k0rdent AI برده؛ و Lambda میگوید از ۲۰۲۲ از Run:ai روی زیرساختش پشتیبانی میکرده و حالا زمانبند متنبازش را برای سرویس کوبرنتیزش آماده میکند. اگر مشتری یکی از اینها هستی، عملاً بدون نصب دستی به Run:ai میرسی.
یک نکتهٔ فنی برای شروع
لازم نیست همهچیز را یکجا برداری. اگر فقط زمانبندت ضعیف است، KAI Scheduler را کنار استک فعلیات نصب کن. اگر مشکلت شروع سرد استنتاج است، Model Streamer را با همان فلگ vLLM امتحان کن. ماژولار بودن، دقیقاً برای همین طراحی شده.
رایگان، ولی بدون پشتیبانی سازمانی؛ یعنی چه؟
این مهمترین نکتهٔ ظریف خبر است و باید شفاف بگویمش: نسخهٔ متنباز، پشتیبانی سازمانی انویدیا را شامل نمیشود. یعنی اگر وسط شب کلاسترت خوابید، نمیتوانی به پشتیبانی انویدیا تیکت بزنی. برای سازمانهایی که به پشتیبانی و SLA نیاز دارند، انویدیا نسخهٔ «واجد پشتیبانی» (Support-Entitled) را نگه داشته که همان کد باز است ولی با قرارداد پشتیبانی تجاری — بهعلاوهٔ مسیرهای تجاری مثل Mission Control و NVIDIA AI Enterprise.
برای تو این یعنی یک تصمیم دو راهی ساده: اگر تیم کوچکی هستی یا میخواهی یاد بگیری و آزمایش کنی، نسخهٔ Community کافی است و هزینهای ندارد. اگر زیرساخت تولیدیِ حساس داری که قطعیاش گران تمام میشود، باید یا قرارداد پشتیبانی بگیری یا از یکی از شریکهای مدیریتی (مثل vCluster یا Rafay) سرویس بگیری. «متنباز» به معنی «بدون هزینهٔ پنهان» نیست؛ به معنی «بدون قفل لایسنسی» است.
چرا این خبر دقیقاً الان مهم است؟
صنعت هوش مصنوعی به یک تنگنای عجیب رسیده: از یک طرف همه دنبال GPU بیشترند، از طرف دیگر مطالعات و تجربهٔ اپراتورها نشان میدهد بخش بزرگی از ظرفیت GPUهای موجود بیاستفاده میماند. خرید کارت جدید ماهها صف و میلیونها دلار هزینه دارد؛ ولی بالا بردن بهرهوری همان کارتهایی که داری، یک بهروزرسانی نرمافزاری است. انویدیا با متنباز کردن Run:ai دارد روی همین منطق شرط میبندد.
مثلث بهرهوری: سیلیکون، مدل، عملیات
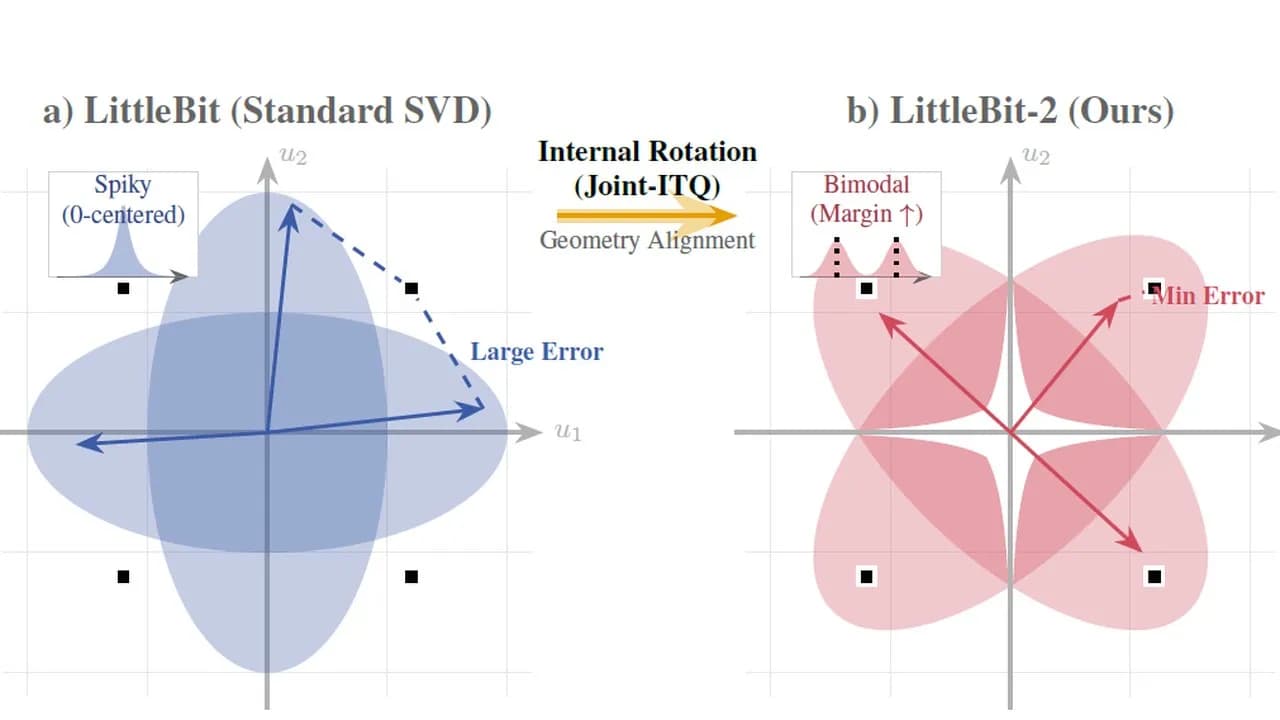
اگر دو مطلب اخیر فناوریکده را خوانده باشی، تصویر کامل میشود: مایا ۳۰۰ مایکروسافت ضلع «سیلیکون» است — تراشهای که بهازای هر مگاوات برق، توکن بیشتری تحویل میدهد. لیتلبیت-۲ سامسونگ ضلع «مدل» است — فشردهسازی زیر یک بیت که مدلها را سبکتر میکند. و Run:ai ضلع «عملیات» است — نرمافزاری که مطمئن میشود همان سختافزار و همان مدلها، بیکار نمانند. هر سه یک سؤال را جواب میدهند: «از هر وات و هر گیگابایت حافظه، چطور بیشتر کار بکشیم؟» اگر اهل دنبال کردن روندهای زیرساختی هستی، این سهتایی را کنار هم نگه دار.
این خبر برای خوانندهٔ فارسیزبان چه معنایی دارد؟
چند نکتهٔ عملی و صادقانه. اول: کد متنباز روی گیتهاب برای همه قابل دسترسی است؛ این جنس خبرها معمولاً کمترین اصطکاک تحریمی را دارند چون محصول تجاری فروخته نمیشود، ولی پیشنهاد همیشگی ما پابرجاست — شرایط سرویس انویدیا، NGC و هر شریک ابری را خودت چک کن، چون ما وکیل تحریم نیستیم و قوانین عوض میشوند.
دوم: اگر دانشجو یا توسعهدهندهای و میخواهی «مهندسی پلتفرم هوش مصنوعی» یاد بگیری، این یک کلاس درس رایگان است. کد واقعیِ زمانبندی GPU در مقیاس تولید، حالا جلوی چشم توست؛ چیزی که تا دیروز پشت درهای بستهٔ یک محصول تجاری بود. سوم: اگر در شرکتی کار میکنی که GPU دارد ولی همیشه دعوا بر سر «کی کارت را گرفته» است، KAI Scheduler یا GPU Fractioning میتواند همان دعوا را با قانون حل کند — بدون اینکه یک ریال لایسنس بدهی.
و یک نکتهٔ واقعبینانه: بیشتر شریکهای «تککلیکی» مثل Nebius و Lambda سرویسهاییاند که دسترسی از ایران به آنها ساده نیست. پس مسیر واقعبینانه برای تو، همان نصب مستقیم از گیتهاب روی زیرساخت خودت است — که اتفاقاً همان مسیری است که انویدیا اول معرفیاش کرده.
چیزهایی که هنوز روشن نیست
گاورننس جامعه: انویدیا میگوید از نگهدارندهها حمایت میکند، ولی هنوز روشن نیست تصمیمهای فنی آینده دقیقاً با چه سازوکاری گرفته میشود و چقدر به جامعه واگذار میشود.
پشتیبانی از GPUهای غیرانویدیا: بنیانگذاران گفته بودند متنباز شدن دامنه را فراتر از GPUهای انویدیا میبرد، ولی در اعلامیهٔ فعلی جزئیات مشخصی دربارهٔ پشتیبانی از سختافزارهای دیگر نیامده.
نقشهٔ راه نسخهٔ تجاری: مرز دقیق امکانات بین نسخهٔ Community و نسخههای تجاری (مثل Mission Control) هنوز شفاف نیست و ممکن است در عمل مهم شود.
عددهای واقعی در محیط تو: بنچمارکهای WEKA و DDN روی پیکربندیهای خاص خودشان گرفته شدهاند؛ عدد شروع سرد در زیرساخت تو میتواند متفاوت باشد. ما اینها را تست نکردهایم.
جمعبندی: حالا چه کار کنی؟
انویدیا ابزاری را که با حدود ۸۰۰ میلیون دلار خریده بود، حالا رایگان در اختیار همه گذاشته — نه از سر خیرخواهی، بلکه چون میخواهد استاندارد مدیریت GPU را خودش تعریف کند. برای تو سه مسیر وجود دارد: اگر فقط کنجکاوی، مخزن گیتهاب را ببین و معماریاش را بخوان؛ اگر با vLLM یا SGLang سرویس میدهی، Model Streamer را با یک فلگ امتحان کن و ببین شروع سردت چقدر کم میشود؛ و اگر کلاستر مشترک داری که همیشه بر سر GPU دعواست، KAI Scheduler را در یک محیط آزمایشی بالا بیاور. کاری که نباید بکنی این است که این خبر را فقط «یک خبر خوب دیگر» بدانی و رد شوی — چون این یکی، ابزار کار است، نه فقط خبر.
پرسشهای متداول
آیا Run:ai واقعاً کاملاً رایگان است؟
نسخهٔ Community بله: دانلود و استفادهاش هزینهٔ لایسنس ندارد و به اشتراک پولی انویدیا نیاز نیست. ولی پشتیبانی سازمانی انویدیا را شامل نمیشود؛ اگر SLA میخواهی باید نسخهٔ Support-Entitled یا سرویس شریکها را بگیری.
برای استفاده از Run:ai حتماً باید کل پلتفرم را نصب کنم؟
نه. چهار کامپوننت اصلی — از جمله KAI Scheduler و GPU Fractioning Operator — جداگانه هم قابل نصباند. حتی میتوانی فقط KAI Scheduler را کنار استک فعلیات در کلاستر موجودت اجرا کنی.
تفاوت KAI Scheduler با زمانبند پیشفرض کوبرنتیز چیست؟
زمانبند پیشفرض برای کارهای معمولی طراحی شده؛ KAI برای ورکلودهای GPU ساخته شده: زمانبندی گروهیِ همهیا-هیچ، سهم عادلانه بین تیمها، آگاهی از توپولوژی شبکهٔ کارتها و پشتیبانی از اشتراک GPU. به زبان ساده، همان کاری را میکند که زمانبند معمولی برای هوش مصنوعی بلد نیست.
Model Streamer به چه دردی میخورد؟
زمان «شروع سرد» استنتاج را کم میکند؛ یعنی فاصلهٔ بین درخواست اسکیلآپ تا آماده شدن مدل. بهجای خواندن ترتیبی وزنها از دیسک، آنها را همزمان میخواند و مستقیم به حافظهٔ GPU استریم میکند. در vLLM و SGLang با یک فلگ فعال میشود.
آیا میتوانم Run:ai را روی GPUهای غیرانویدیا اجرا کنم؟
هنوز روشن نیست. بنیانگذاران گفته بودند متنباز شدن دامنه را فراتر از GPUهای انویدیا میبرد، ولی اعلامیهٔ فعلی جزئیاتی در این باره نداده. فعلاً آن را یک پلتفرم GPU-محورِ انویدیا بدان.
از ایران میشود از نسخهٔ متنباز استفاده کرد؟
کد روی گیتهاب بهصورت عمومی منتشر شده و جنس نرمافزار متنباز معمولاً کمترین محدودیت دسترسی را دارد؛ ولی شرایط سرویس گیتهاب، NGC انویدیا و شریکهای ابری ممکن است محدودیت خودشان را داشته باشند. قبل از هر تصمیمی، شرایط روز هر سرویس را خودت بررسی کن.
این خبر چه ربطی به مایا ۳۰۰ و لیتلبیت-۲ دارد؟
هر سه به یک روند واحد مربوطاند: بهرهوری بیشتر از منابع هوش مصنوعی. مایا ۳۰۰ (تراشهٔ مایکروسافت) بهرهوری سیلیکون را بالا میبرد، لیتلبیت-۲ (سامسونگ) مدلها را سبکتر میکند و Run:ai مطمئن میشود GPUهای موجود بیکار نمانند. جزئیات دو تای اول را در مطلب مایا ۳۰۰ و مطلب لیتلبیت-۲ پوشش دادهایم.
منابع
Unite.AI: آمادگی Lambda برای زمانبند متنباز Run:ai در سرویس کوبرنتیز (۱۳ اکتبر ۲۰۲۶)
وبلاگ OpenNebula: یکپارچهسازی Run:ai متنباز انویدیا (۱۳ اکتبر ۲۰۲۶)
Blockchain.News: انتشار پلتفرم ارکستراسیون GPU انویدیا بهصورت متنباز (۱۳ اکتبر ۲۰۲۶)
CTech: پیشینهٔ خرید Run:ai توسط انویدیا و وعدهٔ بنیانگذاران (۱۳ اکتبر ۲۰۲۶)