فهرست مطالب
اگر متن یک PDF دوستونه را کپی کرده باشید و جملهها در هم ریخته باشند، مشکل آمادهسازی سند برای هوش مصنوعی را میشناسید. Docling ابزاری متنباز است که متن، جدول و ساختار سند را استخراج میکند و خروجی قابلپردازش میدهد. کاربرد اصلی آن، ساختن ورودی مناسب برای جستوجو و تحلیل اسناد است؛ کیفیت همین ورودی میتواند روی نتیجه مراحل بعد اثر بگذارد.
این ابزار برای توسعهدهندهای جذاب است که میخواهد اسناد را به یک دستیار یا گردشکار متصل کند. برای آشنایی با بخش اتصال ابزارها، راهنمای MCP و ارتباط هوش مصنوعی با فایلها و سرویسها مفید است. Docling بخشی از مسیر آمادهسازی داده را پوشش میدهد؛ مجوز دسترسی دستیار و محل ارسال خروجی همچنان باید جداگانه کنترل شوند.
Docling چیست و مسئله را کجا حل میکند؟
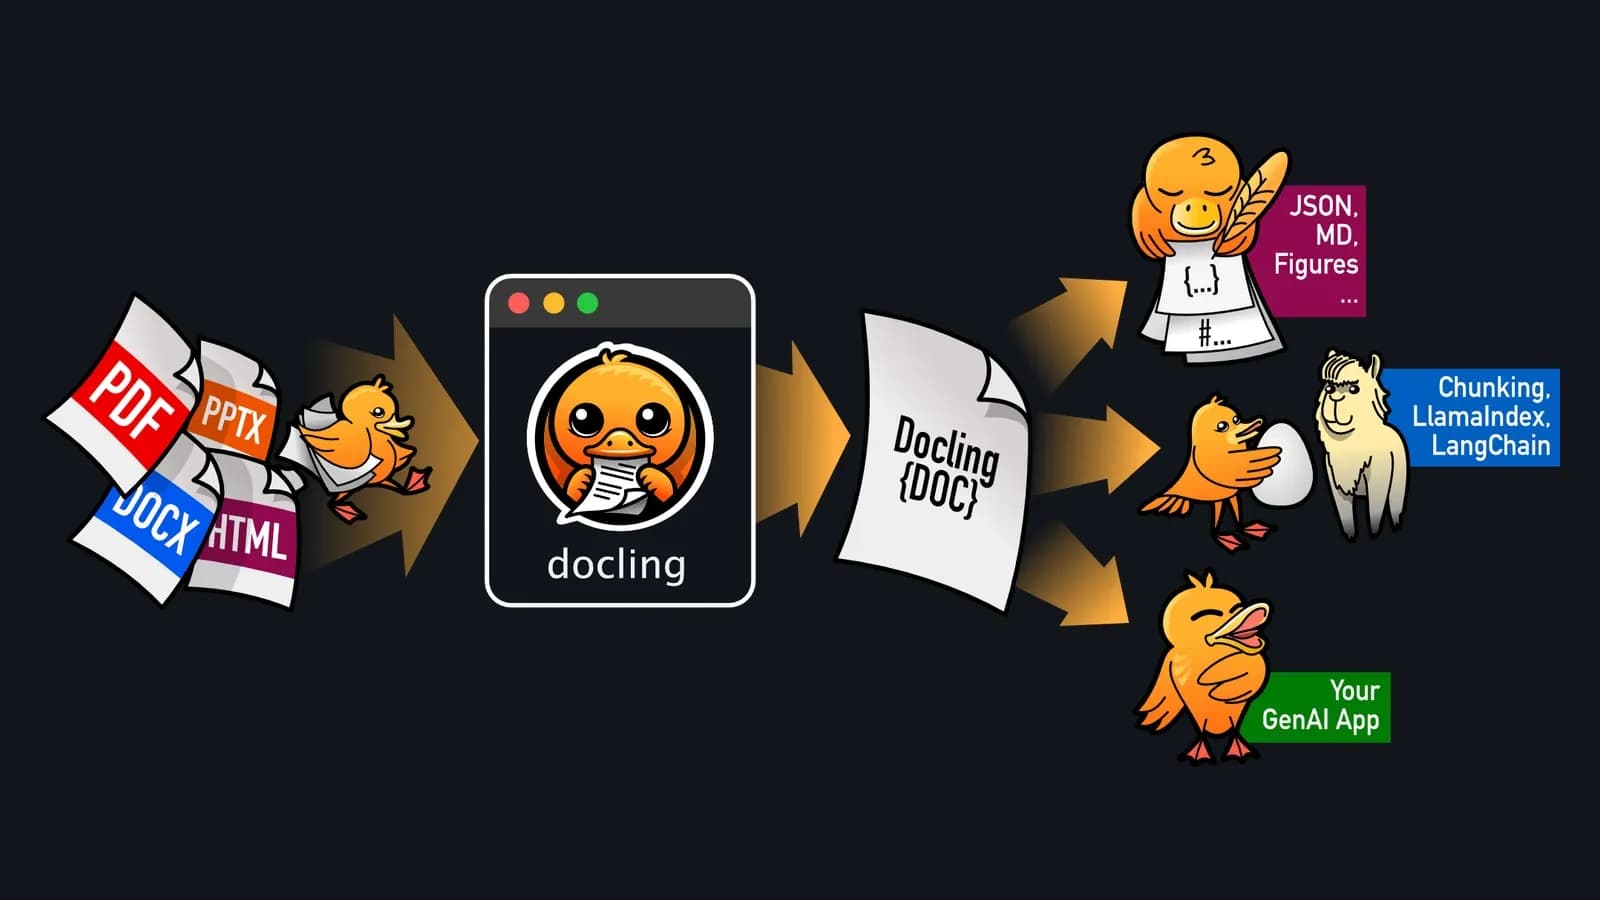
طبق مخزن رسمی Docling، این پروژه برای پردازش قالبهای مختلف و استفاده از آنها در اکوسیستم هوش مصنوعی مولد توسعه یافته است. در PDF، قابلیتهایی مانند تشخیص چیدمان صفحه، ترتیب خواندن، ساختار جدول و OCR دارد. OCR همان تبدیل نوشته داخل تصویر یا اسکن به متن قابلپردازش است.
تفاوت عملی با کپیکردن متن، حفظ رابطه میان اجزای سند است. برای نمونه، در یک گزارش فروش، عدد زیر ستون «ماه» باید به همان عنوان مربوط بماند. اگر هنگام استخراج، سطرها و ستونها جابهجا شوند، حتی یک مدل زبانی قوی هم ممکن است بر پایه داده اشتباه پاسخ بدهد.
Docling ابتدا سند را در قالب مشترک DoclingDocument نمایش میدهد. این واسطه کمک میکند خروجیهای متفاوت از یک ساختار استخراج شوند و برنامه بعدی مجبور نباشد برای هر نوع فایل، مسیر مستقلی از ابتدا طراحی کند.
چه فایلهایی میخواند و چه خروجیای میدهد؟
در فهرست رسمی قالبها، PDF، فایلهای DOCX، XLSX و PPTX در کنار قالبهای دیگر پشتیبانی میشوند. برای فایلهای قدیمی DOC، XLS و PPT و همچنین RTF، وابستگی LibreOffice مطرح است؛ بنابراین پشتیبانی از یک پسوند همیشه به معنای بینیازی از نصب ابزار جانبی نیست.
خروجیهای متداول شامل Markdown، متن ساده، HTML و JSON هستند. انتخاب خروجی به کار بعدی بستگی دارد:
نیاز | خروجی مناسب برای بررسی |
|---|---|
خواندن متن و تیترها یا ارسال به مرحله تحلیل | Markdown |
نگهداری ساختار کامل DoclingDocument | JSON |
نمایش در یک صفحه وب | HTML |
پردازش متنی با کمترین نشانهگذاری | متن ساده |
این انتخابها پیشنهاد کاربردیاند. پیش از تعیین خروجی نهایی، باید ببینید سامانه مقصد کدام بخش از اطلاعات سند را مصرف میکند.
اجرای محلی، حریم خصوصی و هزینه واقعی
مستندات تنظیمات پیشرفته توضیح میدهد که مدلها بهطور پیشفرض هنگام اولین استفاده دانلود میشوند و میتوان آنها را از قبل برای محیط آفلاین آماده کرد. پس اجرای محلی پس از آمادهسازی وابستگیها و مدلهای لازم امکانپذیر است. در همان مستندات، استفاده از سرویسهای مدل بیرونی به فعالسازی صریح ارتباط با خدمات راه دور وابسته شده است.
این تمایز برای سند محرمانه مهم است: محلیبودن تبدیل بهتنهایی کافی نیست. اگر خروجی بعداً به یک مدل ابری ارسال شود، داده از همان مرحله خارج میشود. محل ذخیره فایل، دسترسی کاربران و مقصد مراحل بعدی را باید در طراحی کل مسیر در نظر گرفت.
کد Docling با مجوز MIT عرضه میشود و نسخه متنباز آن هزینه اشتراک اجباری برای خود کد ندارد. هزینه پردازنده، حافظه، فضای ذخیرهسازی و نگهداری سرویس همچنان باقی است. مخزن رسمی هم تأکید میکند که مجوز مدلهای جداگانه باید از منبع خودشان بررسی شود؛ مجوز کد را به تمام وزنهای مدل تعمیم ندهید.
برای استفاده از آن چقدر دانش فنی لازم است؟
Docling از مسیر کتابخانه Python، خط فرمان و سرویس قابل استفاده است. راهنمای نصب از Windows، Linux و macOS و معماریهای x86_64 و arm64 نام میبرد. وابستگیهایی مانند PyTorch و موتور OCR میتوانند بر نصب و انتخاب شتابدهنده اثر بگذارند.
برای کسی که فقط میخواهد یک فایل را بخواند، انتخاب و پیکربندی این اجزا ممکن است کار اضافه باشد. ارزش ابزار زمانی بیشتر میشود که تبدیل اسناد تکرار میشود یا لازم است خروجی به نرمافزار دیگری برسد. در چنین پروژهای، آموزش n8n و ساخت گردشکار خودکار برای طراحی مراحل دریافت فایل، کنترل نتیجه و ارسال خروجی زمینه مفیدی میدهد؛ اتصال مشخص به Docling نیازمند پیادهسازی متناسب با همان محیط است.
محدودیتها، بهویژه در اسناد فارسی
در پرسشهای متداول پروژه، پشتیبانی زبانی OCR وابسته به موتور انتخابی معرفی شده است. بنابراین از چندزبانهبودن ابزار نمیتوان نتیجه گرفت که هر اسکن فارسی با تنظیمات پیشفرض، درست خوانده میشود. انتخاب زبان و مدل OCR باید با سند واقعی تطبیق داده شود.
برای ارزیابی یک مجموعه فارسی، نمونهای شامل اعداد فارسی و لاتین، متن راستبهچپ، جدول و صفحه کمکیفیت انتخاب کنید. متن استخراجشده را کنار اصل سند بگذارید و ترتیب خواندن، جداشدن کلمات و ارتباط عدد با ستون را بررسی کنید. این آزمون کوچک، معیار مناسبتری از اتکا به فهرست قابلیتهاست.
Docling همچنین درجههای اطمینان تبدیل دارد تا خروجیهای نیازمند بازبینی مشخص شوند. مستندات میگوید چیدمان پیچیده و اسکن ضعیف میتوانند نتیجه نامطلوب بسازند و امتیاز کیفیت جدول هنوز پیادهسازی نشده است. این درجهها کمک به تصمیمگیریاند و جای تطبیق جدولهای حساس با سند اصلی را نمیگیرند.
تفاوت با MarkItDown و سامانه پرسشوپاسخ
MarkItDown مایکروسافت هم فایلها را برای تحلیل متنی و مدلهای زبانی به Markdown تبدیل میکند. خود پروژه آن را ابزاری سبک با تمرکز بر ساختارهایی مانند تیتر، فهرست و جدول توصیف میکند. Docling در مقابل، یک نمایش ساختاریافته مشترک و مسیرهای پردازش و خروجی متنوع ارائه میدهد. انتخاب را با نوع سند و خروجی موردنیاز انجام دهید؛ این تفاوت بهتنهایی برتری دقت یا سرعت یکی را ثابت نمیکند.
برای ساخت جستوجو روی اسناد، مرحله دیگری هم لازم است. مستندات قطعهبندی Docling توضیح میدهد که سند میتواند به بخشهای کوچکتر همراه با فراداده تقسیم شود. این مرحله برای آمادهسازی ورودی بازیابی مفید است؛ ساخت نمایه جستوجو، انتخاب بخش مرتبط و تولید پاسخ، اجزای دیگری از سامانهاند.
جمعبندی: این ابزار برای چه کسانی مناسب است؟
Docling انتخاب قابلبررسی برای توسعهدهندگان اتوماسیون اسناد، جستوجوی سازمانی و دستیارهای متصل به فایل است؛ بهخصوص وقتی کنترل محل پردازش و ساختار خروجی اهمیت دارد. برای خواندن موردی یک سند، ابزارهای آماده ممکن است مسیر کوتاهتری باشند.
پیش از استقرار، یک مجموعه کوچک از فایلهای واقعی را با معیار مشخص ارزیابی کنید: چند جدول نیاز به اصلاح دارند، ترتیب خواندن کجا به هم میریزد و بازبینی هر فایل چقدر زمان میبرد؟ اگر خروجی این آزمون قابلقبول بود، پردازش گروهی را با مرحله کنترل کیفیت گسترش دهید. هدف، داده قابلاعتماد برای مرحله بعد است.
منابع و مستندات
تصویر: مشارکتکنندگان Docling؛ منبع تصویر رسمی، با مجوز MIT.