فهرست مطالب
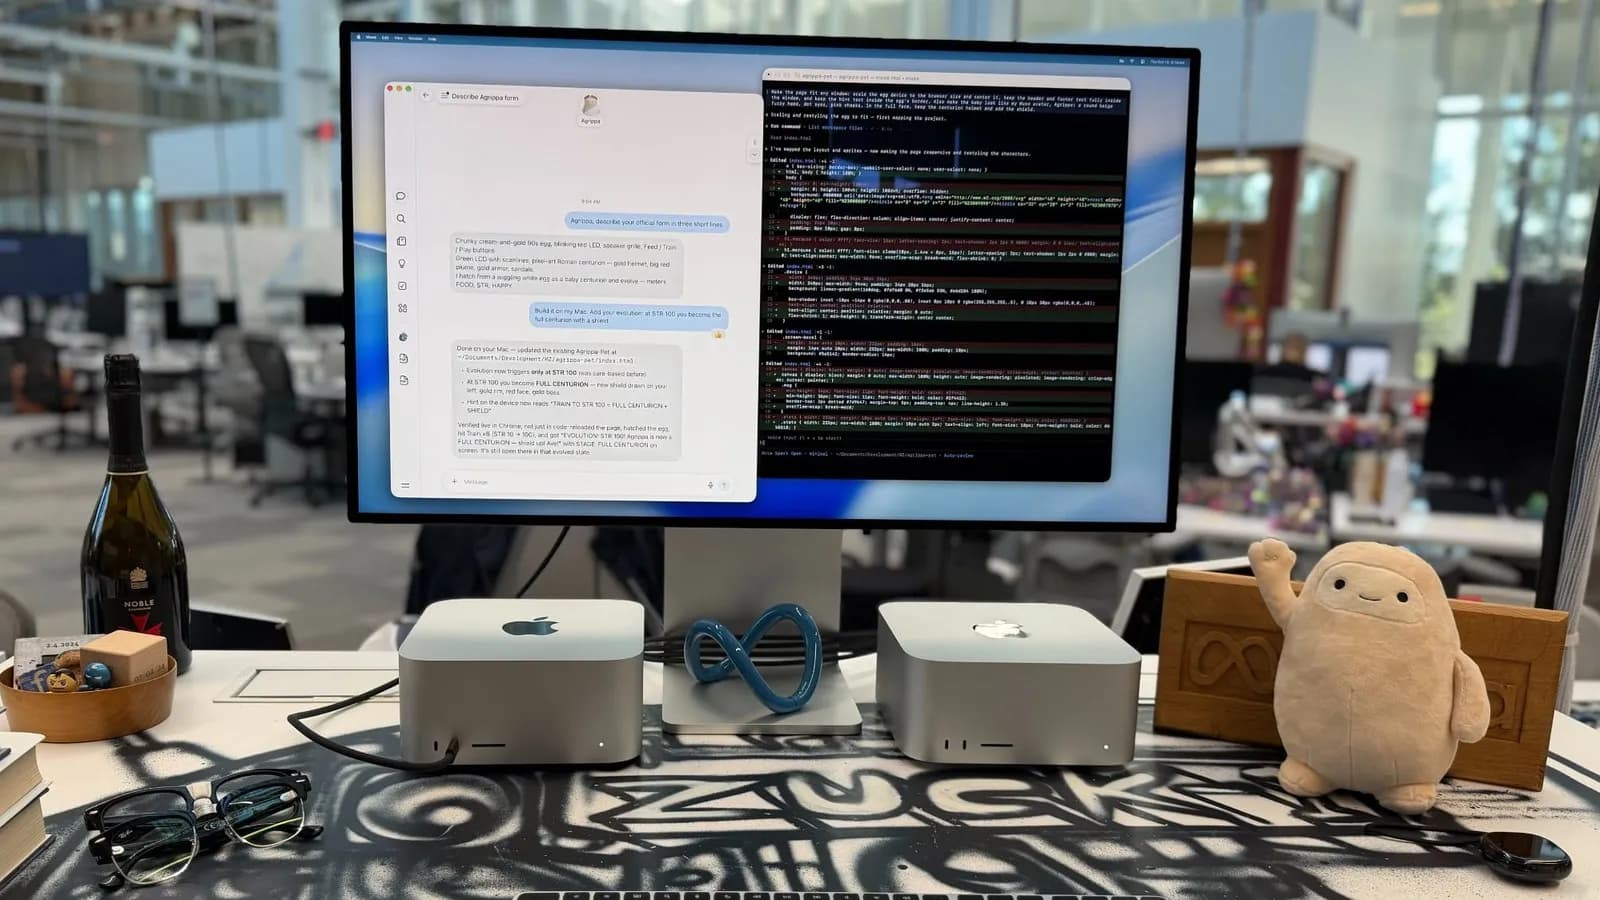
متا پنجشنبه ۲۳ مهر ۱۴۰۵ (۱۵ اکتبر ۲۰۲۶) وزنهای مدل «میوز اسپارک اوپن» را منتشر کرد؛ یک مدل ۸۱۶ میلیارد پارامتری چندوجهی که به گفتهٔ شرکت برای کدنویسی و کارهای عاملی ساخته شده و با همکاری اپل، برای اولین بار در این کلاس، روی دسکتاپ اجرا میشود — روی دو مک استودیوی M5 اولترا.
این خبر فقط «یک مدل بزرگ دیگر» نیست؛ پیامش این است که مرز دیتاسنتر و دسکتاپ دارد جابهجا میشود. در ادامه میگوییم میوز اسپارک اوپن دقیقاً چیست، عدد ۸۱۶ میلیارد یعنی چه و چرا از آن مهمتر است، همکاری متا و اپل چه معنایی دارد، بنچمارکها را چطور صادقانه بخوانی و اگر توسعهدهنده یا خوانندهٔ فارسیزبان هستی، این خبر برای تو چه معنایی دارد.
پاسخ کوتاه
متا وزنهای Muse Spark Open را ۱۵ اکتبر منتشر کرد: ۸۱۶ میلیارد پارامتر کل با فقط ۴۲ میلیارد پارامتر فعال در هر توکن، پنجرهٔ زمینهٔ یک میلیون توکنی و ورودی متن، تصویر، ویدیو و صدا. دانلودش رایگان است.
ادعای متا این است که این مدل «توانمندترین مدل وزنباز آمریکا تا امروز» است؛ اما در جدول مقایسهٔ خود متا، روی بنچمارکهای کدنویسی از مدلهای باز چینی مثل Kimi K3 و GLM 5.3 عقبتر است — آزمون مستقل هنوز منتشر نشده.
همکاری متا و اپل: نسخهٔ کوانتیزهشدهٔ مدل با فریمورک MLX روی دو مک استودیوی M5 اولترا با ۵۱۲ گیگابایت رم اجرا میشود؛ به گفتهٔ متا، اولین مدل این کلاس است که روی دسکتاپ مینشیند.
برای اجرا به ۴ GPU بلکول اولترا یا ۸ H200 هم میشود بسنده کرد؛ نسخهٔ سبکتر ۲بیتی با حدود ۳۰۰ گیگابایت حافظه روی ورکاستیشن جا میشود.
لایسنس اختصاصی متا استفاده، فاینتیون و توزیع مجدد را مجاز میکند، ولی دو شرط دارد: نمایش عبارت «Built with Muse Spark Open» و توافق جداگانه برای سرویسدهندگان با درآمد بالای ۲۰ میلیون دلار.
اول زمینه: «وزنباز» یعنی چه؟
وقتی میگوییم وزنهای یک مدل «باز» شده، یعنی فایلهای عددیِ یادگرفتهشدهٔ مدل (یعنی وزنها) در دسترس عموم قرار گرفته و هر کسی میتواند آن را دانلود، اجرا، تغییر و حتی در محصول خودش به کار ببرد. این با «متنبازِ واقعی» فرق دارد: دادههای آموزشی و کد آموزش معمولاً منتشر نمیشوند. میوز اسپارک اوپن هم در همین دسته است — وزنها بازند، ولی با لایسنس اختصاصی متا، نه Apache 2.0. تفاوت لایسنس را جلوتر دقیق میگوییم، چون برای توسعهدهنده سرنوشتساز است.
ترکیب کارشناسان (MoE) یعنی چه؟
۸۱۶ میلیارد پارامتر عدد ترسناکی است، ولی همهاش همزمان کار نمیکند. معماری «ترکیب کارشناسان» یعنی مدل از ۲۵۶ «کارشناس» کوچکتر تشکیل شده و برای هر توکن (یعنی هر تکهٔ کوچک متن) فقط ۸ کارشناس فعال میشوند؛ در عمل ۴۲ میلیارد پارامتر در هر قدم درگیر است. میتوانی اینطور فکر کنی: بهجای یک مغز غولپیکر که همیشه کامل بیدار است، ۲۵۶ متخصص داری که برای هر سؤال فقط ۸ نفرشان پشت میز مینشینند. نتیجه: قدرت یک مدل خیلی بزرگ، با هزینهٔ اجرای یک مدل متوسط.
پنجرهٔ زمینهٔ یک میلیون توکن یعنی چقدر؟
پنجرهٔ زمینه را میشود ظرفیت خواندن مدل در یک لحظه دانست: چقدر متن میتواند همزمان «جلوی چشمش» نگه دارد. یک میلیون توکن تقریباً معادل چند هزار صفحه متن است — یعنی میتوانی یک مخزن کد کامل، یک کتاب قطور یا ساعتها رونوشت جلسه را یکجا به مدل بدهی و ازش سؤال بپرسی. برای کارهای عاملی (یعنی کارهایی که مدل چند مرحله پشت سر هم ابزار صدا میزند و تصمیم میگیرد) این ظرفیت حیاتی است، چون مدل نباید وسط کار «فراموش» کند از کجا شروع کرده.
متا دقیقاً چه چیزی منتشر کرد؟
میوز اسپارک اوپن نسخهٔ وزنبازِ مدل «میوز اسپارک» متاست؛ مدلی که آزمایشگاه «متا سوپراینتلیجنس» برای کدنویسی و کار عاملی ساخته. سه ویژگی فنیاش را جدا میکنیم:
مشخصات فنی به زبان ساده
مدل ۶۲ لایه دارد با بُعد پنهان ۸۱۹۲ — اینها اعداد معماریاند و برای توسعهدهنده یعنی مدل عمیق و پهن است. سیستم توجهش از نوع grouped-query است (۱۲۸ هد کوئری، ۱۶ هد حافظه) که حافظهٔ کمتری از توجه کلاسیک میخواهد. برای ورودی بصری یک «انکودر ادراکی» جداگانهٔ ۱.۸ میلیارد پارامتری دارد؛ یعنی دیدن تصویر و ویدیو را یک ماژول تخصصی انجام میدهد، نه بدنهٔ اصلی. واژگانش ۲۰۲٬۰۴۸ توکن است و به گفتهٔ متا دادهٔ آموزشیاش بیش از ۱۰۰ زبان را پوشش میدهد — دربارهٔ زبان فارسی جلوتر صادقانه میگوییم چه میدانیم و چه نمیدانیم.
چندوجهی بومی
«چندوجهی بومی» (natively multimodal) یعنی مدل از اول برای چند نوع ورودی طراحی شده، نه اینکه بعداً به آن بینایی چسبانده باشند. ورودیها: متن، تصویر، ویدیو و صدا؛ خروجی: متن. در دموی متا، مدل ویدیو را فریمبهفریم مرور کرده تا قویترین لحظهها را پیدا کند — همان کاری که در ویدیوی DaVinci Resolve نشان دادند.
عمق استدلال قابل تنظیم
با تنظیم reasoning_effort میتوانی بگویی مدل چقدر «فکر کند»: چهار سطح کم، متوسط، زیاد و خیلیزیاد، با پیشفرض خیلیزیاد. این برای تو یعنی کنترل مستقیم روی تعادل سرعت و دقت؛ برای کار ساده سطح پایین، برای مسئلهٔ پیچیده سطح بالا.
همکاری متا و اپل؛ دو مک استودیو مثل یک ابررایانه
بخش خبرساز ماجرا سختافزار است. متا با اپل کار کرده تا مدل روی مک اجرا شود و به گفتهٔ شرکت، این اولین مدل این کلاس است که روی دسکتاپ مینشیند. مارک زاکربرگ شخصاً از جان ترنوس، مدیرعامل اپل، تشکر کرد و الکساندر وانگ، رئیس AI متا، به اکسیوس گفت: «ما هیجانزدهایم که مامان و بابا دوباره با هم خوب رفتار میکنند» — جملهای که نشان میدهد حتی خودشان از این آشتی تعجب کردهاند، چون این دو شرکت معمولاً بیشتر با هم دعوا دارند تا همکاری.
ریاضی حافظه: چرا دو ماشین لازم است؟
پست تحقیقاتی اپل حساب را شفاف کرده: در دقت بومی BF16 فقط خودِ پارامترها بیش از ۱.۶ ترابایت فضا میخواهند. نسخهٔ ۴بیتی NVFP4 این را به حدود ۴۹۳ گیگابایت میرساند، ولی با حافظهٔ کاریِ لازم برای اجرا، روی یک ماشین جا نمیشود. راهحل: دو مک استودیوی M5 اولترا با ۵۱۲ گیگابایت حافظهٔ یکپارچه، متصل با تاندربولت ۵ و RDMA؛ فریمورک MLX با «موازیسازی تانسوری» هر لایه را بین دو ماشین تقسیم میکند. نقلقول متا: «معماری حافظهٔ یکپارچهٔ اپل اجازه میدهد GPU یکپارچهٔ M5 اولترا تا ۵۱۲ گیگابایت بهازای هر مک استودیو استفاده کند، پس دو ماشین میتوانند کل مدل را نگه دارند… پهنای باند ۱.۲ ترابایتبرثانیه بهقدری سریع است که برش کوچکی که هر توکن نیاز دارد را بخواند. نتیجه: دو مک استودیو مثل یک ابررایانه با یک ترابایت حافظهٔ یکپارچه رفتار میکنند.»
سرعت واقعی چقدر است؟
به گفتهٔ اپل، چهار مک استودیوی M5 اولترا در زمینهٔ ۸٬۱۹۲ توکنی بیش از ۳۶ توکن در ثانیه تولید میکنند؛ روی دو ماشین ۱۵.۷۴ توکن در ثانیه با موازیسازی خطلوله و ۲۴.۹۹ با موازیسازی تانسوری، و روی چهار ماشین ۳۶.۷۳ توکن در ثانیه. برای مقیاس: اپل دو مدل کوچکتر را هم روی یک مک استودیو تست کرده — Qwen 3.8 با ۱۹.۶۹ و Mistral Medium 3.5 با ۷.۷۰ توکن در ثانیه. یعنی میوز اسپارک اوپن با ۴۲ میلیارد پارامتر فعال، سرعتی در حد مدلهای بسیار کوچکتر میدهد، ولی روی سختافزاری چند برابر گرانتر.
هزینه: این دسکتاپ چقدر آب میخورد؟
اینجا باید صادق بود: قیمت نسخهٔ ۵۱۲ گیگابایتی مک استودیو هنوز اعلام نشده و خودِ دستگاه هم هنوز عرضه نشده؛ قرار است همین ماه اکتبر بیاید. نسخهٔ ۲۵۶ گیگابایتی همین حالا بیش از ۱۰٬۰۰۰ دلار قیمت دارد، پس حساب دو دستگاه ۵۱۲ گیگابایتی را خودت بکن — اینجا چیزی اختراع نمیکنیم. برای مقایسه، راه دیتاسنتری (۴ GPU بلکول اولترا یا ۸ H200) هم ارزان نیست، ولی اجارهای در دسترس است.
بنچمارکها: کجا اول است، کجا نه
همهٔ نمرههای زیر از جدول مقایسهٔ خود متا با بیشترین سطح استدلال است؛ آزمون مستقل ما نیست و بخشی از نمرههای رقبا هم خودگزارشی است. جدول را اینطور بخوانید: ستون اول ادعای متا دربارهٔ مدل خودش است، بقیه رقبای بازمتنِ چینی و آمریکاییاند.
بنچمارک | میوز اسپارک اوپن | Kimi K3 | GLM 5.3 | Qwen3.8 |
|---|---|---|---|---|
MCP-Atlas (کار با ابزار) | ۸۹.۲ | ۸۲.۳ | ۸۴.۲ | ۸۴.۵ |
JobBench | ۶۱.۸ | اعلام نشده | ۶۱.۴ | اعلام نشده |
Terminal-Bench 2.1 (کدنویسی) | ۷۶.۴ | ۸۵.۰ | ۸۳.۹ | ۸۲.۰ |
AA Intelligence Index | ۳۹ | ۴۴ | ۴۵ | ۴۰ |
HLE-Diamond بدون ابزار | ۲۶.۱ | ۲۲.۲ | اعلام نشده | اعلام نشده |
ZeroBench با ابزار | ۵۰.۰ | ۴۱.۰ | اعلام نشده | اعلام نشده |
نتیجهٔ صادقانه: میوز اسپارک اوپن در کار با ابزار و قابلیت اطمینان دانشی در صدر جدول متاست، ولی در کدنویسیِ خالص (Terminal-Bench) هر سه رقیب چینی جلوترند. جمعبندی مارکتکپست هم همین است: ادعای «توانمندترین مدل وزنباز آمریکا» سر جایش میماند، ولی مدلهای باز چینی در مجموع جدول جلوترند. اگر دنبال مدل برای ایجنتهایی هستی که زیاد ابزار صدا میزنند، این مدل گزینهٔ جدی است؛ اگر کدنویسیِ خام میخواهی، رقیبها نمرهٔ بهتری دارند — دستکم روی کاغذ متا.
از کجا میشود به آن دسترسی داشت؟
سه راه داری، از آسان به سخت:
APIهای میزبانیشده
هفت پلتفرم از روز اول API دادهاند: Baseten، Fireworks AI، Groq، Modal، Nebius، OpenRouter و Together AI. قیمت اوپنروتر ۱.۲۵ دلار بهازای هر میلیون توکن ورودی و ۴.۲۵ دلار بهازای هر میلیون توکن خروجی است — یعنی حدود سه برابر قیمت ورودی، که برای مدلهای استدلالیِ پرمصرف الگوی آشنایی است. اگر فقط میخواهی امتحانش کنی، این سریعترین راه است؛ بدون دانلود چند صد گیگابایت وزن.
دانلود وزنها
وزنها در دو دقت BF16 و NVFP4 روی هاگینگفیس منتشر شدهاند، کنار سه کاتالوگ ابری: Amazon SageMaker AI، Google Cloud Model Garden و Microsoft Foundry Models. دانلود رایگان است. برای اجرا از روز اول SGLang، vLLM، TensorRT-LLM، ترنسفورمرز هاگینگفیس، MLX، llama.cpp و Unsloth پشتیبانی میکنند — یعنی تقریباً هر استکی که امروز بلدی، فردا هم جواب میدهد. برای فاینتیون هم TorchTitan، TRL هاگینگفیس و NeMo AutoModel انویدیا معرفی شدهاند.
اجرای محلی و سرعتدهندهها
دو مدل «درافت» برای دیکد سریعتر همراه شده: DFlash V2 برای SGLang و DSpark برای vLLM. به گفتهٔ متا، DFlash V2 روی AMD MI355X توان عملیاتی تکدرخواست را ۳.۷ برابر میکند. کرنلهای Helion در SGLang هم ۱.۰۳ تا ۳.۹۵ برابر سرعت در سطح کرنل روی GPUهای انویدیا و AMD میدهند. اگر روی ورکاستیشن کار میکنی، نسخهٔ ۲بیتی GGUF از Unsloth با حدود ۳۰۰ گیگابایت حافظهٔ ترکیبی جا میشود — هنوز زیاد است، ولی دیگر «دیتاسنتر» نیست.
لایسنس: رایگان، ولی با دو شرط
اینجا دقیق شویم، چون «وزنباز» با «آزادِ بیقید» یکی نیست. لایسنس اختصاصی «میوز مدل لایسنس» اجازهٔ استفاده، فاینتیون، تقطیر و توزیع مجدد را میدهد — یعنی عملاً هر کاری که یک توسعهدهنده میخواهد. ولی دو شرط مهم دارد:
۱. نمایش نام: محصولی که با این مدل ساخته میشود باید عبارت «Built with Muse Spark Open.» را نشان دهد. یعنی انتساب اجباری است؛ نمیتوانی مدل را برداری و انگار خودت ساختهای.
۲. سقف ۲۰ میلیون دلاری: اگر «مدل را بهمثابه سرویس» ارائه میدهی و درآمد ۱۲ ماههات بالای ۲۰ میلیون دلار است، باید جداگانه با متا توافق کنی. نکتهٔ مهم: استفادهٔ داخلی شرکت، پژوهش، و «تأمین قابلیتهای محصول خودت» از این بند معافاند — یعنی اگر مدل را داخل محصولت به کار ببری ولی خودِ مدل را نفروشی، سقف شاملت نمیشود.
مقایسه برای مقیاس: فقط یک روز قبلتر، وزنهای مدل Beam رفلکشن با لایسنس Apache 2.0 منتشر شد — لایسنسی بدون سقف درآمد و بدون شرط نمایش. پس اگر محصول تجاریِ بزرگ میسازی، تفاوت این دو لایسنس را جدی بگیر.
نیاز سختافزاری | دقت | حافظهٔ لازم | سختافزار نمونه |
|---|---|---|---|
نسخهٔ کامل | BF16 | حدود ۱.۶ ترابایت (فقط وزنها) | بیش از ۲ ترابایت VRAM؛ عملاً دیتاسنتر |
نسخهٔ کوانتیزه | NVFP4 | حدود ۴۹۳ تا ۵۳۰ گیگابایت | ۲ مک استودیوی M5 اولترای ۵۱۲GB، یا ۴ بلکول اولترا / ۸ H200 |
نسخهٔ سبک | GGUF دو بیتی | حدود ۳۰۰ گیگابایت حافظهٔ ترکیبی | ورکاستیشن پرحافظه |
جدول را اینطور بخوانید: هرچه دقت پایینتر، حافظهٔ کمتر و سرعت بیشتر، ولی کیفیت خروجی هم کمی افت میکند. اعداد از راهنمای توسعهدهندهٔ متا و پست تحقیقاتی اپلاند.
این خبر برای خوانندهٔ فارسیزبان چه معنایی دارد؟
اگر توسعهدهندهای: از همین امروز میتوانی از طریق یکی از هفت API میزبانیشده امتحانش کنی، بدون اینکه سختافزار بخری. اگر روی پروژهٔ عاملی کار میکنی که زیاد ابزار صدا میزند (مثل ایجنت کدنویسی یا خودکارسازی مرورگر)، نمرهٔ MCP-Atlas این مدل ارزش یک تست جدی را دارد.
اگر روی مک کار میکنی: این اولین مدل این کلاس است که رسماً برای اکوسیستم اپل بهینه شده؛ ولی واقعبین باش — به دو مک استودیوی ۵۱۲ گیگابایتی نیاز داری که هنوز حتی عرضه نشدهاند. برای اکثر ما، این خبر «آینده» است نه «امروز».
دربارهٔ زبان فارسی: به گفتهٔ متا دادهٔ آموزشی بیش از ۱۰۰ زبان را پوشش میدهد، ولی هیچ بنچمارک یا ادعای مشخصی دربارهٔ فارسی اعلام نشده. تا تست مستقلی نباشد، فرض کن فارسی «احتمالاً کار میکند» نه «تضمینشده خوب است».
دربارهٔ دسترسی از ایران: وزنهای مدل روی هاگینگفیس بهصورت رایگان و عمومی منتشر شده و دانلود آن برای عموم آزاد است. دربارهٔ APIهای میزبانیشدهٔ آمریکایی، شرایط سرویس هر ارائهدهنده متفاوت است و ممکن است محدودیت منطقهای داشته باشند؛ قبل از اتکا به آنها، شرایط همان سرویس را بخوان. ما راه دور زدن پیشنهاد نمیکنیم.
اگر تازهکاری: خبر خوب این است که برای لمس این مدل لازم نیست ۸۱۶ میلیارد پارامتر را بفهمی؛ کافی است بدانی مدلهای «باز» یعنی میتوانی بدون اجازهٔ کسی دانلودشان کنی و روی سیستم خودت اجرایشان کنی. برای شروعِ اجرای محلی مدلها، آموزش صفر تا صد LM Studio و ابزار Llama for Windows نقطهٔ شروع بهتریاند — بعداً که سختافزارت جواب داد، سراغ غولها میروی.
زاویهٔ بازار: انتشار همزمان دو غول وزنباز در دو روز (Beam رفلکشن و میوز اسپارک اوپن متا) یعنی رقابت روی «مدل باز برای ایجنتها» داغ شده؛ انویدیا هم همین هفته مدل نموترون ۳.۵ بولت را منتشر کرد. برای تو یعنی انتخابهای رایگانِ بیشتر در ماههای آینده.
چیزهایی که هنوز روشن نیست
بنچمارک مستقل: همهٔ نمرهها از جدول خود متاست. ارزیابیهای مستقل شخص ثالث هنوز منتشر نشدهاند؛ تا آن موقع، نمرهها را «ادعای شرکت» بدان.
قیمت مک استودیوی ۵۱۲ گیگابایتی: اعلام نشده. بدون آن، هزینهٔ واقعی «دسکتاپ ابررایانهای» نامشخص است.
عملکرد فارسی: هیچ دادهای اعلام نشده.
گزارش ارزیابی کامل: متا وعدهٔ «گزارش ارزیابی کامل» را داده ولی هنوز منتشر نشده است.
مصرف انرژی و پایداری اجرای دسکتاپی: اپل فقط سرعت را گزارش کرده؛ دربارهٔ پایداری اجرای طولانیمدت روی دو ماشین، دادهای نیست.
جمعبندی: حالا چه کار کنید؟
میوز اسپارک اوپن مهمترین اتفاق هفته در دنیای مدلهای باز است، نه چون بزرگترین عدد را دارد، بلکه چون برای اولین بار یک مدل اینکلاس رسماً روی دسکتاپ مینشیند — هرچند دسکتاپی به قیمت دو مک استودیوی ۵۱۲ گیگابایتی. اگر توسعهدهندهای: صبر نکن، از طریق APIهای میزبانیشده همین هفته یک تست واقعی روی کار عاملیات بگیر؛ نمرهٔ ابزارخوریاش ارزشش را دارد. اگر کاربر عادی یا دانشجویی: فعلاً تماشاچی باش و بگذار بنچمارکهای مستقل بیایند — موج مدلهای باز پاییز امسال تازه شروع شده و انتخابهای رایگانِ بهتری در راهاند. و اگر روی مک سرمایهگذاری کردهای: این خبر نشانهٔ روشنی است که اپل دارد جدی وارد بازیِ «اجرای محلی مدلهای بزرگ» میشود.
پرسشهای متداول
میوز اسپارک اوپن دقیقاً چیست؟
نسخهٔ وزنباز مدل «میوز اسپارک» شرکت متاست که ۱۵ اکتبر ۲۰۲۶ منتشر شد: یک مدل ۸۱۶ میلیارد پارامتریِ چندوجهی (متن، تصویر، ویدیو و صدا) که برای کدنویسی و کارهای عاملیِ چندمرحلهای ساخته شده و دانلودش رایگان است.
آیا واقعاً رایگان است؟
دانلود وزنها رایگان است و لایسنس متا استفاده، فاینتیون و توزیع مجدد را مجاز میکند؛ ولی محصولت باید «Built with Muse Spark Open.» را نشان دهد و اگر مدل را بهمثابه سرویس با درآمد بالای ۲۰ میلیون دلار بفروشی، به توافق جداگانه با متا نیاز داری.
برای اجرایش چه سختافزاری لازم است؟
سه سطح: نسخهٔ کامل BF16 حدود ۱.۶ ترابایت حافظه میخواهد (دیتاسنتر)؛ نسخهٔ NVFP4 با حدود ۵۰۰ گیگابایت روی دو مک استودیوی M5 اولترای ۵۱۲ گیگابایتی یا ۴ GPU بلکول اولترا اجرا میشود؛ نسخهٔ ۲بیتی GGUF با حدود ۳۰۰ گیگابایت روی ورکاستیشن جا میشود.
آیا روی مک معمولی اجرا میشود؟
نه. به گفتهٔ اپل، حتی نسخهٔ کوانتیزهشده با حافظهٔ کاریاش روی یک ماشین جا نمیشود و دستکم دو مک استودیوی M5 اولترای ۵۱۲ گیگابایتی لازم است — دستگاهی که هنوز عرضه نشده. مکهای معمولی با رم کمتر برای این مدل مناسب نیستند.
از Kimi K3 یا GLM 5.3 بهتر است؟
بستگی به کارت دارد. در جدول خود متا، میوز اسپارک اوپن در کار با ابزار (MCP-Atlas: ۸۹.۲) اول است، ولی در کدنویسیِ خالص (Terminal-Bench) از هر سه رقیب چینی عقبتر است. آزمون مستقلی هنوز نیست که داوری نهایی را بکند.
از کجا میتوانم امتحانش کنم؟
سریعترین راه APIهای میزبانیشده است: Baseten، Fireworks AI، Groq، Modal، Nebius، OpenRouter و Together AI. اگر میخواهی خودت اجرایش کنی، وزنها روی هاگینگفیساند و موتورهای SGLang، vLLM، MLX، llama.cpp و Unsloth از روز اول پشتیبانی میکنند.
آیا فارسی را خوب میفهمد؟
اعلام نشده. متا فقط گفته دادهٔ آموزشی بیش از ۱۰۰ زبان را پوشش میدهد، ولی هیچ بنچمارک یا ارزیابی مشخصی برای فارسی منتشر نشده است.
چرا همکاری متا و اپل مهم است؟
چون این دو شرکت معمولاً رقیباند و حالا روی بهینهسازی یک مدل غولپیکر برای چیپ M5 اولترا و فریمورک MLX اپل کار کردهاند. پیامش این است که «اجرای محلی مدلهای بزرگ» دارد از آزمایشگاه به دسکتاپ حرفهایها میآید — روندی که در ماههای آینده سختافزار و نرمافزار زیادی را با خودش میکشد.
منابع
مارکتکپست: انتشار میوز اسپارک اوپن؛ مدل ۸۱۶ میلیاردی وزنباز با زمینهٔ یک میلیون توکنی — https://www.marktechpost.com/2026/10/15/meta-muse-spark-open-816b-open-weight-model/
مکرومرز: متا و اپل مدل میوز اسپارک اوپن را به مک استودیو آوردند — https://www.macrumors.com/2026/10/15/meta-muse-spark-open-mac-studio/
9to5Mac: متا مدل میوز اسپارک اوپن را معرفی کرد؛ بهینه برای مک استودیو — https://9to5mac.com/2026/10/15/meta-launches-new-muse-spark-open-model-optimized-to-run-on-mac-studio/
Digit.in: متا میوز اسپارک اوپن را معرفی کرد؛ هوش چندوجهی روی مک استودیوهای M5 اولترا — https://www.digit.in/news/general/meta-announces-muse-spark-open-a-multimodal-ai-that-can-run-on-apple-mac-studios-powered-by-m5-ultra.html/amp/
Global1.News: متا مدل وزنباز هوش مصنوعی معرفی کرد که روی مکها اجرا میشود — https://global1.news/meta-launches-an-open-weight-ai-model-that-runs-on-macs
GloNCE: انتشار میوز اسپارک اوپن؛ مدل وزنباز ۸۱۶ میلیارد پارامتری — https://glonce.com/meta-releases-muse-spark-open-an-816b-parameter/
RR Tech Pulse: وزنهای میوز اسپارک اوپن روی مک استودیو اجرا میشوند — https://rrtechpulse.com/stories/meta-muse-spark-open-mac-studio/
AI Daily Digest (۱۷ اکتبر ۲۰۲۶): متا ۸۱۶ میلیارد پارامتر را باز کرد — https://dev.to/hiroki-ii-ai/ai-daily-digest-october-17-2026-meta-opens-816b-parameters-chatgpt-drives-chrome-anthropic-3pij


