فهرست مطالب
Llama for Windows برنامهای رایگان و متنباز است که مدلهای زبانی را بدون ترمینال، مستقیم از سینی سیستم ویندوز ۱۱ اجرا میکند؛ بهگفتهٔ هاگینگفیس که ۲۱ مهر (۱۳ اکتبر ۲۰۲۶) آن را معرفی کرد، کافی است مدل را با یک کلیک از هاگینگفیس دانلود کنی و با Alt+Space از دل هر برنامهای چت کنی — و همهچیز روی خود کامپیوترت میماند.
در این مطلب میفهمی این برنامه دقیقاً چه کار میکند، چرا با اینکه اسمش کنار RTX Spark آمده محصول انویدیا نیست، چه فرقی با LM Studio و Ollama دارد، و در چهار قدم چطور راهش میاندازی — از جمله اینکه عددهای «تخمین حافظه»اش را چطور بخوانی تا وسط دانلود چندگیگابایتی غافلگیر نشوی.
پاسخ کوتاه
Llama for Windows برنامهای رایگان و متنباز برای ویندوز ۱۱ است که مدلهای llama.cpp را بهصورت محلی اجرا میکند. پروژه متعلق به ggml-org — یعنی تیم کامیونیتی llama.cpp — است، نه انویدیا.
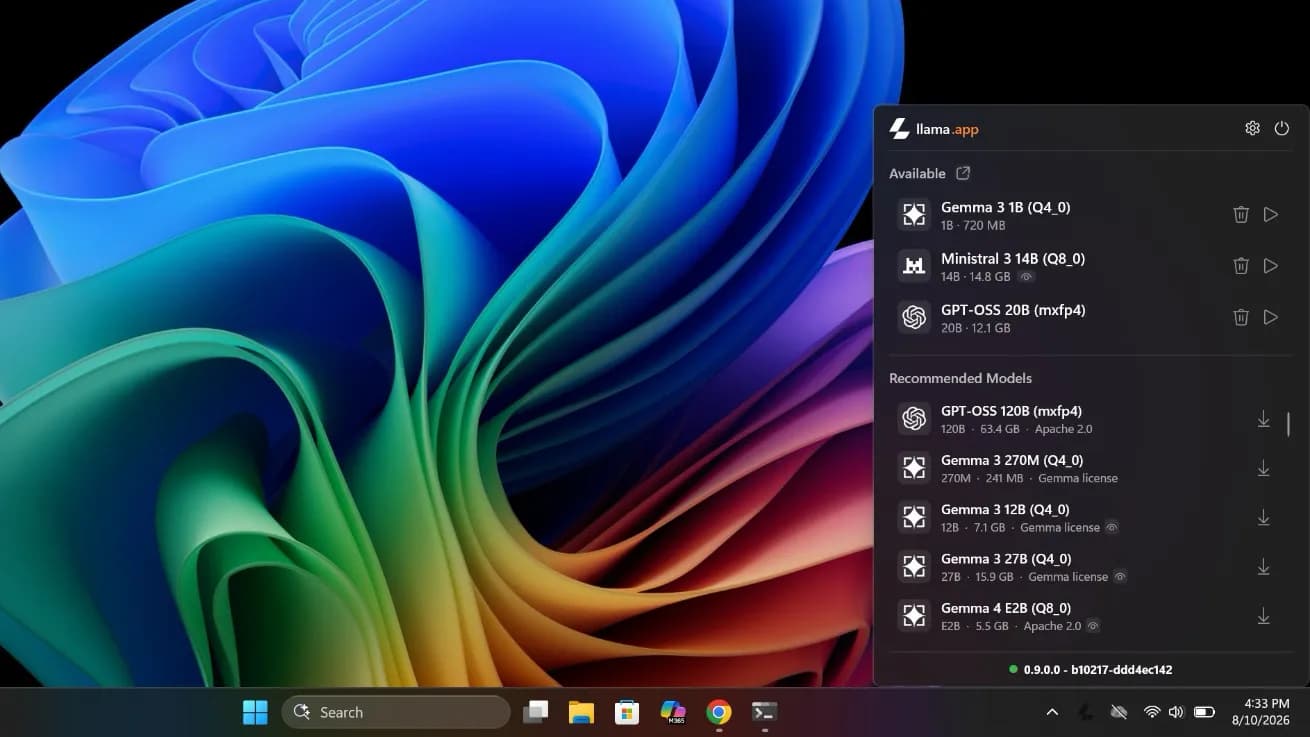
در سینی سیستم (همان ناحیهٔ اعلانها کنار ساعت) زندگی میکند: با یک کلیک مدل را از هاگینگفیس هاب دانلود میکنی، طول پنجرهٔ زمینه را انتخاب میکنی و تخمین حافظهٔ هر گزینه را همانجا میبینی.
با کلید Alt+Space از داخل هر برنامهای یک پنجرهٔ شناور باز میشود و گفتوگویت را نگه میدارد؛ لازم نیست پنجرهٔ جداگانهای باز نگه داری.
بهگفتهٔ سازندگان هیچ تلهمتری — یعنی هیچ دادهٔ ردیابی و آماری — ارسال نمیکند؛ پرامپتها و استنتاج کاملاً روی کامپیوتر خودت میمانند.
محدودیت اصلیاش دو چیز است: فقط روی ویندوز ۱۱ کار میکند، و نرمافزاری جوان است. اگر ابزار جاافتادهتری میخواهی، LM Studio یا Ollama را هم در ادامه مقایسه کردهایم.
اول زمینه: اجرای مدل زبانی روی کامپیوتر شخصی یعنی چه؟
قبل از اینکه سراغ خود برنامه برویم، سه مفهومی که مدام در این مطلب تکرار میشوند را ساده روشن کنیم؛ اگر این سه را بگیری، بقیهٔ مطلب برایت مثل آب خوردن است.
مدل محلی یعنی چه؟
مدل زبانی محلی یعنی فایل مدل روی هارد خودت دانلود میشود و کارت گرافیک یا پردازندهٔ خودت آن را اجرا میکند. فرقش با چتباتهای معروفی که در مرورگر باز میکنی مثل فرق کتابی است که میخری و در خانه میخوانی با کتابخانهای که برای هر بار خواندن باید عضو شوی و رفتوآمد کنی. مزیت بزرگش دو چیز است: اول اینکه متنی که تایپ میکنی هیچوقت از کامپیوترت بیرون نمیرود، دوم اینکه بعد از دانلود اولیه، حتی بدون اینترنت هم کار میکند. بهای این آزادی هم مشخص است: باید چند گیگابایت فضا روی هاردت خالی کنی و سختافزارت باید از پس اجرایش بربیاید.
چرا تا دیروز برای این کار ترمینال لازم بود؟
موتور اصلی اجرای مدلهای محلی، برنامهای متنباز و رایگان به اسم llama.cpp است — یعنی همان موتوری که بیشتر ابزارهای اجرای محلی دنیا رویش سوارند. مشکل اینجا بود که راهانداختنش روی ویندوز سه مرحلهٔ دستی داشت: پیدا کردن نسخهٔ مناسب سختافزار خودت، دانلود دستی فایل مدل، و بالا آوردن سرور با تنظیمات درست از داخل ترمینال. برای خیلیها همین سه مرحله یعنی «بیخیال». Llama for Windows دقیقاً همین سه مرحله را به چند کلیک تبدیل کرده؛ بهقول شعار رسمی مخزنش: «مدلهای زبانی محلی، یک کلیک فاصله — مستقیم از سینی سیستم ویندوزت.»
کوانتایز و فرمت GGUF یعنی چه؟
کوانتایز یعنی فشردهسازی وزنهای مدل — همان عددهایی که دانش مدل در آنها ذخیره شده. تشبیهش ساده است: مثل تبدیل عکس از فرمت سنگین RAW به JPEG؛ حجم خیلی کمتر میشود و کیفیت فقط کمی افت میکند. GGUF هم یعنی فرمت فایلی که خودِ تیم llama.cpp برای همین مدلهای فشرده معرفی کرد و بهگفتهٔ هاگینگفیس امروز استاندارد مدلهای محلی در هاگینگفیس هاب است. وقتی در ادامه میبینی برنامه «نسخههای کوانتایزشدهٔ آمادهاجرا» پیشنهاد میدهد، یعنی همین فایلهای GGUF را میگوید — فایلهایی که معمولاً چند گیگابایتاند، یعنی بهاندازهٔ چند فیلم سینمایی روی هاردت جا میگیرند.
Llama for Windows دقیقاً چه کار میکند؟
این برنامه پورت ویندوزیِ نسخهٔ مک است — همان Llama for macOS که با WinUI 3، یعنی فریمورک رابط کاربری مدرن مایکروسافت، برای ویندوز بازنویسی شده. سه کار را برایت انجام میدهد و هر سه را از همان سینی سیستم. اول: سرور llama.cpp را مدیریت میکند؛ اگر از قبل روی سیستمت نصب باشد به همان وصل میشود، وگرنه خودش با نصبکنندهٔ رسمی دانلودش میکند — و بهگفتهٔ مستندات رسمی، برای این کار حتی دسترسی ادمین هم لازم ندارد. دوم: دانلود مدل را ساده میکند؛ پنل «مدلهای پیشنهادی» نسخههای آمادهاجرای مدلهای محبوب هاگینگفیس را فهرست میکند و برای هر مدل سه چیز را همانجا نشان میدهد: تعداد پارامترها (یعنی بزرگی مدل)، حجمش روی دیسک، و اینکه بینایی هم دارد یا فقط متنی است. سوم: رابط چت را جلویت میگذارد، هم بهصورت پنجرهٔ شناور بالای آیکون سینی، هم بهصورت اورلی Alt+Space که در ادامه میبینی.
نکتهای که برایت مهم است: مدلها در کش استاندارد هاگینگفیس ذخیره میشوند — یعنی همان پوشهٔ مشترکی که llama.cpp و بقیهٔ ابزارهای هاگینگفیس هم از آن استفاده میکنند. عملاً یعنی مدل را یکبار دانلود میکنی و همهجا — داخل همین برنامه، در llama.cpp دستی، یا در ابزارهای دیگر — قابلاستفاده است.
یک اصلاح مهم: این برنامه مال انویدیا نیست
چرا این را جدا میگوییم؟ چون اسم Llama for Windows در پوشش «هفتهٔ عرضهٔ نرمافزاری RTX Spark» انویدیا در ۱۳ اکتبر برجسته شد و ممکن است فکر کنی محصول خود انویدیاست. نیست. مالک و توسعهدهندهٔ پروژه ggml-org است — همان کامیونیتیای که llama.cpp را میسازد — و کدش با مجوز MIT روی گیتهاب باز است. ماجرا از این قرار است: بهگفتهٔ هاگینگفیس، تیم پروژه با انویدیا همکاری کرده تا برنامه از روز اول عرضهٔ RTX Spark با آن سازگار باشد و مدلها را روی پردازندهٔ گرافیکی آن اجرا کند. پس «همکاری برای سازگاری» با «مالکیت» فرق دارد. این تمایز را نگه دار، چون دیروز در مطلب ما دربارهٔ NVIDIA PAIR دیدی که انویدیا دارد روی یک مسیریاب شخصیِ هوش مصنوعی سرمایهگذاری میکند — آن یک پروژهٔ جداست و ربطی به این برنامهٔ سینی سیستم ندارد.
ویژگیهایی که برای تو مهماند
حالا برویم سراغ چهار ویژگیای که تجربهٔ روزمرهات را میسازند؛ هر چهار را از مستندات رسمی برداشتهایم، بدون اغراق.
در سینی سیستم زندگی میکند، نه روی تسکبار
روی آیکون لاما در ناحیهٔ اعلانها کلیک میکنی و یک پنجرهٔ شناورِ بدون حاشیه — با همان طراحی شیشهای ویندوز ۱۱ — دقیقاً بالای آیکون باز میشود. هیچ پنجرهای روی تسکبار اشغال نمیکند و چیز دیگری برای مدیریت نداری؛ با راستکلیک روی آیکون هم میتوانی برنامه را باز کنی یا کامل ببندی. برای تو یعنی مدل زبانیات مثل یک ابزار دمدستی همیشه آنجاست، نه مثل یک برنامهٔ سنگین که باید باز و بستهاش کنی.
دانلود مدل با یک کلیک — و انتخاب طول زمینه با تخمین حافظه
روی هر مدل که کلیک کنی، جزئیاتش باز میشود: یک انتخابگر طول پنجرهٔ زمینه — یعنی حداکثر متنی که مدل در یک لحظه میتواند ببیند و به خاطر بسپارد؛ مثل ظرفیت حافظهٔ کوتاهمدتش — که برای هر گزینه تخمین حافظه را هم نشان میدهد. این تخمینها از هدر فایل GGUF خوانده میشوند، یعنی از خودِ فایل مدل، نه حدس برنامه. انتخابت برای هر مدل به خاطر سپرده میشود تا دفعهٔ بعد دوباره تنظیم نکنی. دانلود هم با یک کلیک شروع میشود و پیشرفتش را زنده در همان پنل میبینی؛ قبل از زدن دکمه، حجم روی دیسک را که برنامه نشان میدهد چک کن تا هاردت غافلگیر نشود.
اورلی Alt+Space: چت از دل هر برنامهای
از داخل هر برنامهای — مرورگر، ورد، هرچه — کلیدهای Alt و Space را بزنی، یک پنجرهٔ شناورِ بدون حاشیه باز میشود که رابط وبِ مدلی را نشان میدهد که بارگذاری کردهای. نکتهٔ ظریفش این است: این پنجره بهجای بسته شدن «پنهان» میشود؛ یعنی وقتی دوباره صدایش میزنی، فوری ظاهر میشود و گفتوگویت دقیقاً همانجایی است که رهایش کرده بودی. برای تو یعنی لازم نیست بین برنامهات و پنجرهٔ چت مدام جابهجا شوی؛ مدل مثل یک دستیار همیشهحاضر یک کلید فاصله دارد.
نصب خودکار llama.cpp — و چیزی برای سازندهها
همانطور که گفتیم، برنامه موتور llama.cpp را خودش مدیریت میکند و به دسترسی ادمین نیاز ندارد. اگر اهل ساختن هستی، یک نکتهٔ اضافه هم دارد: llama.cpp بهصورت یک سرور محلی روی خود کامپیوترت اجرا میشود و API سازگار با OpenAI دارد — یعنی برنامهها، اسکریپتها و ایجنتهای خودت میتوانند از همان مدلهایی استفاده کنند که برنامه بارگذاری کرده. طبق مستندات رسمی میتوانی توکن هاگینگفیس را در تنظیمات وارد کنی تا مدلهای محدودشده و خصوصی هم قابلاستفاده باشند، و لاگهای روزانه فقط ۷ روز نگه داشته میشوند — یعنی ردپای متنی برنامه هم محدود است.
چطور شروع کنی؟
چهار قدم زیر را دقیقاً از راهنمای رسمی برداشتهایم؛ هیچکدام ترمینال نمیخواهد.
روی یک کامپیوتر با ویندوز ۱۱، آخرین فایل نصب (نسخههای ۶۴ بیتی و آرم) را از صفحهٔ ریلیزهای گیتهاب — یا از سایت رسمی برنامه — بگیر و با دابلکلیک نصب کن.
برنامه را اجرا کن؛ آیکون لاما در ناحیهٔ اعلانها ظاهر میشود. اگر پنهان بود، منوی سرریز اعلانها را چک کن.
روی آیکون کلیک کن، از بخش «مدلهای پیشنهادی» مدلی را انتخاب کن و دانلود را با یک کلیک شروع کن. قبلش به حجم روی دیسک که برنامه نشان میدهد نگاه کن.
وقتی دانلود تمام شد، مدل را بارگذاری کن و رابط وب را باز کن تا چت شروع شود. از این به بعد Alt+Space از هر جایی همان گفتوگو را جلویت میگذارد.
یک توصیهٔ عملی: برای اولین تجربه، سراغ کوچکترین مدل پیشنهادی برو. دانلودش زودتر تمام میشود، حافظهٔ کمتری میخواهد، و میفهمی کل چرخه — دانلود، بارگذاری، چت — چطور کار میکند؛ بعداً میتوانی مدل بزرگتر امتحان کنی.
تخمین حافظه را چطور بخوانی؟
این بخش را جدا کردیم چون مهمترین جایی است که تازهکارها غافلگیر میشوند. تخمینی که برنامه از هدر فایل GGUF میخواند، مربوط به وزنهای مدل است — یعنی همان فایل چندگیگابایتی که دانلود میکنی. ولی حافظهٔ واقعیِ هنگام اجرا فقط وزنها نیست؛ هرچه پنجرهٔ زمینه را بزرگتر انتخاب کنی، مدل برای نگه داشتن آن متنِ طولانی حافظهٔ بیشتری میخواهد. پس اگر دو گزینهٔ زمینهٔ کوتاه و بلند داری و کارت گرافیکت حافظهٔ محدودی دارد، گزینهٔ کوتاهتر امنتر است.
و این را هم بهعنوان قاعدهٔ کلی دنیای اجرای محلی بدان، نه عدد خاص این برنامه: اگر حافظهٔ کارت گرافیک (VRAM — یعنی حافظهٔ اختصاصی خودِ کارت گرافیک، جدا از رم سیستم) کم بیاید، بخشی از مدل به رم معمولی منتقل میشود و سرعت جوابدهی افت محسوسی میکند. پس «تخمین حافظه» را سقف خوشبینانه بدان، نه قول قطعی؛ اگر سیستمت لب مرز است، مدل کوچکتر انتخاب کن.
Llama for Windows در برابر جایگزینها
جدول زیر چهار مسیر رایج اجرای مدل محلی را کنار هم میگذارد تا ببینی Llama for Windows دقیقاً کجای نقشه ایستاده است. هر چهار گزینه مدل را روی خود کامپیوترت اجرا میکنند و رایگاناند؛ تفاوت در پوسته و میزان درگیری تو با ترمینال است.
ویژگی | Llama for Windows | LM Studio | Ollama | llama.cpp (خط فرمان) |
|---|---|---|---|---|
محیط اجرا | فقط ویندوز ۱۱ | ویندوز، مک و لینوکس | ویندوز، مک و لینوکس | ویندوز، مک و لینوکس |
نصب و دانلود مدل | یک کلیک از هاگینگفیس | کاتالوگ داخلی برنامه | دستور در ترمینال | دانلود دستی فایل |
نیاز به ترمینال | ندارد | ندارد | دارد | دارد |
شکل رابط | آیکون سینی + پنجرهٔ شناور | برنامهٔ دسکتاپ کامل | خط فرمان | خط فرمان |
موتور اجرا | llama.cpp | llama.cpp | llama.cpp | llama.cpp |
قیمت | رایگان و متنباز | رایگان | رایگان و متنباز | رایگان و متنباز |
جدول را اینطور بخوان: سطر «موتور اجرا» مهمترین سطر است — هر سه ابزار گرافیکی در نهایت روی همان llama.cpp سوارند، پس تفاوت کیفیت اجرای مدل بینشان ذاتی نیست؛ تفاوت در تجربهٔ کاربری است. اگر برنامهٔ دسکتاپ کامل با کاتالوگ داخلی را ترجیح میدهی، آموزش نصب و اجرای مدل در LM Studio را که امروز منتشر کردیم ببین؛ اگر با ترمینال راحتی و کنترل بیشتر میخواهی، آموزش نصب و اجرای مدل با Ollama مسیر توست. Llama for Windows برای کسی است که میخواهد سبکترین و سریعترین درِ ورود را داشته باشد: نصب، یک کلیک، چت.
قیمت و دسترسی
بخش قیمت این مطلب عمداً کوتاه است: چیزی برای فهرست کردن وجود ندارد. برنامه رایگان و متنباز است (مجوز MIT طبق صفحهٔ گیتهاب)؛ نه اشتراک دارد، نه پلن پولی، نه قابلیتی که پشت پرداخت قفل شده باشد. دسترسیاش هم ساده است: فایل نصب را از صفحهٔ ریلیزهای گیتهاب یا سایت رسمی برنامه بگیر، دابلکلیک کن، تمام. تنها «هزینه»ای که میپردازی فضای هارد برای مدلهاست — که آن هم دست خودت است و قبل از دانلود، حجمش را میبینی.
محدودیتهایی که باید بدانی
قبل از اینکه ذوقزده شوی، این چهار محدودیت را بدان تا انتظارت واقعی باشد. اول: فقط ویندوز ۱۱. اگر ویندوز ۱۰ داری یا مکبوک، این برنامه برای تو نیست؛ کاربران مک نسخهٔ خواهرش — Llama for macOS — را دارند. دوم: نرمافزاری جوان است؛ مخزن گیتهابش چند ماهی بیشتر نیست که ساخته شده، پس ممکن است باگهای کوچک و زاویههای ناتمام داشته باشد — اگر حوصلهٔ نرمافزار تازهمتولدشده را نداری، چند ماه دیگر برگرد. سوم: مدلها چند گیگابایت حجم دارند و دانلودشان زمان میبرد؛ این را از قبل در برنامهریزیات حساب کن. چهارم: رابط برنامه بر اساس مستندات فعلی انگلیسی است و کیفیت زبان فارسی به مدلی که انتخاب میکنی بستگی دارد، نه به خود برنامه.
و یک جملهٔ صداقت که وظیفهمان است بگوییم: این بررسی بر اساس مستندات و منابع رسمی پروژه نوشته شده و آزمون مستقل ما روی همهٔ ادعاها انجام نشده؛ چیزی را که ندیدهایم، بهعنوان تجربهٔ شخصی جا نمیزنیم.
نکتهای برای خوانندهٔ فارسیزبان
چون مدل روی خود کامپیوترت اجرا میشود، برای استفادهٔ روزمره از مدلهای عمومی به هیچ حساب خارجی نیاز نداری — همین، بزرگترین برد حریم خصوصی این روش است و ربطی به موقعیت جغرافیاییات ندارد.
فقط برای مدلهای محدودشده و خصوصی هاگینگفیس باید توکن حساب هاگینگفیس را در تنظیمات وارد کنی (طبق مستندات رسمی)؛ این بخش تنها جایی است که حساب لازم دارد.
کیفیت فارسی به مدل انتخابی تو بستگی دارد، نه به برنامه. قبل از دانلود چندگیگابایتی، صفحهٔ مدل در هاگینگفیس را بخوان و ببین پشتیبانی از فارسی را چطور توصیف کرده؛ مدلهای چندزبانه معمولاً انتخاب امنتریاند.
دربارهٔ شرایط استفاده و محدودیتهای منطقهای، ملاک همان چیزی است که در مستندات رسمی آمده؛ ما راه دور زدن هیچ محدودیتی را پیشنهاد نمیکنیم.
خبرهای مدلهای تازه را هم دنبال کن — مثل مدل Nemotron-35-Bolt-74B که امروز معرفی شد؛ هر مدلی که نسخهٔ سازگار با llama.cpp داشته باشد، در همین اکوسیستمی مینشیند که این برنامه برایش ساخته شده.
جمعبندی
به تازگی وزنهای beam از رفلکشن به صورت متنباز منتشر شده است.
https://fanavarikade.com/fa/news/reflection-beam-open-weights-chist
پس تصمیم با توست. اگر ویندوز ۱۱ داری، از ترمینال فراری هستی و میخواهی برای اولینبار یک مدل زبانی را واقعاً روی کامپیوتر خودت — خصوصی و بدون حساب — اجرا کنی، Llama for Windows امروز سبکترین درِ ورود است: نصبش دابلکلیک است، مدلش یک کلیک، و چتش یک میانبر صفحهکلید. اگر ابزار جاافتادهتر با امکانات بیشتر میخواهی، LM Studio انتخاب بالغتری است؛ اگر هم ویندوز ۱۰ یا مک داری، این برنامه اصلاً برای تو ساخته نشده و دنبالش نگرد. دنیای مدلهای محلی دیگر فقط برای اهل رمینال نیست — و این برنامه دقیقاً برای همین ساخته شده.
Llama for Windows فقط روی ویندوز ۱۱ اجرا میشود. اگر هنوز ویندوز ۱۰ داری، حالا نسخهٔ 26H2 ویندوز ۱۱ برای کامپیوترهای سازگار ویندوز ۱۰ هم در Windows Update آمده است؛ شرایط ارتقای ویندوز ۱۰ به ویندوز ۱۱ نسخهٔ 26H2 را جداگانه توضیح دادهایم.
اگر ترجیح میدهید مدلهای محلی را از یک رابط وب مدیریت کنید، Libre WebUI گزینهٔ دیگری است؛ رابطی خودمیزبان که روی کامپیوتر یا سرور خودتان اجرا میشود و میتواند هم به Ollama وصل شود و هم به سرویسهای ابری.
سؤالات پرتکرار
آیا Llama for Windows محصول انویدیاست؟
نه. پروژه متعلق به ggml-org — تیم کامیونیتی سازندهٔ llama.cpp — است و کدش متنباز است. انویدیا فقط آن را در پوشش هفتهٔ عرضهٔ RTX Spark برجسته کرد و تیم پروژه با انویدیا همکاری کرده تا برنامه از روز اول با RTX Spark سازگار باشد.
برای استفاده به حساب هاگینگفیس نیاز دارم؟
برای دانلود مدلهای عمومی نه. فقط اگر بخواهی از مدلهای محدودشده (gated) یا خصوصی استفاده کنی، باید توکن هاگینگفیس را طبق مستندات رسمی در تنظیمات برنامه وارد کنی.
بعد از دانلود مدل، اینترنت لازم است؟
نه برای چت. بهگفتهٔ مستندات رسمی، استنتاج کاملاً محلی انجام میشود و به اینترنت نیازی نیست؛ اینترنت فقط برای دانلود اولیهٔ مدل و بررسی بهروزرسانیهای برنامه لازم است.
مدلها کجا ذخیره میشوند و چقدر فضا میگیرند؟
در کش استاندارد هاگینگفیس روی کامپیوترت — همان پوشهٔ مشترکی که llama.cpp و ابزارهای دیگر هم از آن استفاده میکنند. حجم هر مدل قبل از دانلود در برنامه نمایش داده میشود و معمولاً چند گیگابایت است.
روی ویندوز ۱۰ هم کار میکند؟
نه. مستندات رسمی فقط از ویندوز ۱۱ نام میبرند (در دو نسخهٔ ۶۴ بیتی و آرم). کاربران مک هم نسخهٔ جداگانهای به اسم Llama for macOS دارند.
زبان فارسی را چطور پشتیبانی میکند؟
خود برنامه فقط اجراکننده است؛ کیفیت فارسی به مدلی که دانلود میکنی بستگی دارد. قبل از دانلود، صفحهٔ مدل در هاگینگفیس را چک کن و دنبال مدلهایی باش که پشتیبانی چندزبانه را ذکر کردهاند.
میتوانم از API آن در برنامهٔ خودم استفاده کنم؟
بله. llama.cpp بهصورت یک سرور محلی روی کامپیوترت اجرا میشود و API سازگار با OpenAI دارد؛ پس اسکریپتها و برنامههای خودت میتوانند به همان مدلهای بارگذاریشده وصل شوند.
اگر Alt+Space با برنامهٔ دیگری تداخل داشت چه؟
در مستندات رسمی چیزی دربارهٔ تداخل این میانبر اعلام نشده. اگر برنامهٔ دیگری روی سیستمت از همین ترکیب استفاده میکند، اول همان را چک کن؛ خود اورلی هم با راستکلیک روی آیکون سینی همیشه در دسترس است.
منابع