فهرست مطالب
انویدیا امروز، پنجشنبه ۲۳ مهر ۱۴۰۵، مدل «نموترون ۳.۵ بولت ۷۴B» را منتشر کرد؛ مدلی با ۷۴ میلیارد پارامتر که فقط ۹ میلیاردشان در هر لحظه فعالاند و بهگفتهٔ انویدیا با فشردهسازی ۲بیتی در ۲۴ گیگابایت حافظه جا میشود. نکتهٔ مهم اما این است که انویدیا میگوید مدل را کاملاً متنباز داده: وزنها، دادههای آموزشی و حتی دستور پخت آموزش.
اگر دنبال اجرای یک ایجنت هوش مصنوعی روی کامپیوتر خودتان هستید — بدون اشتراک ماهانه، بدون فرستادن دادهها به ابر — این خبر مستقیماً به شماست. در این مطلب میبینید امروز دقیقاً چه چیزی منتشر شده، این اعداد عجیب (۷۴ میلیارد، ۹ میلیارد، ۲ بیت) در عمل یعنی چه، با چه سختافزاری اجرایش میکنید — و کدام ادعاها را فعلاً باید با احتیاط شنید، چون هنوز هیچ بنچمارک مستقلی از این مدل منتشر نشده است.
پاسخ کوتاه
چه چیزی: مدل زبانی «نموترون ۳.۵ بولت ۷۴B» انویدیا، با معماری «ترکیبی متخصصان» (یعنی مدلی که از بین دهها زیرشبکهٔ تخصصی، برای هر کلمه فقط چندتایشان را بیدار میکند).
کی منتشر شد: امروز، ۲۳ مهر ۱۴۰۵ (۱۵ اکتبر ۲۰۲۶)؛ انتشار در طول امروز انجام میشود و وزنها روی هاگینگفیس مینشینند.
چرا مهم است: بهگفتهٔ انویدیا، مدلی در کلاس ۷۴ میلیارد پارامتر که روی یک لپتاپ یا کارت گرافیک ۲۴ گیگابایتی اجرا میشود — و کاملاً متنباز است.
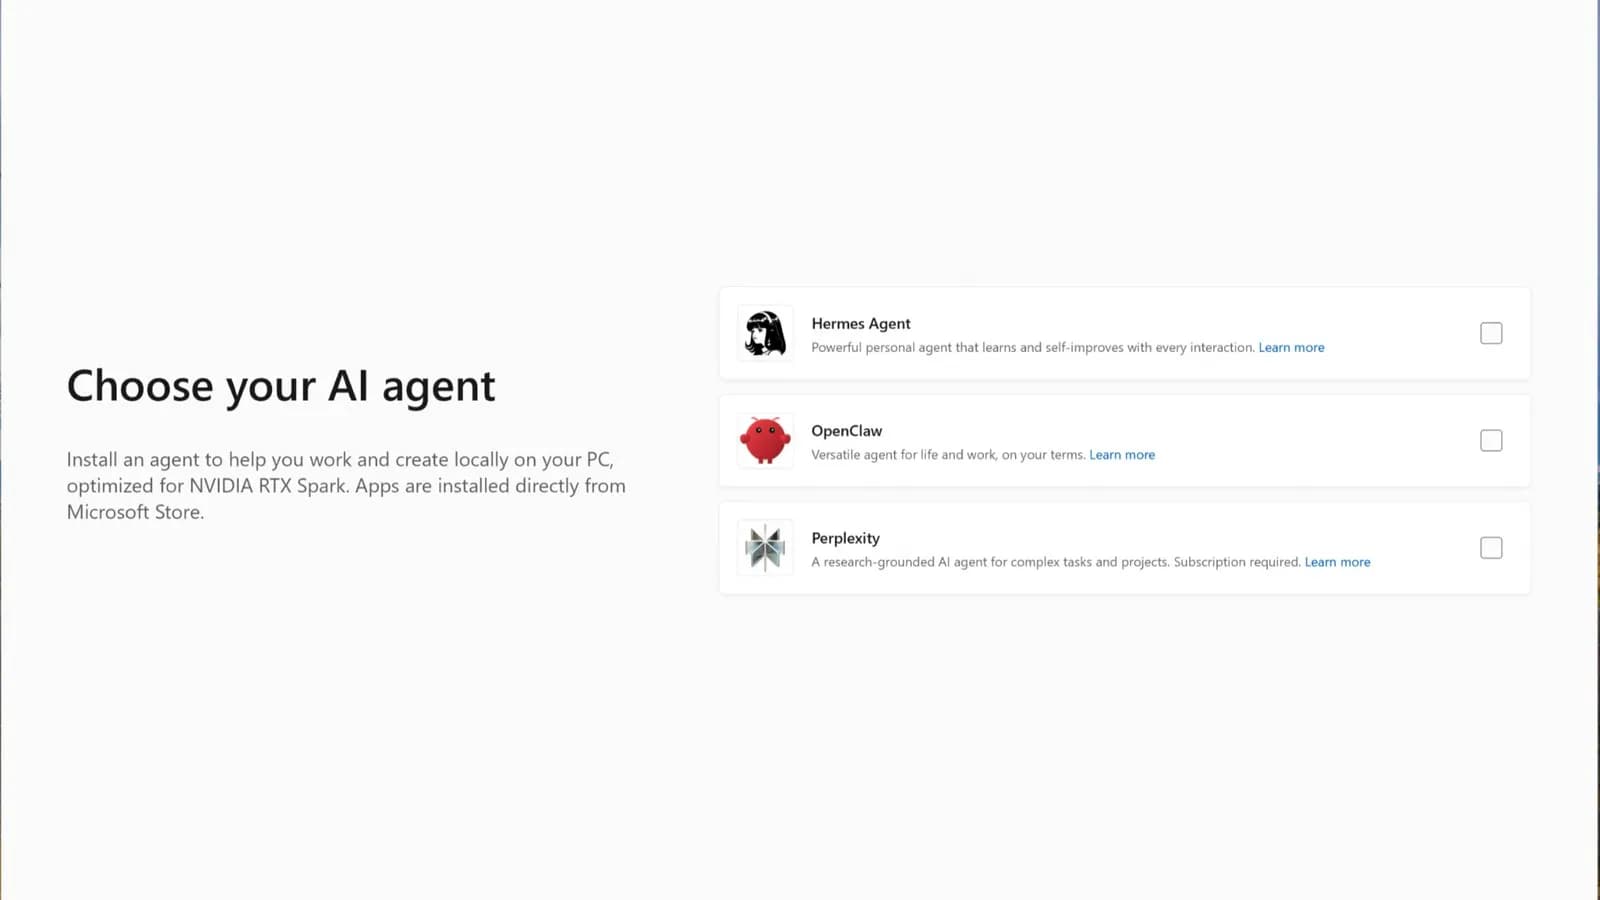
از کجا اجرایش کنید: از امروز از طریق llama.cpp، vLLM، Ollama، Unsloth و LM Studio، و از داخل ایجنتهایی مثل Hermes و OpenClaw.
احتیاط لازم: ادعاهای سرعت و کیفیت، ادعای خود انویدیاست؛ هنوز بنچمارک مستقلی از مدل منتشر نشده و عدد «۲۴ گیگابایت» فقط وزنهاست، نه حافظهٔ واقعی اجرا.
اول زمینه: چرا به این مدل میگویند «ایجنتمحور»؟
«ایجنت» یعنی برنامهای که فقط جواب نمیدهد؛ کار انجام میدهد. فایل میخواند، ابزار صدا میزند، چند مرحله جلو میرود و نتیجه را برمیگرداند. تا همین پارسال، چنین کاری روی کامپیوتر شخصی تقریباً ممکن نبود، چون مدلهایی که بتوانند چند مرحله استدلال کنند و ابزار صدا بزنند، معمولاً آنقدر بزرگ بودند که فقط در دیتاسنتر جا میشدند.
چرا اجرای محلی برای ایجنت مهم است؟
سه دلیل ساده دارد. اول، حریم خصوصی: دادههای شما از کامپیوترتان بیرون نمیرود. دوم، هزینه: اشتراک ماهانهٔ API ندارید؛ یک بار دانلود میکنید و تمام. سوم، دسترسپذیری: بدون اینترنت هم کار میکند. انویدیا میگوید دانلود مدلهای محلی امسال «پنج برابر کل پارسال» شده — ادعایی که رسانهٔ تحلیلی alfw.ai یادآوری میکند انویدیا برایش هیچ متدولوژی، دورهٔ زمانی یا تعریف دقیقی از «دانلود» ارائه نکرده است؛ پس جهت رشد را باور کنید، عدد دقیق را نه.
نموترون ۳.۵ بولت کجای این تصویر است؟
انویدیا این مدل را دقیقاً برای همین شکاف ساخته: مدلی که بهقدر کافی باهوش باشد که یک ایجنت را بچرخاند، و بهقدر کافی کوچک که روی لپتاپ بماند. دیروز در همین سایت نوشتیم که این مدل چیست و چرا ۲۴ گیگابایت مهم است؛ امروز خبر این است که وزنها واقعاً منتشر شدهاند و میتوانید دانلودشان کنید.
امروز دقیقاً چه چیزی منتشر شد؟
انویدیا مدل را ۱۳ اکتبر در وبلاگ توسعهدهندگانش معرفی کرده بود و تاریخ انتشار وزنها را امروز، ۱۵ اکتبر، اعلام کرده بود. به گزارش امروز windowsforum، انتشار مدل انجام شده و رسانهٔ gurujicorp هم تأیید میکند که طبق برنامهٔ خود انویدیا، وزنها در طول امروز روی هاگینگفیس قرار میگیرند (بررسی صبح امروز آنها نشان داد فهرست API هاگینگفیس هنوز مدل را ایندکس نکرده بود — یعنی انتشار تدریجی است، نه یک لحظه).
نام دقیق مدل چیست؟
نام کاملش Nemotron 3.5 Bolt 74B-A9B 24GB است. هر بخشش یک مشخصه است: ۷۴B یعنی ۷۴ میلیارد پارامتر کل، A9B یعنی حدود ۹ میلیارد پارامتر فعال، و 24GB یعنی ردپای حافظهای که انویدیا ادعا میکند. این نامگذاری را به خاطر بسپارید؛ وقتی در LM Studio یا Ollama دنبالش میگردید، همین نام را خواهید دید.
از کجا دانلودش میکنید؟
بهگفتهٔ انویدیا، در روز عرضه پنج مسیر رسمی دارد: llama.cpp، vLLM، Ollama، Unsloth و LM Studio. یعنی هم مسیر حرفهای (vLLM برای سرور)، هم مسیر سادهٔ دسکتاپ (Ollama و LM Studio برای ویندوز و مک؛ اگر با Ollama آشنا نیستید، راهنمای نصب و اجرای مدل در Ollama را ببینید). علاوه بر این، ایجنتهای Hermes و OpenClaw از امروز مستقیماً به آن وصل میشوند.
۷۴ میلیارد پارامتر یعنی چه، وقتی فقط ۹ میلیاردشان کار میکند؟
«پارامتر» یعنی وزنهای عددی مدل — چیزی شبیه سلولهای حافظهاش. هرچه بیشتر، معمولاً باهوشتر. اما نکته اینجاست: در معماری «ترکیبی متخصصان» (Mixture of Experts)، مدل مثل یک بیمارستان است با دهها متخصص؛ برای هر سؤال فقط متخصصهای مرتبط بیدار میشوند. پس ۷۴ میلیارد پارامتر «دانش ذخیرهشده» است، ولی هزینهٔ محاسباتی هر کلمه فقط بهاندازهٔ ۹ میلیارد پارامتر است.
این با مدلهای معمولی چه فرقی دارد؟
در مدل «چگال» (مثل بیشتر مدلهای معروفی که میشناسید)، برای هر کلمه همهٔ پارامترها فعالاند: دانش بیشتر = محاسبات بیشتر = کندتر و پرمصرفتر. در مدل MoE، دانش بیشتر بدون هزینهٔ محاسباتی بیشتر به دست میآید. قیمتش این است که همهٔ ۷۴ میلیارد پارامتر باید جایی ذخیره شوند — و اینجاست که فشردهسازی ۲بیتی وارد میشود.
ادعای انویدیا دقیقاً چیست؟
انویدیا میگوید این مدل «سریعتر از بیشتر مدلهای چگال محبوب و هوشمندتر از مدلهای MoE همرده از نظر حافظه» است. این جمله را با احتیاط بخوانید: اولاً «محبوب» و «همرده» تعریف نشدهاند، ثانیاً تا امروز هیچ بنچمارک مستقلی منتشر نشده که این ادعا را بسنجد. رسانههای derringtoncollaborativeai و alfw.ai هر دو همین هشدار را دادهاند: اینها ادعای فروشنده است، نه نتیجهٔ آزمایش مستقل.
کوانتیزاسیون ۲بیتی یعنی چه؟
«کوانتیزاسیون» یعنی فشردهسازی وزنهای مدل. هر پارامتر معمولاً یک عدد ۱۶بیتی است؛ اگر همان عدد را با ۲ بیت ذخیره کنید، حجم مدل تقریباً به یکهشتم میرسد. مشکل این است که فشردهسازی خشن معمولاً مدل را «کندذهن» میکند — مثل اینکه کتابی را با حذف حروف خلاصه کنید.
QAT یعنی چه و چرا مهم است؟
QAT مخفف Quantization-Aware Training یعنی «آموزش آگاه از کوانتیزاسیون»: بهجای اینکه مدل کامل آموزش ببیند و بعد فشرده شود، از همان اولِ آموزش، مدل یاد میگیرد با وزنهای فشرده کار کند. بهگفتهٔ انویدیا همین تکنیک است که اجازه داده ۷۴ میلیارد پارامتر در ۲۴ گیگابایت جا شود «بدون از دست دادن کیفیت». باز هم: این ادعای انویدیاست و آزمون مستقلش هنوز نیامده.
۲۴ گیگابایت: عدد واقعی اجرا چقدر است؟
این مهمترین نکتهٔ عملی مطلب است. عدد ۲۴ گیگابایت فقط وزنهای مدل است. وقتی مدل اجرا میشود، چیزهای دیگری هم حافظه میخواهند: «کش KV» (یعنی حافظهٔ مکالمه — هرچه متن طولانیتر، بیشتر)، خودِ موتور اجرا (llama.cpp یا vLLM)، و سیستمعامل. پس روی یک کارت ۲۴ گیگابایتی، در عمل با متنهای طولانی ممکن است به سقف بخورید. این را رسانهٔ alfw.ai هم صریح گفته: حافظهٔ واقعی استقرار به طول کانتکست، کش KV و سربار رانتایم بستگی دارد و انویدیا هنوز نتیجهای از «سرعت و کیفیت قابلاستفاده روی ماشین ۲۴ گیگابایتی» منتشر نکرده است.
پس روی چه سختافزاری جواب میدهد؟
انویدیا این مدل را برای لپتاپهای RTX Spark بهینه کرده — لپتاپهایی با تا ۱۲۸ گیگابایت حافظهٔ یکپارچه که فردا، جمعه ۲۴ مهر (۱۶ اکتبر)، از لنوو، ایسر و شرکای دیگر انویدیا به فروش میرسند. اما محدود به آنها نیست: هر سیستمی با حدود ۲۴ گیگابایت حافظهٔ گرافیکی یا یکپارچه (مثل کارتهای سری RTX 4090 یا مکهای با حافظهٔ یکپارچهٔ بالا) کاندیدای اجراست. قیمت لپتاپهای RTX Spark هنوز رسماً اعلام نشده است.
مشخصات رسمی مدل در یک نگاه
جدول زیر فقط مشخصاتی را نشان میدهد که انویدیا رسماً اعلام کرده؛ چیزی به آن اضافه نشده است:
مشخصه | مقدار (بهگفتهٔ انویدیا) |
|---|---|
نام کامل | Nemotron 3.5 Bolt 74B-A9B 24GB |
معماری | ترکیبی متخصصان (MoE) |
پارامتر کل | ۷۴ میلیارد |
پارامتر فعال در هر توکن | حدود ۹ میلیارد |
کوانتیزاسیون | ۲بیت با آموزش آگاه از کوانتیزاسیون (QAT) |
ردپای حافظهٔ ادعاشده | ۲۴ گیگابایت (فقط وزنها) |
مجوز | کاملاً متنباز: وزنها، دادههای آموزشی و رسیپیها |
ابزارهای روز عرضه | llama.cpp، vLLM، Ollama، Unsloth، LM Studio |
ایجنتهای سازگار | Hermes، OpenClaw |
تاریخ انتشار وزنها | ۱۵ اکتبر ۲۰۲۶ (امروز، ۲۳ مهر ۱۴۰۵) |
نتیجهای که از جدول میگیرید: این یک مدل «دانلودی» است، نه «سرویسی» — چیزی برای خرید اشتراک وجود ندارد؛ فایل را میگیرید و اجرا میکنید.
امروز در اکوسیستم چه چیزهای دیگری هم رسید؟
انتشار بولت ۷۴B تنها خبر امروز نیست؛ انویدیا هفتهٔ عرضهٔ RTX Spark را به یک «هفتهٔ نرمافزار» تبدیل کرده و چند ابزار مکمل هم رسیدهاند. این هفته انویدیا چند پروژه را هم متنباز کرده، از جمله پلتفرم Run:ai برای ارکستراسیون GPU:
PAIR از بتا خارج شد
ابزار PAIR (روتر شخصی هوش مصنوعی) انویدیا که ۱۳ اکتبر از بتا خارج شد، رایگان و متنباز است و بار کاری استنتاج را بین کامپیوترهای سازگار شبکهٔ خانگیتان پخش میکند. نسخهٔ نهایی پشتیبانی از llama.cpp و دانلود مستقیم مدل از هاگینگفیس را اضافه کرده و روی ویندوز، لینوکس و مک کار میکند. دیروز در همین سایت دربارهٔ خروج PAIR از بتا نوشتیم.
Llama for Windows رسید
تیم llama.cpp امروز اپلیکیشن Llama for Windows را منتشر کرد: برنامهای رایگان و متنباز که از سینی سیستم ویندوز ۱۱ اجرا میشود و دانلود و اجرای مدلهای محلی را بدون خط فرمان ممکن میکند. دقت کنید: این محصولِ گروه توسعهدهندهٔ llama.cpp (پروژهٔ ggml-org) است، نه انویدیا — هرچند انویدیا در خبرش به آن اشاره کرده. (امروز عصر در بخش ابزارهای هوش مصنوعی همین سایت، بررسی کاملتری از آن میخوانید.)
Switchyard: روتر بین محلی و ابری
انویدیا کتابخانهٔ متنباز Switchyard را هم معرفی کرده که به ایجنتها اجازه میدهد هوشمندانه بین مدل محلی (رایگان و سریع برای کارهای ساده) و مدل ابری (برای کارهای سنگین) جابهجا شوند. ایدهاش ساده است: چرا برای یک خلاصهسازی ساده پول API بدهید، وقتی مدل روی لپتاپتان از پسش برمیآید؟
کدام ادعاها را فعلاً باور نکنیم؟
بیایید صادق باشیم؛ سه چیز هست که امروز نمیدانیم:
کیفیت واقعی: هیچ بنچمارک مستقلی از بولت ۷۴B منتشر نشده. ادعای «سریعتر و هوشمندتر» فعلاً فقط حرف انویدیاست. بنچمارکهای مستقلی که باید منتظرشان باشیم معمولاً روی وظایف ایجنتی (مثل SWE-Bench یا TauBench) و کیفیت عمومی (مثل MMLU) اجرا میشوند.
هزینهٔ واقعی اجرا: عدد ۲۴ گیگابایت فقط وزنهاست. تا کسی مدل را روی یک سیستم ۲۴ گیگابایتی واقعی با کانتکست طولانی تست نکند، نمیدانیم عملاً چقدر حافظه میخواهد.
رشد ۵ برابری دانلودها: انویدیا میگوید دانلود مدلهای محلی ۵ برابر کل پارسال شده، ولی همانطور که alfw.ai اشاره کرده، نه دورهٔ زمانی مشخص است، نه تعریف «دانلود»، نه روش اندازهگیری. جهت را قبول کنید، دقت عدد را نه.
پس چرا این خبر مهم است؟
چون حتی اگر نیمی از ادعاها درست باشند، این اولین باری است که یک مدل ۷۴ میلیارد پارامتریِ کاملاً متنباز (با دادههای آموزشی و رسیپیها، نه فقط وزنها) برای اجرا روی سختافزار شخصی منتشر میشود. این یعنی توسعهدهندهها میتوانند آن را فاینتیون کنند و ایجنتهای خودشان را رویش بسازند — بدون اجارهٔ مدل از کسی.
قیمت، دسترسی و وضعیت برای کاربر ایرانی
خبر خوب: مدل رایگان است. وزنها، دادههای آموزشی و رسیپیها متنباز منتشر میشوند؛ چیزی برای خریدن وجود ندارد. ابزارهای اجرایش (Ollama، LM Studio، llama.cpp) هم رایگاناند. تنها «هزینه» شما حجم دانلود است: حدود ۲۴ گیگابایت فقط برای وزنها، بهعلاوهٔ فایلهای جانبی.
از ایران چه محدودیتی وجود دارد؟
دانلود از هاگینگفیس معمولاً بدون تحریم مستقیم در دسترس است، ولی سرعت و پایداری اتصال به کیفیت اینترنت شما بستگی دارد. نکتهٔ مهمتر سختافزار است: برای اجرای روان به حدود ۲۴ گیگابایت حافظهٔ گرافیکی یا یکپارچه نیاز دارید؛ روی سیستمهای ضعیفتر میتوانید نسخههای فشردهتر (کوانتیزههای بالاتر که جامعه منتشر میکند) را امتحان کنید، ولی کیفیتشان را فعلاً کسی تضمین نکرده است. ما راه دور زدن تحریم یا محدودیت را توصیه نمیکنیم؛ شرایط هر سرویس را از سایت رسمیاش چک کنید.
۵ کاری که از امروز میتوانید با بولت ۷۴B بکنید
۱. یک ایجنت کدنویس محلی بچرخانید: مدل را در Ollama یا LM Studio بالا بیاورید و به OpenClaw یا Hermes وصلش کنید؛ ایجنت میتواند فایل بخواند، کد بنویسد و تست بگیرد — بدون اینکه کدتان به جایی ارسال شود.
۲. دستیار پژوهشی آفلاین بسازید: اسناد PDF خودتان را به ایجنت بدهید و از آن خلاصه و پرسشوپاسخ بخواهید؛ همهچیز روی دستگاه شما میماند.
۳. با PAIR چند کامپیوتر را یکی کنید: اگر در خانه یا دفتر چند سیستم دارید، PAIR بار کاری را بینشان پخش میکند تا ایجنت سنگین، یک دستگاه را خفه نکند.
۴. فاینتیونش کنید: چون دادههای آموزشی و رسیپیها هم منتشر شدهاند، میتوانید مدل را روی دادهٔ تخصصی خودتان (مثلاً متون فارسی حوزهٔ کاریتان) تنظیم دقیق کنید.
۵. صبر کنید و بنچمارکها را ببینید: اگر عجله ندارید، یک هفته صبر کنید؛ بنچمارکهای مستقل که بیایند، معلوم میشود این مدل واقعاً در چه سطحی است و آیا ارزش ۲۴ گیگابایت دانلود را دارد.
جمعبندی: دانلود کنیم یا نه؟
اگر توسعهدهندهاید یا روی ایجنتهای محلی کار میکنید: بله، امروز دانلودش کنید و تستش کنید — رایگان است، متنباز است، و ابزارهای اجرایش آمادهاند. اگر کاربر عادی هستید و فقط یک دستیار روزمره میخواهید: یک هفته صبر کنید تا بنچمارکهای مستقل بیایند؛ آنوقت با چشم باز تصمیم میگیرید. و اگر سختافزار ۲۴ گیگابایتی ندارید: این مدل فعلاً برای شما نیست، ولی مسیرش را دنبال کنید — مدل کوچکتر Bolt E4B با ۴ گیگابایت حافظه، ۱ آبان (۲۳ اکتبر) میآید و برای کاراکترهای بازی و ایجنتهای سبک طراحی شده است.
پرسشهای متداول
نموترون ۳.۵ بولت ۷۴B دقیقاً چه زمانی منتشر شد؟
انویدیا تاریخ انتشار وزنها را ۱۵ اکتبر ۲۰۲۶ (امروز، ۲۳ مهر ۱۴۰۵) اعلام کرده بود و انتشار در طول امروز انجام میشود. مدل یک روز قبل از عرضهٔ لپتاپهای RTX Spark در ۱۶ اکتبر میآید.
آیا این مدل رایگان است؟
بله. بهگفتهٔ انویدیا کاملاً متنباز منتشر میشود: وزنها، دادههای آموزشی و دستور پخت آموزش. ابزارهای اجرایش (Ollama، LM Studio، llama.cpp) هم رایگاناند.
برای اجرایش چه سختافزاری لازم است؟
طبق ادعای انویدیا حدود ۲۴ گیگابایت حافظه برای وزنها کافی است، ولی در عمل کش مکالمه و سربار اجرا هم حافظه میخواهند. انویدیا آن را برای لپتاپهای RTX Spark (با تا ۱۲۸ گیگابایت حافظهٔ یکپارچه) بهینه کرده است.
فرقش با مدلهای معروفی مثل GPT یا Claude چیست؟
آنها مدلهای سرویسی و بستهاند: از طریق API یا اپ استفاده میکنید و دادهتان به سرور آنها میرود. بولت ۷۴B مدلی دانلودی و متنباز است که روی دستگاه خودتان اجرا میشود.
کوانتیزاسیون ۲بیتی به کیفیت لطمه نمیزند؟
این سؤالِ یکمیلیون دلاری است و جواب مستقلش را هنوز نداریم. انویدیا میگوید با تکنیک QAT کیفیت حفظ شده، ولی تا بنچمارکهای مستقل نیایند، این ادعا تأیید نشده است.
مدل کوچکتر Bolt E4B چیست؟
نسخهٔ ۴ گیگابایتی همین خانواده که ۲۳ اکتبر (۱ آبان) منتشر میشود و برای ایجنتهای مکالمهای و کاراکترهای بازی طراحی شده؛ قرار است داخل پلتفرم مادینگ SkyrimNET برای بازی اسکایریم هم قابلتجربه باشد.
دیروز هم دربارهٔ همین مدل نوشته بودید؛ فرق امروز چیست؟
دیروز پیشنمایش مدل را پوشش دادیم (معرفی و مشخصات اعلامشده). امروز خبر انتشار واقعی وزنهاست: چه چیزی دقیقاً منتشر شده، از کجا بگیریدش و کدام ادعاها هنوز تأیید نشدهاند.
منابع
وبلاگ انویدیا: All Systems Go: Global PC App Ecosystem Ready for NVIDIA RTX Spark
windowsforum: Windows on Arm Local AI: RTX Spark, Hybrid Inference and Cloud API Trade-Offs
derringtoncollaborativeai: NVIDIA squeezed a 74B agentic model into 24GB — and open-sourced the whole thing
gurujicorp: 74 Billion Parameters, Only 9 Billion Active, 24GB of RAM: NVIDIA's Open Agent Model Lands Today
techtimes: NVIDIA RTX Spark Launches Friday: 74-Billion-Parameter AI Fits in 24GB Laptop
pokde.net: RTX Spark Launch Week: Nemotron 3.5 Bolt and DLSS 5 Updates
مدل دیپسیک V4.1-Flash-1017 را هم ببین؛ در کدنویسی اوپوس ۵ را شکست داده است.


