فهرست مطالب
انویدیا چهارشنبه ۶ آبان ۱۴۰۵ (۲۸ اکتبر ۲۰۲۶) مدل تازهای به اسم Nemotron 3.5 Transcribe (نموترون ۳.۵ ترنسکرایب) منتشر کرد. جواب کوتاه این است: یک مدل رایگان و «وزنباز» برای تبدیل فایل صوتی به متن که ۴۰ زبان را میشناسد، تا یک ساعت صدا را یکجا پیاده میکند، تا هشت گوینده را از هم جدا میکند و میتواند متن را به انگلیسی یا از انگلیسی ترجمه کند.
نکتهٔ مهم برای خوانندهٔ فارسیزبان همین اول کار: فارسی در فهرست ۴۰ زبان این مدل نیست. پس اگر دنبال ابزاری برای پیاده کردن جلسه یا پادکست فارسی هستید، این مدل فعلاً جواب آمادهای برایتان ندارد. با این حال خبر مهمی است، چون نشان میدهد ابزارهای تبدیل گفتار به متن دارند از «فقط نوشتن کلمهها» به سمت فهمیدن جلسه، تشخیص اینکه چه کسی چه گفت و پیروی از دستور کاربر میروند. در ادامه ساده توضیح میدهیم این مدل چه میکند، عددهایش چه معنایی دارند و برای چه کسانی به درد میخورد.
خلاصهٔ خبر در چند خط
چه چیزی منتشر شد؟ Nemotron 3.5 Transcribe، مدل تبدیل گفتار به متن انویدیا، همراه با نسخهٔ دوم مجموعهدادهٔ صوتی Granary.
چه کارهایی میکند؟ پیاده کردن متن در ۴۰ زبان، ترجمهٔ ۳۱ زبان به انگلیسی و برعکس، تشخیص گوینده در ۱۳ زبان، زمانبندی تکتک کلمهها و جواب دادن به سؤال دربارهٔ فایل صوتی.
محدودیت اصلی: فقط با فایل ضبطشده کار میکند، نه پخش زنده یا تماس در لحظه.
هزینه: خود مدل رایگان است و روی Hugging Face و ModelScope قابل دانلود است؛ مجوز آن استفادهٔ تجاری را هم مجاز میداند.
فارسی: پشتیبانی نمیشود؛ عربی و ترکی در فهرست هستند.
اول یک مقدمهٔ ساده: تبدیل گفتار به متن یعنی چه؟
وقتی پیام صوتیتان در یک اپ خودبهخود به نوشته تبدیل میشود، یا زیرنویس خودکار یک ویدیو را میبینید، پشت آن سیستمی به اسم «تشخیص خودکار گفتار» کار میکند. در دنیای فنی به آن ASR میگویند، کوتاهشدهٔ Automatic Speech Recognition. کار این سیستمها این است که صدا را گوش کنند و بنویسند چه گفته شده.
مشکل اینجاست که «متن درست» برای همه یکی نیست. یک وکیل میخواهد همهٔ «اِ» و «اُم»ها و تکرارها هم ثبت شود. یک خبرنگار متن تمیز و خوانا میخواهد. یک پزشک میخواهد اسم داروها درست نوشته شود. مدلهای قدیمیتر معمولاً فقط یک سبک نوشتن بلد بودند. ایدهٔ اصلی مدل تازهٔ انویدیا این است که شما با یک جملهٔ ساده به آن بگویید چه نوع متنی میخواهید.
«مدل وزنباز» یعنی چه؟
وقتی میگوییم مدلی وزنباز (Open-Weight) است، یعنی خود فایلهای مدل منتشر شده و هر کسی میتواند آن را دانلود کند و روی سرور یا کامپیوتر خودش اجرا کند. فرقش با سرویسهایی مثل ChatGPT این است که لازم نیست صدایتان را برای شرکت دیگری بفرستید. برای بیمارستانها، شرکتها و هر جایی که حریم خصوصی مهم است، این تفاوت بزرگی است.
تشخیص گوینده دیگر چیست؟
فرض کنید جلسهای چهارنفره را ضبط کردهاید. اگر متن فقط پشت سر هم نوشته شود، نمیفهمید کدام جمله را چه کسی گفته است. «تشخیص گوینده» یا دیاریزیشن (Diarization) یعنی مدل کنار هر بخش از متن بنویسد «گویندهٔ ۱»، «گویندهٔ ۲» و غیره. این مدل اسم واقعی آدمها را نمیداند؛ فقط صداها را از هم جدا میکند.
Nemotron 3.5 Transcribe دقیقاً چه کارهایی میکند؟
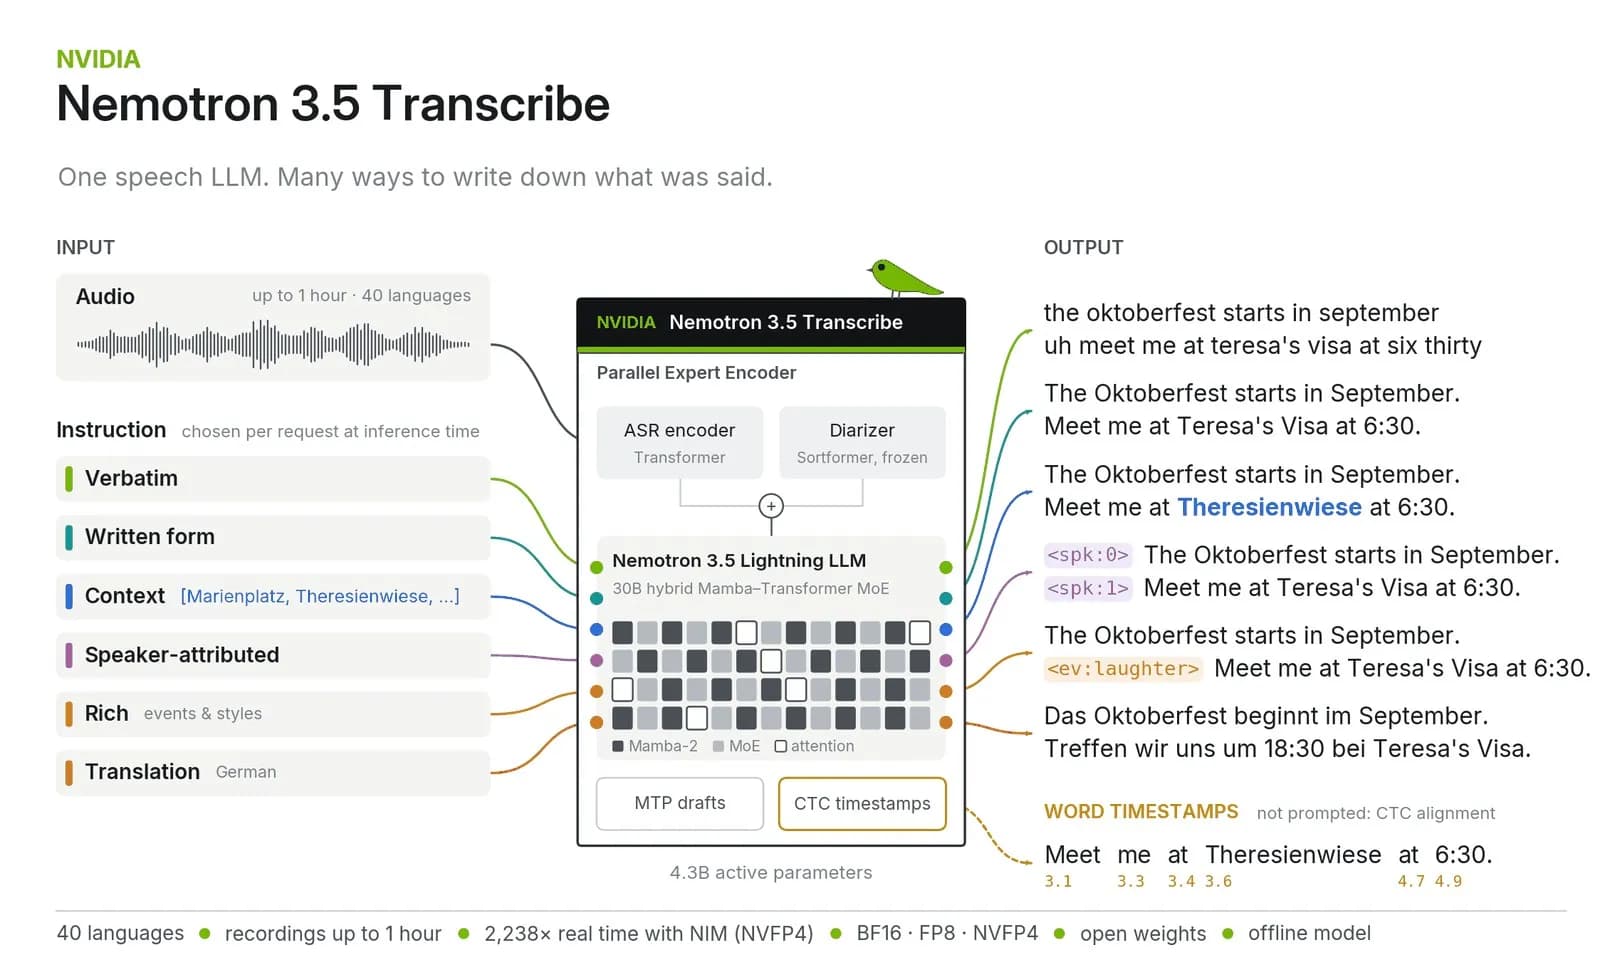
انویدیا چند کار مختلف را در یک مدل جمع کرده است. قبلاً برای هر کدام از این کارها معمولاً یک ابزار جدا لازم بود و باید آنها را پشت هم سوار میکردید.
متن کلمهبهکلمه یا متن تمیز
میتوانید بخواهید همهچیز، حتی مکثها و تکرارها، دقیقاً همانطور که گفته شده نوشته شود. یا بخواهید متن مرتب و خوانا باشد و مثلاً عددها به شکل رقم نوشته شوند، نه با حروف.
تشخیص اینکه چه کسی چه گفت
مدل میتواند تا هشت گوینده را در یک فایل از هم جدا کند. انویدیا میگوید این کار حتی وقتی آدمها وسط حرف هم میپرند و صداها روی هم میافتد هم خوب انجام میشود. این قابلیت فعلاً در ۱۳ زبان، از جمله انگلیسی، آلمانی، فرانسوی، روسی، هندی و عربی، در دسترس است.
ترجمه
مدل میتواند صدای ۳۱ زبان را مستقیم به متن انگلیسی ترجمه کند یا برعکس. یعنی لازم نیست اول متن را پیاده کنید و بعد سراغ مترجم بروید.
سؤال پرسیدن از فایل صوتی
میتوانید بپرسید «در این جلسه چه تصمیمهایی گرفته شد؟» و مدل جواب بدهد. اما انویدیا خودش تأکید کرده که این بخش فقط به زبان انگلیسی آموزش و آزمایش شده و در زبانهای دیگر ممکن است قابلاعتماد نباشد.
زمان دقیق هر کلمه
مدل میتواند کنار هر کلمه بنویسد در چه ثانیهای گفته شده است. این برای ساخت زیرنویس یا پیدا کردن یک جملهٔ خاص در یک ضبط طولانی خیلی کاربردی است. شرکت Agora، که بستر تماس صوتی و تصویری میسازد، از همین قابلیت برای نشان دادن متن یک کلاس ضبطشده کنار ویدیوی آن استفاده کرده است.
دستور دادن به زبان ساده؛ نقطهٔ قوت اصلی
چیزی که این مدل را از بیشتر ابزارهای قبلی جدا میکند این است که پشتش یک مدل زبانی بزرگ نشسته است؛ همان نوع فناوری که چتباتها را میسازد. به همین خاطر میشود با جملههای معمولی به آن گفت چه میخواهید. نمونههایی که انویدیا آورده اینهاست:
«این فایل را پیاده کن و کنار هر جمله بنویس چه کسی گفته.»
«این صدا را به انگلیسی ترجمه کن.»
«در این جلسه چه تصمیمهایی گرفته شد؟»
کمک به نوشتن درست اسمها و اصطلاحات
یکی از دردسرهای همیشگی ابزارهای تبدیل صدا به متن، اسمهای خاص و اصطلاحات تخصصی است. در این مدل میتوانید همراه فایل صوتی فهرستی از کلمههای احتمالی بدهید؛ مثلاً اسم چند دارو یا اسم چند خیابان. انویدیا میگوید با دادن چنین فهرستی، خطای مدل در نوشتن اسمهای خاص در آزمون ContextASR-Bench تا شش برابر کم شده است. خود انویدیا هم توصیه کرده بگویید «این کلمهها را فقط وقتی استفاده کن که واقعاً در صدا شنیده میشوند» تا مدل الکی آنها را وارد متن نکند.
عددها چه میگویند؟
انویدیا چند نتیجه از جدولهای رتبهبندی عمومی منتشر کرده است. معیار اصلی در بیشتر آنها نرخ خطای کلمه است.
نرخ خطای کلمه (WER) را چطور بخوانیم؟
WER یعنی از هر صد کلمه، چند کلمه اشتباه نوشته، جا افتاده یا اضافه شده است. پس هر چه این عدد پایینتر باشد، مدل دقیقتر است. مثلاً WER حدود ۵ درصد یعنی تقریباً از هر بیست کلمه یکی اشتباه است.
آزمون | نتیجهٔ Nemotron 3.5 Transcribe | بهترین رقیب وزنباز (به گفتهٔ انویدیا) |
|---|---|---|
انگلیسی، ۹ مجموعهٔ عمومی Open ASR | میانگین خطای ۴٫۷۱ درصد | Qwen3-ASR-1.7B با ۴٫۹۴ درصد |
چندزبانه، ۷ زبان | ۴٫۶۲ درصد | Qwen3-ASR-1.7B با ۶٫۴۹ درصد |
فایلهای طولانی | ۱۰٫۹۸ درصد | Parakeet-TDT-0.6B-v3 با ۱۳٫۳۷ درصد |
تشخیص گوینده در ۲۱ زبان (David AI) | خطای ۱۸٫۲۶ درصد؛ کمترین بین ۱۴ سیستم | Nemotron 3 Diarization خود انویدیا با ۱۸٫۳۸ درصد |
شاخص Artificial Analysis | ۲٫۸ درصد؛ همرتبهٔ اول بین مدلهای وزنباز | مدلی با حدود ۲۴ میلیارد پارامتر فعال در برابر حدود ۴ میلیارد این مدل |
این عددها را باید با کمی احتیاط خواند. بیشترشان را خود انویدیا گزارش کرده و تقریباً همه روی زبانهای اروپایی، انگلیسی و چند زبان بزرگ آسیایی گرفته شدهاند. اینکه مدل روی صدای شلوغ و لهجههای محلی شما چطور کار میکند را فقط با آزمایش خودتان میشود فهمید.
مشخصات فنی به زبان ساده
اسم کامل مدل NVIDIA-Nemotron-3.5-Transcribe-30B-A4B است. عدد 30B یعنی مغز زبانی آن حدود ۳۰ میلیارد پارامتر دارد (پارامترها را میشود مثل پیچهای تنظیمی تصور کرد که مدل در آموزش یاد میگیرد). A4B یعنی در هر لحظه فقط حدود ۴ میلیارد از آنها واقعاً کار میکنند.
چرا فقط بخشی از مدل روشن است؟
این مدل از روشی به اسم «ترکیب متخصصها» یا MoE استفاده میکند. مدل از بخشهای کوچکتری ساخته شده و برای هر تکه از کار فقط چند بخش مناسب فعال میشوند. نتیجه این است که مدل بزرگ است و چیزهای زیادی بلد است، اما مثل یک مدل کوچک سریع و کمهزینه اجرا میشود. انویدیا در این مدل دو نوع ساختار به نام Mamba و Transformer را هم با هم ترکیب کرده تا کار با ورودیهای طولانی سبکتر شود.
ویژگی | مقدار |
|---|---|
کل پارامترها | حدود ۳۴ میلیارد با رمزگذار صوتی؛ حدود ۴٫۳ میلیارد فعال |
مدل زبانی پایه | Nemotron 3.5 Lightning 30B-A3B |
بیشترین طول فایل | یک ساعت |
تعداد گویندهها | تا ۸ نفر |
فرمتهای صوتی | wav، flac، mp3، ogg |
نسخهها | BF16، FP8 و NVFP4 (نسخههای فشردهتر برای حافظهٔ کمتر) |
سختافزار مرجع | یک کارت H100 با ۸۰ گیگابایت حافظه |
مجوز | OpenMDW-1.1؛ استفادهٔ تجاری و غیرتجاری مجاز |
سرعتش چقدر است؟
انویدیا میگوید در آزمایشهایش، نسخهٔ فشردهٔ NVFP4 روی یک کارت RTX PRO 6000 Blackwell حدود صد ساعت صدا را در کمتر از سه دقیقه پیاده کرده است. این آزمایش با تکههای ۳۰ ثانیهای و تعداد زیادی درخواست همزمان انجام شده، پس برای یک فایل تکی چنین سرعتی را انتظار نداشته باشید.
فارسی را پشتیبانی میکند؟
نه. در جدول زبانهایی که انویدیا روی صفحهٔ مدل منتشر کرده، فارسی وجود ندارد. انویدیا زبانها را در سه سطح دستهبندی کرده است:
سطح پیشرو: زبانهایی مثل انگلیسی، آلمانی، فرانسوی، اسپانیایی، روسی، هندی، کرهای و ایتالیایی که بهترین کیفیت را دارند.
آمادهٔ استفادهٔ جدی: زبانهایی مثل ژاپنی، ترکی، اوکراینی، سوئدی و تایلندی.
پشتیبانیشده: زبانهایی مثل عربی، چینی، عبری، اندونزیایی و ویتنامی که به گفتهٔ انویدیا ممکن است برای کیفیت خوب به آموزش بیشتر نیاز داشته باشند.
پس برای کاربر ایرانی چه فایدهای دارد؟
اگر با فایلهای انگلیسی، آلمانی، ترکی یا عربی سروکار دارید، مثلاً برای درس، کار یا مهاجرت، این مدل میتواند مفید باشد. برنامهنویسها هم با ابزارهای آموزشی که انویدیا منتشر کرده، در اصل میتوانند مدل را برای زبان تازه آموزش بدهند؛ انویدیا راهنمای «اضافه کردن زبان جدید» را هم جزو آموزشهایش آورده است. اما این کار به داده و سختافزار جدی نیاز دارد و برای کاربر معمولی نیست. برای پیاده کردن فایل فارسی، فعلاً راه سادهتر سرویسهایی است که در مطلب آموزش تبدیل فایل صوتی به متن با ChatGPT توضیح دادهایم.
Granary v2؛ دادهای که پشت این مدل است
انویدیا همراه مدل، نسخهٔ دوم مجموعهدادهٔ صوتی Granary را هم منتشر کرده است. این مجموعه فهرست ۴۶۳ هزار و ۶۲ ساعت صدا در ۴۸ زبان را از ۱۶ منبع مختلف در بر میگیرد؛ نسخهٔ اول فقط ۲۵ زبان داشت. برای هر فایل سه نوع متن آماده شده است: متن کلمهبهکلمه با عددهای حروفی، متن با عددهای رقمی همراه مکثها، و متن تمیز بدون مکث و تکرار.
یک نمونهٔ واقعی: پیاده کردن حرف پزشکان
انویدیا برای نشان دادن ارزش شخصیسازی، مدل را روی مجموعهای از صدای پزشکان و دانشجویان پزشکی هندی آزمایش کرده است. نتیجه جالب است:
مدل بدون هیچ تنظیمی حدود ۳۰٫۸ درصد خطا داشت.
فقط با نوشتن یک دستور بهتر (گفتن زبان و نوع خط)، خطا به ۲۳٫۸ درصد رسید.
بعد از آموزش تکمیلی با دادههای پزشکی، خطا به ۱۱٫۸ درصد رسید.
روی گویندههایی که مدل اصلاً صدایشان را در آموزش نشنیده بود، خطا از ۲۲٫۴۴ به ۱۲٫۱۷ درصد رسید؛ یعنی حدود ۴۶ درصد کمتر. به گفتهٔ انویدیا کل این آموزش حدود ۱۴ ساعت کار روی یک کارت GB300 طول کشیده است.
چطور میشود امتحانش کرد؟
برای کنجکاوها
سادهترین راه، نسخهٔ نمایشی مدل روی سایت Hugging Face است که با اسم Nemotron Transcribe در دسترس است. یک فایل کوتاه انگلیسی یا با یکی از زبانهای فهرست آپلود کنید و نتیجه را ببینید. نسخهٔ نمایشی در ModelScope هم وجود دارد.
برای برنامهنویسها
دانلود مدل از Hugging Face یا ModelScope و اجرا با ابزارهای vLLM یا SGLang-Omni که از روز اول پشتیبانی میکنند.
اگر سرور و کارت گرافیک قوی ندارید، میتوانید از سرویسهای میزبانی مثل Baseten، DeepInfra یا Simplismart استفاده کنید.
انویدیا میگوید اجرای محلی روی کامپیوترهایی مثل DGX Spark یا Jetson AGX Thor با ابزار NeMo-Speech.cpp بهزودی کامل میشود.
اگر با مدلهای قبلی انویدیا آشنا نیستید، مطلب نموترون ۳.۵ بولت انویدیا چیست؟ را ببینید؛ آن مدل از همان خانوادهٔ Nemotron 3.5 است، اما برای کارهای ایجنتی ساخته شده است.
جایگاه این مدل در رقابت هوش مصنوعی صوتی
به نوشتهٔ TechCrunch، این مدل در شلوغترین روزهای رقابت هوش مصنوعی صوتی آمده است. همین ماه میسترال Voxtral 3 را معرفی کرد، ElevenLabs هم Eleven Realtime را برای ایجنتهای صوتی همزمان عرضه کرد و Salesforce هم مدل صوتی خودش را منتشر کرده است.
فرق انویدیا این است که مدلش را رایگان و قابل دانلود منتشر کرده و روی کارهای «پس از ضبط» تمرکز دارد: جلسه، کلاس، مصاحبه، تماسهای مرکز پشتیبانی و یادداشتهای پزشکی. انویدیا پیشتر هم مدل کوچک Parakeet را برای همین کار داشت؛ مدل تازه بزرگتر است و کارهای بیشتری را یکجا انجام میدهد. البته انتشار مدلهای رایگان برای انویدیا یک حساب تجاری هم دارد: هر چه مدلهای بیشتری روی کارتهای گرافیک این شرکت اجرا شوند، تقاضا برای سختافزارش بیشتر میشود.
محدودیتها و نکتههایی که باید در نظر داشت
زنده کار نمیکند: برای زیرنویس همزمان یا دستیار صوتی در لحظه ساخته نشده است.
سختافزار سنگین: نسخهٔ کامل برای اجرا به کارتهای گرافیک حرفهای انویدیا نیاز دارد و روی لپتاپ معمولی بالا نمیآید.
بدون فارسی: فارسی، اردو و بسیاری از زبانهای منطقه در فهرست نیستند.
سؤال و جواب فقط انگلیسی: پرسیدن سؤال دربارهٔ محتوای فایل فقط در انگلیسی آزمایش شده است.
گوینده یعنی صدا، نه هویت: برچسب «گویندهٔ ۱» به معنی شناختن آن آدم نیست.
بازبینی لازم است: خود انویدیا توصیه میکند اسمها، تغییر گویندهها و جوابها را با فایل اصلی چک کنید.
این خبر برای ما چه معنایی دارد؟
برای کاربر عادی فارسیزبان، فعلاً تغییر بزرگی در کار نیست، چون زبان ما پشتیبانی نمیشود. اما جهت حرکت روشن است: ابزارهای تبدیل صدا به متن دارند هوشمندتر میشوند و بهجای یک متن خام، صورتجلسه با اسم گوینده، ترجمه و خلاصه تحویل میدهند. وقتی چنین مدلهایی رایگان و قابل دانلود منتشر میشوند، استارتاپها و برنامهنویسها، از جمله برنامهنویسهای ایرانی، راحتتر میتوانند نسخهٔ بومیشده بسازند؛ به شرط اینکه دادهٔ صوتی فارسی کافی و باکیفیت در دسترس باشد.
سؤالهای پرتکرار
Nemotron 3.5 Transcribe چیست؟
مدل رایگان و وزنباز انویدیا برای تبدیل فایل صوتی به متن است که ۲۸ اکتبر ۲۰۲۶ منتشر شد و ۴۰ زبان، تشخیص گوینده، ترجمه و زمانبندی کلمهها را پشتیبانی میکند.
آیا از زبان فارسی پشتیبانی میکند؟
نه. فارسی در فهرست ۴۰ زبان رسمی این مدل نیست. عربی و ترکی در فهرست هستند.
استفاده از آن رایگان است؟
خود مدل رایگان است و با مجوز OpenMDW-1.1 برای استفادهٔ تجاری و غیرتجاری منتشر شده است. اما برای اجرا به سختافزار قوی نیاز دارید یا باید هزینهٔ سرویسهای میزبانی را بپردازید.
میشود با آن جلسهٔ زنده یا تماس تلفنی را همزمان پیاده کرد؟
نه. این مدل فقط برای فایلهای ضبطشده ساخته شده و به گفتهٔ انویدیا سرویس پخش زنده نیست.
حداکثر طول فایل و تعداد گوینده چقدر است؟
فایل تا یک ساعت و تا هشت گوینده. تشخیص گوینده فعلاً در ۱۳ زبان کار میکند.
با Whisper یا سرویسهای دیگر چه فرقی دارد؟
تفاوت اصلی این است که میشود با جملههای معمولی به آن گفت چه نوع متنی میخواهید و چند کار، مثل تشخیص گوینده و ترجمه، را یکجا انجام میدهد. انویدیا میگوید در جدول Open ASR بهترین نتیجه را بین مدلهای وزنباز گرفته، اما مقایسه با هر ابزار مشخص را باید روی فایلهای خودتان آزمایش کنید.
Granary v2 چیست؟
مجموعهدادهٔ صوتی باز انویدیا با فهرست بیش از ۴۶۳ هزار ساعت صدا در ۴۸ زبان است که برای آموزش و شخصیسازی مدلهای گفتار به متن منتشر شده است.
منابع
NVIDIA Nemotron 3.5 Transcribe and Granary v2: Intelligent Multilingual Transcription You Can Prompt and Adapt؛ وبلاگ انویدیا در Hugging Face، ۲۸ اکتبر ۲۰۲۶
NVIDIA-Nemotron-3.5-Transcribe-30B-A4B؛ صفحهٔ رسمی مدل در Hugging Face
NVIDIA Nemotron 3.5 Transcribe: Intelligent Transcription with a Speech LLM؛ بخش پژوهش انویدیا، ۲۸ اکتبر ۲۰۲۶
Voice AI in vogue: Nvidia releases new open transcription model؛ TechCrunch، ۲۸ اکتبر ۲۰۲۶


