فهرست مطالب
انویدیا ابزار PAIR — مخفف Personal AI Router یا «روتر هوش مصنوعی شخصی» — را رسماً از مرحلهٔ بتا خارج کرد؛ ابزار رایگان و متنبازی که کارهای هوش مصنوعی را بین کامپیوترهای سازگار روی یک شبکهٔ محلی پخش میکند، بهجای اینکه همهچیز روی یک دستگاه انباشته شود.
اگر در خانه یا محل کار چند کامپیوتر دارید و با مدلهای زبانیِ روی دستگاهِ خودتان کار میکنید، PAIR دقیقاً همان قطعهٔ گمشدهای است که احتمالاً کم داشتید. در این مطلب میبینید این ابزار دقیقاً چه کاری میکند، نسخهٔ نهاییاش نسبت به بتا چه چیزهایی اضافه کرده، در چند قدم چطور راهش میاندازید — و مهمتر از همه، یک سوءتفاهم بزرگ را از همین اول کنار میزنیم: PAIR حافظهٔ گرافیکی دستگاههای شما را «جمع» نمیکند.
پاسخ کوتاه
انویدیا ۱۳ اکتبر ۲۰۲۶ (۲۱ مهر) در وبلاگ رسمیاش اعلام کرد PAIR از بتا خارج شده؛ سه روز مانده به عرضهٔ لپتاپهای RTX Spark در ۱۶ اکتبر.
PAIR درخواستهای استنباط (inference — یعنی همان اجرای مدل و گرفتن پاسخ) را بین کامپیوترهای یک شبکهٔ محلی توزیع میکند؛ رایگان و متنباز با لایسنس Apache 2.0.
نسخهٔ نهایی چهار چیز تازه دارد: پشتیبانی از llama.cpp، دانلود مستقیم مدل از هاگینگفیس، تنظیمات دلخواه برای موتور استنباط و سازگاری با RTX Spark.
روی ویندوز، لینوکس و مک کار میکند و با سه موتور Ollama، LM Studio و llama.cpp جفت میشود؛ برنامههای شما از همان اندپوینتهای آشنای Ollama و OpenAI استفاده میکنند.
نکتهٔ کلیدی: هر درخواستِ کامل روی یک دستگاه اجرا میشود. قدرت PAIR در پخشِ درخواستهای «موازی» است، نه بزرگتر کردن یک مدل.
اول یک توضیح ساده: روتر استنباط محلی چیست؟
مشکل: یک کارت گرافیک، چند کار همزمان
اجرای مدل زبانی روی کامپیوتر خودتان این روزها دیگر کار عجیبی نیست؛ با Ollama یا LM Studio خیلیها یک مدل را دانلود کردهاند و آفلاین با آن چت میکنند. دردسر از جایی شروع میشود که «ایجنت»ها وارد ماجرا میشوند: یک ایجنت ممکن است همزمان چند کار بکند — یکی متن خلاصه کند، یکی دیگر کد بنویسد، سومی در پسزمینه وب بگردد. روی یک کارت گرافیک، این کارها صف میکشند و همهچیز کند میشود؛ در حالی که کامپیوتر کناریتان شاید همان لحظه بیکار نشسته باشد.
راهحل انویدیا: پخش درخواست، نه تجمیع حافظه
PAIR را مثل یک «مسئول توزیع کار» در یک دفتر تصور کنید. وقتی درخواستی میرسد، نگاه میکند کدام کامپیوتر موتور مناسب را دارد، کدامیک مدلِ درخواستی را از قبل بار کرده و کدامیک الان خلوتتر است — بعد آن درخواست را به همان دستگاه میسپارد. برنامهٔ شما همچنان با همان آدرس آشنای localhost حرف میزند و اصلاً لازم نیست بداند پشت صحنه چند دستگاه در کارند.
خبر اصلی: PAIR از بتا بیرون آمد
اعلام ۲۱ مهر، درست سه روز مانده به RTX Spark
انویدیا خبر خروج از بتا را در پستی با عنوان «همهچیز آماده است» منتشر کرد؛ پستی که کل اکوسیستم نرمافزاریِ لپتاپهای RTX Spark را معرفی میکند. این لپتاپها ۱۶ اکتبر (۲۴ مهر) عرضه میشوند و انویدیا هفتهٔ منتهی به عرضه را به نرمافزار اختصاص داده: از بهروزرسانی اپهای ایجنت (GitHub Copilot، Hermes، OpenClaw، Perplexity، Pi و WorkBuddy) تا مدل جدید Nemotron 3.5 Bolt که فردا، ۱۵ اکتبر، منتشر میشود. PAIR هم یکی از مهرههای همین پازل است.
جالب است بدانید PAIR اولین بار در نمایشگاه IFA 2026 (شهریور امسال) بهصورت بتا معرفی شده بود؛ یعنی فقط حدود یک ماه طول کشید تا به نسخهٔ نهایی برسد.
چهار چیز تازه در نسخهٔ نهایی
به گفتهٔ انویدیا، نسخهٔ رسمی اینها را اضافه میکند:
پشتیبانی از llama.cpp: موتور سبک و محبوب اجرای مدلها که حالا در کنار Ollama و LM Studio، سومین موتور رسمی PAIR است.
دانلود مستقیم مدل از هاگینگفیس: از داخل خود برنامه میتوانید مدلها را پیدا و دانلود کنید؛ برای llama.cpp فهرست از مخزنهای محبوب GGUF پر میشود.
تنظیمات دلخواه موتور استنباط: پورتها و دستور اجرای موتور را میتوانید خودتان تنظیم کنید.
سازگاری با RTX Spark: لپتاپهای جدید انویدیا از روز اول با PAIR کار میکنند.
انویدیا همچنین از «بهبودهای متنوع در استنباط و تجربهٔ کاربری» حرف میزند، بدون اینکه جزئیات بیشتری بدهد.
متنباز واقعی: بیش از ۱۰ مشارکت جامعه در یک ماه
PAIR فقط «رایگان» نیست؛ کدش با لایسنس Apache 2.0 روی گیتهاب باز است و هر کسی میتواند بخواندش، تغییرش دهد و در تجاریسازیاش هم محدودیتی ندارد. انویدیا میگوید فقط در یک ماهِ بعد از انتشار اولیه، جامعهٔ توسعهدهندگان بیش از ۱۰ قابلیت و اصلاح به پروژه اضافه کرده است. مخزن گیتهاب در زمان نگارش این مطلب حدود ۱۶۰۰ ستاره دارد — برای پروژهای سهماهه عدد بدی نیست.
راستی: انویدیا برای PAIR یک سرور MCP هم منتشر کرده؛ یعنی ایجنتهای محلی میتوانند مستقیماً با خودِ PAIR حرف بزنند و آن را کنترل کنند.
PAIR دقیقاً چطور کار میکند؟
اندپوینتهای آشنا: Ollama، OpenAI و Anthropic
یکی از هوشمندانهترین تصمیمهای طراحی PAIR این است که برنامهٔ شما اصلاً لازم نیست بداند PAIR وجود دارد. این ابزار روی دستگاه شما یک پروکسی محلی بالا میآورد که با همان پروتکلهای آشنای Ollama و OpenAI — و حتی API پیامهای Anthropic — جواب میدهد. یعنی ابزاری که امروز با Ollama کار میکند، فردا بدون تغییر کد میتواند پشت PAIR بنشیند و از چند دستگاه استفاده کند.
یک درخواست، یک دستگاه — این را جدی بگیرید
مستندات رسمی گیتهاب با خط درشت هشدار میدهد: PAIR حافظهٔ گرافیکی را بین دستگاهها جمع نمیکند، چند GPU را به یک GPU بزرگتر تبدیل نمیکند، مدل را بین ماشینها تکهتکه نمیکند و یک درخواستِ در حال اجرا را نصف نمیکند. واحد کار، «یک درخواستِ مستقلِ کامل» است. چهار کامپیوتر با گرافیک ۱۶ گیگابایتی، یک گرافیک ۶۴ گیگابایتی نمیشوند. اگر مدلی از حافظهٔ بزرگترین دستگاه شما بزرگتر باشد، PAIR هم نمیتواند اجرایش کند. قدرت واقعیاش وقتی معلوم میشود که چند درخواستِ مستقل — مثلاً چند ایجنت موازی — برای منابع رقابت میکنند.
جفتسازی با پین ششرقمی
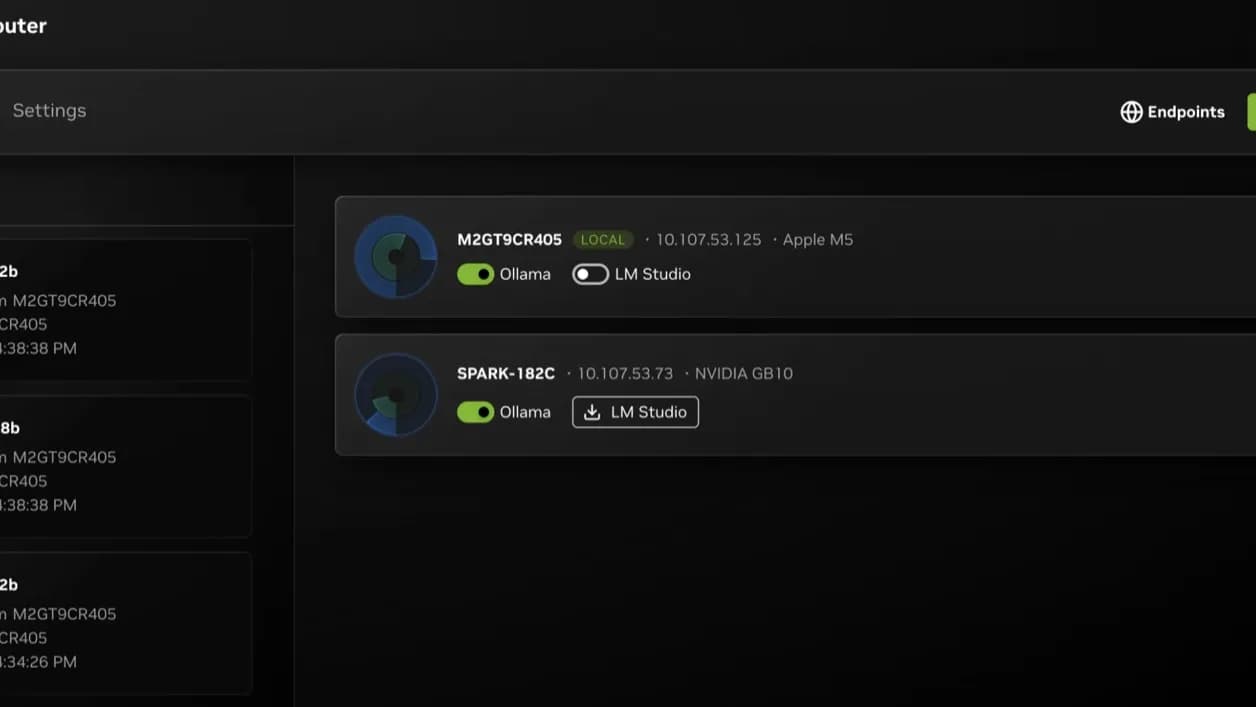
فرایند اتصال دستگاهها عمداً ساده طراحی شده: PAIR را روی هر دستگاه نصب میکنید، از مسیر Settings و سپس Cluster دستگاه دوم را دعوت میکنید؛ دستگاه دعوتکننده یک پین ششرقمی نشان میدهد و همان را روی دستگاه مهمان وارد میکنید. تمام شد — دستگاهها همدیگر را در شبکهٔ محلی پیدا میکنند (به گفتهٔ تِکتایمز با مکانیزم mDNS) و ارتباط بینشان با رمزنگاری متقابل (mTLS) امن میشود. به گفتهٔ همین منبع، انویدیا این معماری را تا ۱۸ دستگاه تست کرده است.
چه دستگاههایی؟ صادقانه بگوییم
انویدیا از «کامپیوترهای سازگار» حرف میزند و خودش روی ویندوز ۱۱، لینوکس و مک (هم x64 هم arm64) نصب میشود؛ نسخهٔ ویندوز روی ARM هنوز آزمایشی است. اما نکتهٔ مهمی که مستندات رسمی هم تأکید میکند: اینکه PAIR روی دستگاهی نصب شود، به معنیِ کارکردنِ موتور روی آن دستگاه نیست. هر موتور نیازمندیهای خودش را برای سیستمعامل، GPU و درایور دارد و هر مدل هم به حافظهٔ کافی برای بار شدن نیاز دارد؛ پس قبل از اینکه فرض کنید دستگاه قدیمیتان میتواند مدلی را سرو کند، مستندات همان موتور را چک کنید. به گفتهٔ تِکتایمز، فهرست پشتیبانی شامل کارتهای GeForce RTX سری ۲۰ به بعد، کارتهای RTX PRO، دستگاه DGX Spark و سیلیکون M4 اپل میشود — ولی این ادعای همان رسانه است و سند رسمیِ انویدیا کلیتر حرف میزند.
چطور شروع کنی: از صفر تا اولین درخواست
مسیر پیشنهادیِ خودِ انویدیا با اپ دسکتاپ است؛ رابط ترمینالی هم برای دستگاههای بدون محیط گرافیکی وجود دارد:
قدم اول — دانلود: از صفحهٔ انتشارهای مخزن گیتهاب، نصاب مناسب سیستمعاملتان را بگیرید: فایل exe برای ویندوز، deb برای لینوکس و dmg برای مک. نصاب امضاشده، سرویسهای پسزمینه و قوانین فایروال لازم را خودش تنظیم میکند.
قدم دوم — نصب موتور: برنامه را باز کنید، روی کارت دستگاهتان وارد «تنظیمات موتور» شوید و کنار Ollama، LM Studio یا llama.cpp دکمهٔ Install را بزنید. PAIR خودش موتور را دانلود و آماده میکند؛ لازم نیست از قبل چیزی نصب کرده باشید.
قدم سوم — افزودن مدل: با دکمهٔ Add model مدل دلخواهتان را دانلود کنید. در مثال مستندات از qwen4:12b استفاده شده؛ برای llama.cpp فهرست از مخزنهای محبوب هاگینگفیس میآید (مثل ggml-org/gemma-3-1b-it-GGUF).
قدم چهارم — تست: راحتترین راه دکمهٔ Test در مسیر Settings و سپس Service است که یک دقیقه ترافیک استنباط واقعی از همین مسیر عبور میدهد تا بتوانید کارها را زنده تماشا کنید. راه دوم، همان دستور آشنای curl http://127.0.0.1:11434/v1/chat/completions است.
قدم پنجم — جفتکردن دستگاه دوم: مراحل موتور و مدل را روی دستگاه دوم تکرار کنید و از Settings و سپس Cluster آن را دعوت کنید. از اینجا به بعد، درخواستها بین دستگاهها توزیع میشوند.
اگر قبلاً با نصب و اجرای Ollama آشنا نیستید، آموزش نصب و اجرای مدل با Ollama نقطهٔ شروع خوبی است؛ چون PAIR عملاً روی دوش همین موتورها سوار میشود.
پلنها و قیمت: واقعاً رایگان است؟
بله — و این را با سند میگوییم، نه با حدس. PAIR تحت لایسنس Apache 2.0 منتشر شده: بدون اشتراک، بدون نسخهٔ پولی، بدون محدودیت تعداد دستگاه. تنها «هزینه»ای که میپردازید، برق و سختافزاری است که خودتان از قبل دارید. همین رایگانبودنِ واقعی، آن را از باکسهای «هاب هوش مصنوعی» پولی که بعضی شرکتها میفروشند جدا میکند. اگر دنبال مقایسه با خبر دیگرِ همین هفتهٔ انویدیا هستید، بد نیست بدانید انویدیا پلتفرم Run:ai را هم همین هفته متنباز کرد — ولی آن یکی برای دیتاسنترهاست و این یکی برای خانهٔ شما.
مقایسهٔ کوتاه با جایگزینها
جدول زیر PAIR را کنار نزدیکترین گزینهها میگذارد تا ببینید کجای نقشه ایستاده است:
| PAIR | Ollama ساده (تکدستگاه) | کتابخانهٔ Switchyard انویدیا | API ابری (مثل OpenAI) |
|---|---|---|---|---|
مدل کاری | روتر چنددستگاهی روی شبکهٔ محلی | اجرای مدل روی یک دستگاه | روتر بین مدل محلی و ابری، مخصوص ایجنتها | ارسال درخواست به سرور شرکت |
هزینه | رایگان (Apache 2.0) | رایگان | رایگان (کتابخانهٔ متنباز) | پرداخت بهازای توکن |
حریم خصوصی | داده روی شبکهٔ محلی میماند | کاملاً محلی | ترکیبی (بخشی محلی، بخشی ابری) | داده به ابر میرود |
بهترین برای | چند دستگاه و ایجنتهای موازی | یک کاربر، یک دستگاه | ایجنتهایی که بین محلی و ابری جابهجا میشوند | قدرتمندترین مدلها بدون سختافزار |
نقطهضعف اصلی | نیاز به چند دستگاه سازگار | تکگلوگاه برای کارهای موازی | بخشی از درخواستها همچنان ابری است | هزینهٔ مداوم و وابستگی به اینترنت |
جدول را اینطور بخوانید: PAIR رقیب API ابری نیست؛ رقیبِ «Ollama روی یک لپتاپِ تنها» است. اگر فقط گاهی با یک مدل چت میکنید، همان Ollama کافی است و PAIR چیزی به شما اضافه نمیکند.
محدودیتها — بدون تعارف
تجمیع حافظه در کار نیست: مهمترین محدودیت را دوباره میگوییم چون مهمترین سوءتفاهم هم هست. مدلِ بزرگتر از حافظهٔ یک دستگاه، با PAIR هم اجرا نمیشود.
زمانبند هنوز ساده است: به نوشتهٔ یک بررسی فنی در لینکدین، زمانبند فعلی نودها را عمدتاً بر اساس «صفِ کارِ» هر دستگاه رتبهبندی میکند، نه مدل دقیق GPU، حافظهٔ خالی یا تأخیر اندازهگیریشده؛ پس در مجموعهای از دستگاههای ناهمگون، همیشه بهترین انتخابِ ممکن را نمیکند.
تازه از بتا بیرون آمده: همهٔ ادعاهای این مطلب، ادعای خودِ انویدیاست؛ آزمون مستقل و تجربهٔ کاربریِ گسترده هنوز وجود ندارد. این را صراحتاً میگوییم چون «اینجا چیزی اختراع نمیکنیم».
فقط شبکهٔ محلی: دستگاهها باید روی یک شبکه باشند؛ این هم نقطهٔ قوت (حریم خصوصی) است و هم محدودیت (از بیرون خانه به دستگاههایتان دسترسی ندارید).
وابستگی به موتورها: اگر Ollama یا llama.cpp روی دستگاه خاصی مدل خاصی را اجرا نکند، PAIR هم معجزه نمیکند.
نکتهای برای خوانندهٔ فارسیزبان
بدون اشتراک و پرداخت ارزی: چون کل ماجرا روی دستگاههای خودتان میگذرد، از اساس صورتحسابی در کار نیست؛ برای خیلیها همین یک جمله کافی است.
دانلود مدلها اینترنت میخواهد: بعد از دانلود، اجرا کاملاً آفلاین است؛ ولی گرفتنِ خودِ مدلها از هاگینگفیس یا گیتهاب به اینترنت نیاز دارد و تابع شرایط همان سرویسهاست.
کیفیت فارسی به مدل بستگی دارد، نه به PAIR: خودِ روتر با زبان کاری ندارد؛ اگر مدلِ انتخابیتان فارسی را خوب نفهمد، مقصر PAIR نیست. موقع انتخاب مدل، سراغ مدلهایی بروید که چندزبانه بودنشان ثابت شده.
برای شروع لازم نیست RTX Spark بخرید: با همان دو کامپیوتری که دارید — به شرط سازگاری موتورها — میتوانید امروز امتحانش کنید. لپتاپهای جدید انویدیا که ۲۴ مهر عرضه میشوند، فقط یک گزینهٔ تازهاند نه پیششرط.
چیزهایی که هنوز روشن نیست
نقشهٔ راه رسمی: آیا انویدیا روزی سراغ تجمیع حافظه یا تکهتکهکردن مدل بین دستگاهها میرود؟ فعلاً هیچ نشانهای در مستندات نیست.
عمق یکپارچهسازی با RTX Spark دقیقاً چقدر است و چه قابلیتِ اختصاصیای برای این لپتاپها دارد؟
وضعیت پشتیبانی از ویندوز روی ARM چه زمانی از حالت آزمایشی خارج میشود؟
مدل Nemotron 3.5 Bolt که فردا منتشر میشود، از روز اول چقدر روان با PAIR کار میکند؟ (این را در پوشش فرداشب بررسی میکنیم.)
جمعبندی: امتحانش کن — اگر چند دستگاه داری
PAIR وعدهٔ عجیبی نمیدهد و دقیقاً به همین دلیل باورکردنی است: یک روترِ ساده، رایگان و متنباز که کارهای موازیِ هوش مصنوعی را بین کامپیوترهای خانهتان پخش میکند. اگر فقط یک دستگاه دارید، چیزی برای شما ندارد؛ اگر دو سه سیستم دارید و ایجنتها مدام GPU شما را قفل میکنند، دانلودش از گیتهاب و یک ربع وقت، ارزانترین آزمایشی است که این هفته میتوانید بکنید. فقط یادتان باشد: دنبال معجزهٔ «جمعکردن حافظهها» نباشید — آن کار را PAIR نمیکند و هیچوقت هم ادعایش را نکرده.
در همین اکوسیستم، بد نیست نگاهی هم به لایهٔ امنیتی OpenShell انویدیا برای ایجنتها بیندازید؛ چون وقتی ایجنتها روی چند دستگاه پخش میشوند، امنیتِ اجرای آنها هم به همان اندازه مهم میشود.
پرسشهای متداول
PAIR مخفف چیست؟
مخفف Personal AI Router به معنی «روتر هوش مصنوعی شخصی» است؛ بعد از نصب، در برنامه با نام NVIDIA PAIR دیده میشود.
آیا PAIR واقعاً رایگان است؟
بله. تحت لایسنس Apache 2.0 منتشر شده؛ بدون اشتراک، بدون نسخهٔ پولی و بدون محدودیت تعداد دستگاه. کد منبعش هم روی گیتهاب باز است.
میتوانم با PAIR یک مدل بزرگ را بین چند کارت گرافیک تقسیم کنم؟
نه. PAIR هر درخواستِ کامل را روی یک دستگاه اجرا میکند و حافظهٔ گرافیکی را تجمیع نمیکند؛ مدلی که در یک دستگاه جا نشود، با PAIR هم اجرا نمیشود.
برای شروع به چه چیزهایی نیاز دارم؟
دستکم یک کامپیوتر سازگار (ویندوز ۱۱، لینوکس یا مک)، نصب PAIR از صفحهٔ انتشارهای گیتهاب، یک موتور (Ollama، LM Studio یا llama.cpp) و یک مدل دانلودشده. برای استفادهٔ واقعی از روتر، دستگاه دوم را هم به همین ترتیب آماده و جفت کنید.
برنامههای فعلیام باید تغییر کنند؟
در بیشتر موارد نه. PAIR اندپوینتهای سازگار با Ollama و OpenAI (و حتی API پیامهای Anthropic) ارائه میدهد؛ پس ابزاری که امروز با Ollama کار میکند، معمولاً بدون تغییر کد پشت PAIR مینشیند.
آیا دادههای من به اینترنت ارسال میشود؟
به گفتهٔ انویدیا، وقتی همهچیز — برنامه، منبع مدل، موتور و دستگاهها — محلی باشد، پرامپتها و پاسخها روی شبکهٔ محلی میمانند. خودِ PAIR سرویس ابری نیست.
تفاوت PAIR با Switchyard انویدیا چیست؟
PAIR درخواستها را بین دستگاههای «محلی» شما پخش میکند؛ Switchyard کتابخانهای است که به ایجنت کمک میکند بین مدل محلی و مدل ابری جابهجا شود. یکی برای خانهٔ شماست، دیگری برای پلزدن به ابر.
از کجا بفهمم کدام دستگاه پاسخ داد؟
در بخش Jobs برنامه میبینید هر درخواست روی کدام نود اجرا شده و هر دستگاه مصرف زندهٔ GPU و حافظهاش را گزارش میدهد.
منابع
وبلاگ رسمی انویدیا: All Systems Go: Global PC App Ecosystem Ready for NVIDIA RTX Spark
مخزن رسمی گیتهاب: NVIDIA/Personal-AI-Router
تِکتایمز: NVIDIA RTX Spark Launches Friday: 74-Billion-Parameter AI Fits in 24GB Laptop
evermx: Nvidia PAIR Routes Local AI Across Your Idle Home PCs
بلاکچیننیوز: NVIDIA Announces Software Ecosystem Updates Ahead of RTX Spark Laptop Launch